Lec 10 动态规划:高级 DP(Dynamic Programming: Advanced DP)
TL;DR
- 区间 DP 拓扑序范式:从简单前缀/后缀状态空间跃迁至区间子问题 D(i,j),按区间长度 len=j−i+1 递增构造填表拓扑序。
- 最长回文子序列(LPS):利用端点字符匹配决策,在 O(n2) 状态内实现 O(1) 转移,完美规避暴力指数爆炸。
- 最优二叉搜索树(Optimal BST):在搜索期望深度最小化目标下,通过全区间权重和 W(i,j) 巧妙抵偿子树下沉增量深度,以 O(n3) 穷举根节点完成区间划分。
- 交替取硬币博弈(Minimax DP):奇偶下标和证明先手必胜策略的存在性,结合我方极大化收益与理性对手极小化留存的对抗递推,以 O(n2) 精确锁定博弈最优收益。
区间动态规划思维范式
在初阶动态规划中,子问题通常由单个前缀下标 i 决定(例如一维背包、最长上升子序列)。而在高级算法设计中,大量问题呈现出两端收缩或区间分裂的结构特征:
- 问题的子结构作用于闭区间 [i,j] 上;
- 状态转移依赖于该区间两端的单步选择,或枚举区间内部的分割点 k∈[i,j];
- 填表拓扑序不再能简单地按单向递增推进,而必须按照**区间长度(Span)**从小到大依次求解。
经典问题 1:最长回文子序列(LPS)
定义
回文子序列(Palindromic Subsequence)
给定字符串 X[1..n],回文字符串正向与反向拼读完全相同。求 X 中长度最大的回文子序列(注意:子序列不要求连续)。
例如:输入 character,最长回文子序列为 carac,长度为 5。
状态设计与转移方程
定义子问题 L(i,j) 为子串 X[i..j] 内的最长回文子序列长度(1≤i≤j≤n):
- 区间长度为 1(i=j):单个字符自身即为回文,递归基 L(i,i)=1;
- 两端字符匹配(X[i]=X[j]):
- 若 i+1=j,两个相同字符构成长度为 2 的回文,L(i,j)=2;
- 若 i+1<j,两端字符可同时纳入回文外壳,内部求解 X[i+1..j−1]:
L(i,j)=2+L(i+1,j−1)
- 两端字符不匹配(X[i]=X[j]):两端点不可能同时存在于同一个回文子序列中,决策退化为分别舍弃左端或右端,取二者较大值:
L(i,j)=max(L(i+1,j),L(i,j−1))
复杂度分析
- 子问题总数:所有满足 1≤i≤j≤n 的数对共有 (2n)+n=Θ(n2) 个;
- 单状态计算代价:仅需常数次比较与取最大值操作,耗时 O(1);
- 空间与时间复杂度:总时间为 Θ(n2),使用二维矩阵存储中间结果,空间复杂度为 Θ(n2)(使用滚动数组可压缩至 O(n))。
经典问题 2:最优二叉搜索树(Optimal BST)
给定包含 n 个互异有序键的序列 K1<K2<⋯<Kn。每个键 Ki 被检索的概率(或权重)为 pi>0,满足 ∑i=1npi=1。
构造一棵包含这 n 个键的二叉搜索树 T,使得在树中的期望查找代价最小化。
若键 Ki 在树中的深度为 depthT(Ki)(根节点深度设为 0,即访问根节点代价为 1 次比较),则目标函数为:
Minimize Cost(T)=i=1∑npi⋅(depthT(Ki)+1)
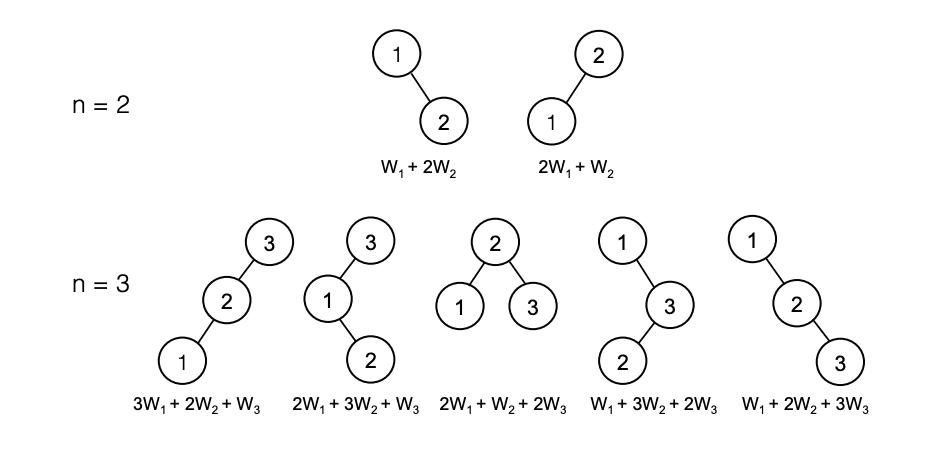
直觉上,高频词汇应当尽量靠近根节点以减少检索层数。
贪心策略的失效分析
能否贪心地选取当前权重最大的键 Kr 作为根节点?
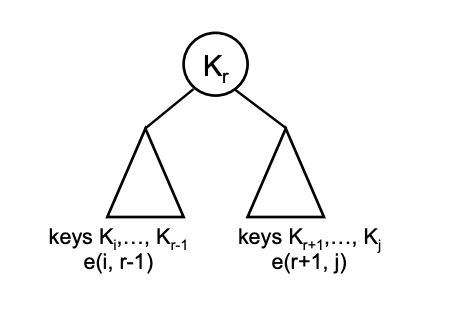
反例:考虑三个键,权重分别为 p1=0.45,p2=0.50,p3=0.05。
- 若贪心选择权重最大的 K2 为根,左子树为 K1,右子树为 K3,期望代价为 0.50×1+0.45×2+0.05×2=1.50;
- 若选择 K1 为根,K2 为右孩子,K3 为 K2 的右孩子,代价为 0.45×1+0.50×2+0.05×3=1.60;
- 但若有更极端的深层分布,贪心选择极高局部权值会导致其余众多中等权值键整体下沉,反例表明局部贪心无法兼顾全局树形平衡。
动态规划转移方程与增量深度累加
定义区间 [i,j] 的权值总和为:
W(i,j)=k=i∑jpk
设 e(i,j) 为由有序键子集 {Ki,Ki+1,…,Kj} 构成的最优二叉搜索树的最小期望代价。
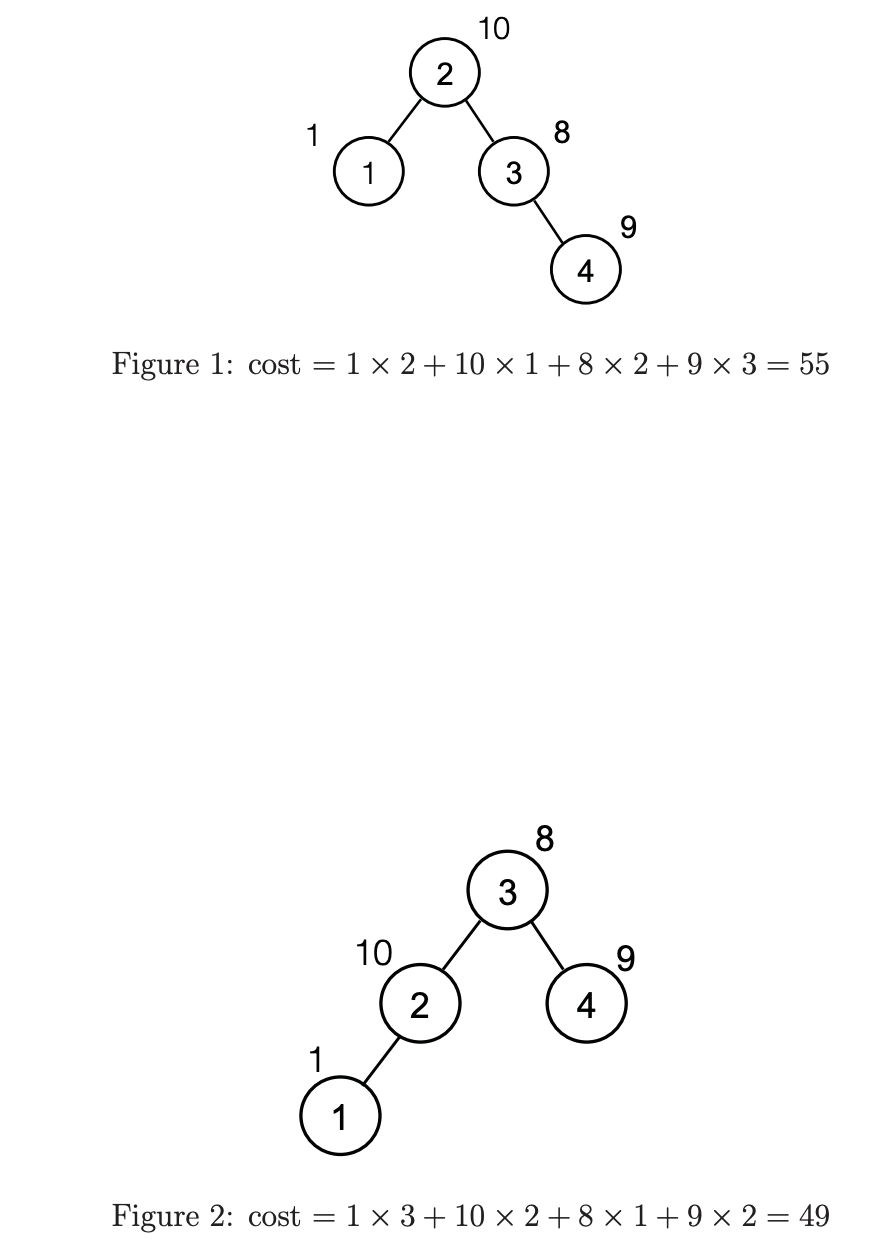
若在区间 [i,j] 中枚举选取 Kr(i≤r≤j)作为该子树的根节点:
- 左子树包含键集合 {Ki,…,Kr−1},其在局部最优树中的代价为 e(i,r−1);
- 右子树包含键集合 {Kr+1,…,Kj},其在局部最优树中的代价为 e(r+1,j);
- 当这两个子树挂载在根节点 Kr 之下时,子树中所有节点的深度相比其局部深度均增加了 1!
深度每增加 1,对应键 Kk 的期望代价增量正好增加 1×pk。因此所有左右子树节点带来的深度增量总和恰好等于:
k=i,k=r∑jpk
连同根节点自身贡献的代价 pr×1,全部节点贡献的总增量恰好等于全区间权重和 W(i,j)!
由此得到极为优雅的转移方程:
e(i,j)=⎩⎨⎧0pimini≤r≤j(e(i,r−1)+e(r+1,j))+W(i,j)(i>j)(i=j)(i<j)
复杂度分析
- 子问题个数:O(n2) 个区间;
- 每个状态需要枚举 r∈[i,j] 找到极小值,单状态转移耗时 O(n);
- 整体算法运行时间为 Θ(n2)×Θ(n)=Θ(n3)(注:利用 Knuth 优化四边形不等式性质,可将最优分割点单调性约束在 opt[i,j−1]≤opt[i,j]≤opt[i+1,j],进一步优化至 Θ(n2))。
经典问题 3:交替取硬币博弈(Minimax DP)
定义
交替取硬币游戏
在一排直线上有 n 枚硬币,其面值依次为 V1,V2,…,Vn(其中 n 为偶数)。
两位超级理性的玩家交替轮流行动。在每一轮中,当前玩家可以从该行的最左端或最右端取走一枚硬币,并获得该硬币对应的面值。所有硬币取完时,总面值较高者获胜。
先手必胜的存在性:奇偶染色策略
定理
在交替取硬币游戏中,先手玩家至少能保证获得总价值的一半(即先手总能立于不败之地)。
证明:
将硬币按初始下标分为奇数位集合 {V1,V3,…,Vn−1} 与偶数位集合 {V2,V4,…,Vn}。
计算两集合的和:Sodd=∑k=1n/2V2k−1 与 Seven=∑k=1n/2V2k。
- 若 Sodd≥Seven,先手第一步取走最左端的奇数位硬币 V1;此时留给后手的最左端 V2 与最右端 Vn 均为偶数位硬币!
- 后手无论取走 V2 还是 Vn,暴露给先手的两端必将再次包含一个奇数位硬币。
- 先手在后续每一步始终只选取奇数位硬币,最终能全揽全部奇数位硬币,获得 Sodd≥21∑Vi 的总面值。同理若 Seven>Sodd,先手第一步取 Vn 亦可全揽所有偶数位硬币。
极大化极小(Minimax)收益 DP
上述奇偶贪心仅能保证获得不低于一半的底线,无法最大化博弈收益。如何在面对超级理性的对手时获取最大的绝对面值?
定义子问题 V(i,j) 为当前轮到我方行动,且台面上剩余硬币为区间 Vi,…,Vj 时,我方所能获得的最大最终面值:
- 决策分支 1:我方取左端 Vi
- 剩余区间为 [i+1,j],轮到理性对手行动;
- 对手若取左端 Vi+1,留给下一轮我方的区间为 [i+2,j],我方收益为 V(i+2,j);
- 对手若取右端 Vj,留给下一轮我方的区间为 [i+1,j−1],我方收益为 V(i+1,j−1);
- 对手是超级理性的,必然选择使我方后续收益极小化的走法,因此留给我方的价值为:
min(V(i+2,j),V(i+1,j−1))
- 我方此分支的总期望收益为 Vi+min(V(i+2,j),V(i+1,j−1))。
- 决策分支 2:我方取右端 Vj
- 类似地,对手将在 Vi+1 与 Vj−1 间做对抗选择,留给我方:
min(V(i+1,j−1),V(i,j−2))
- 我方此分支的总期望收益为 Vj+min(V(i+1,j−1),V(i,j−2))。
我方在两大分支中选取最大者,最终转移方程为:
V(i,j)=max(Vi+min(V(i+2,j),V(i+1,j−1))Vj+min(V(i+1,j−1),V(i,j−2)))
边界条件:
- V(i,i)=Vi
- V(i,i+1)=max(Vi,Vi+1)
复杂度分析
状态总数仍然为 Θ(n2) 个数对 (i,j),每个状态的转移仅涉及常数次 min 与 max 运算(耗时 O(1))。整体算法复杂度严格为 Θ(n2)。
我的理解
高级动态规划向我们展现了“状态定义即算法”的最高境界:
- 空间几何的降维投影:无论是回文子序列的两端夹逼,最优二叉树的中间斩断,还是硬币博弈的边缘剥落,它们的核心都是将一个全局非线性的组合搜索问题,严格约束在二维平面右上半三角矩阵的区间拓扑上。
- 增量代数的妙用:最优二叉树中“左右子树全体深度加 1”看似难以跟踪,但通过全区间概率和 W(i,j) 的一次性加总,直接将微观深度的累加提炼为宏观权重的整块平移。这一设计思路在霍夫曼编码、矩阵链乘法中一脉相承。
- 零和博弈与动态规划的天然接轨:交替硬币游戏是博弈论与 DP 的交汇点。极大极小交替展开本质上是博弈树的自底向上倒后归纳法(Backward Induction),通过两层嵌套的 max−min 算子,在多项式时间内完美封死了理性博弈对手的所有反制路径。
:::
