Lec 7 随机化:跳表(Randomization: Skip Lists)
TL;DR
- 多层索引的平衡直觉:从“地铁特快快线”类比出发,将单链表逐步拓展为多级跳跃索引,推导得出 logn 层索引时单次搜索代价收敛至 2logn。
- 随机化几何提升:通过独立公平抛硬币(概率 p=1/2)决定节点向上一层晋升的层数,无需红黑树复杂的旋转染色操作,以极简逻辑维持全局统计平衡。
- 高概率界(w.h.p.):利用并集界(Boole 不等式)与 Chernoff 界,严格证明包含 n 个元素的跳表最大高度在以高概率 1−O(1/nα) 条件下受限于 O(logn)。
- 向后分析法(Backward Analysis):反向逆推搜索路径,将“向下或向右”前向搜索降维为“向上或向左”的独立伯努利过程,证明搜索总步数以高概率不超过 O(logn)。
检索结构演进:从单链表到多级跳跃
普通有序链表的查询复杂度为 Θ(n),因为指针只能单向逐节点移动。能否像地铁特快列车一样,只在“大站”停靠,从而实现快速区间跨越?
2 层链表的步长优化
在原始链表 L1 之上增加一条稀疏的“快车线” L2:
- 节点在快车线上均匀分布;
- 搜索时先在 L2 推进至最接近且不超过目标值的节点,再垂直下降至 L1 局部扫描。
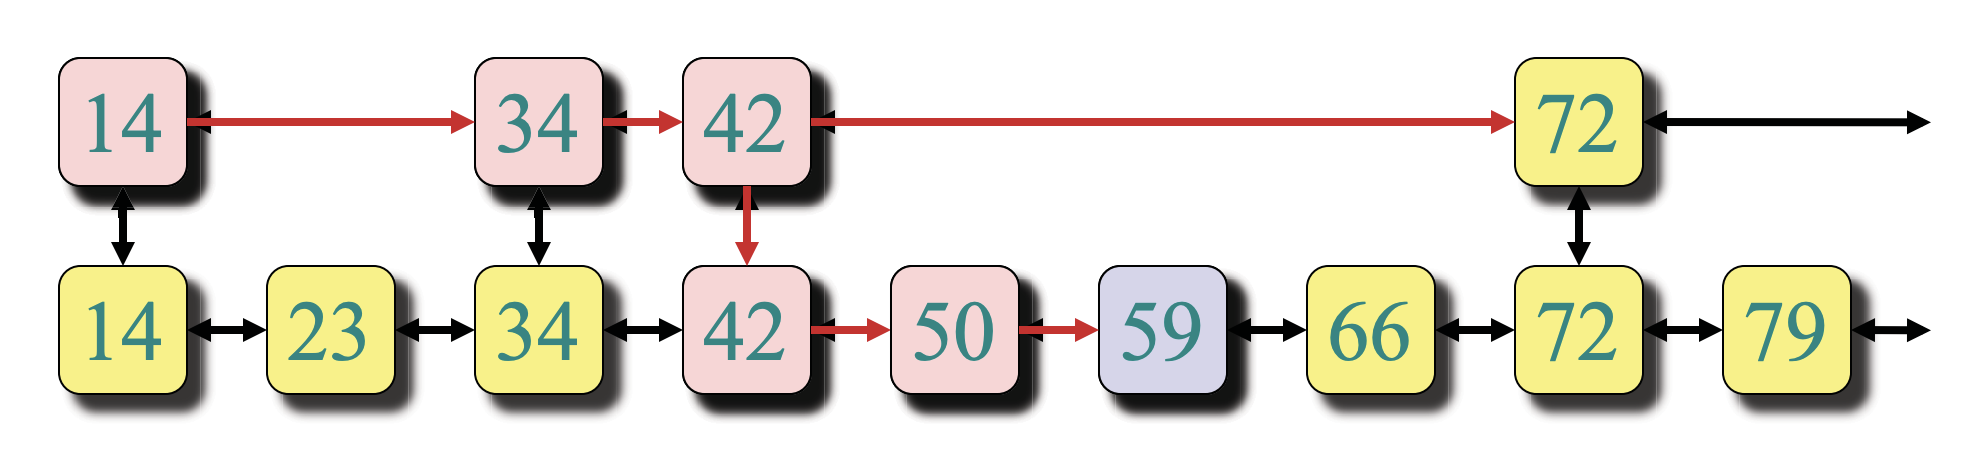
设原链表包含 n 个节点,快车线 L2 包含 ∣L2∣ 个节点。搜索的最大步数为:
Cost≈∣L2∣+∣L2∣n
根据均值不等式,当 ∣L2∣=∣L2∣n⟹∣L2∣=n 时开销取得极小值:
Costmin=n+nn=2n
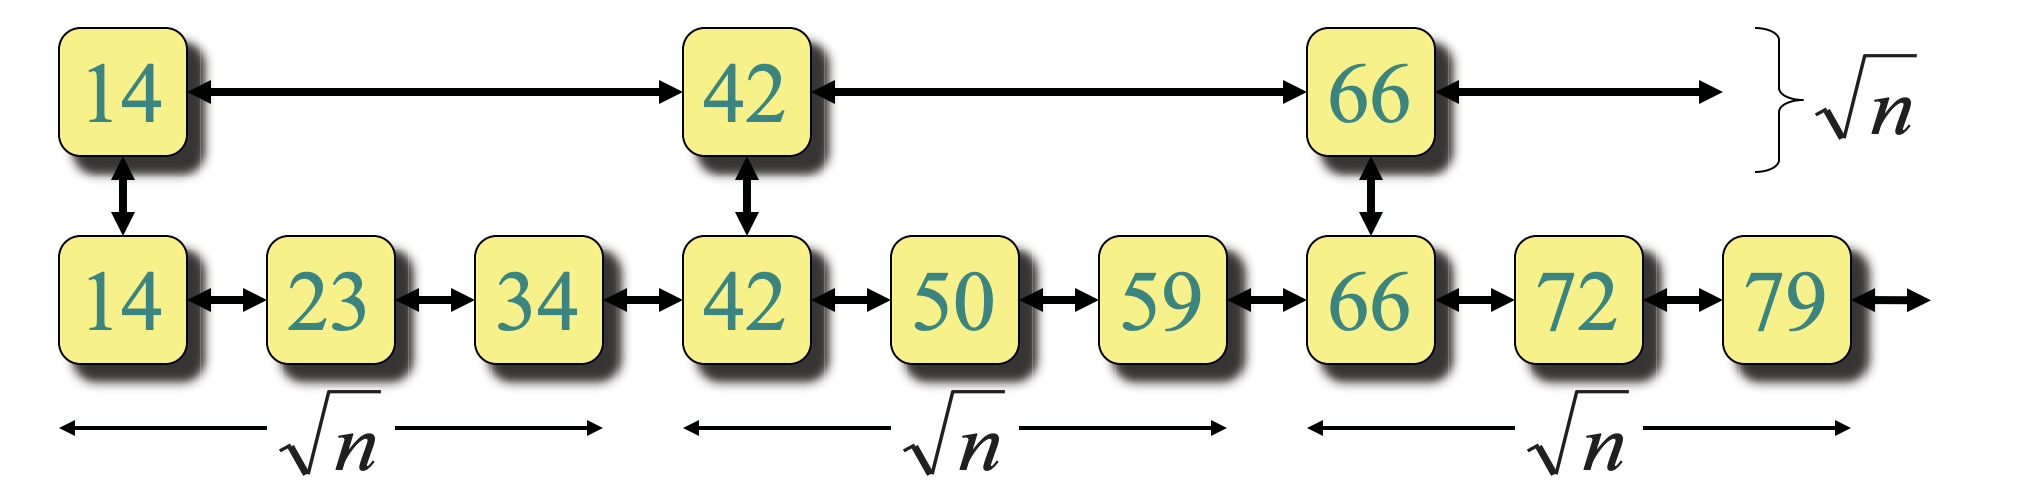
k 层链表与对数极限
若进一步拓展至 k 层链表,每一层步长以几何级数递增:
- 2 层链表:2⋅n1/2
- 3 层链表:3⋅n1/3
- k 层链表:k⋅n1/k
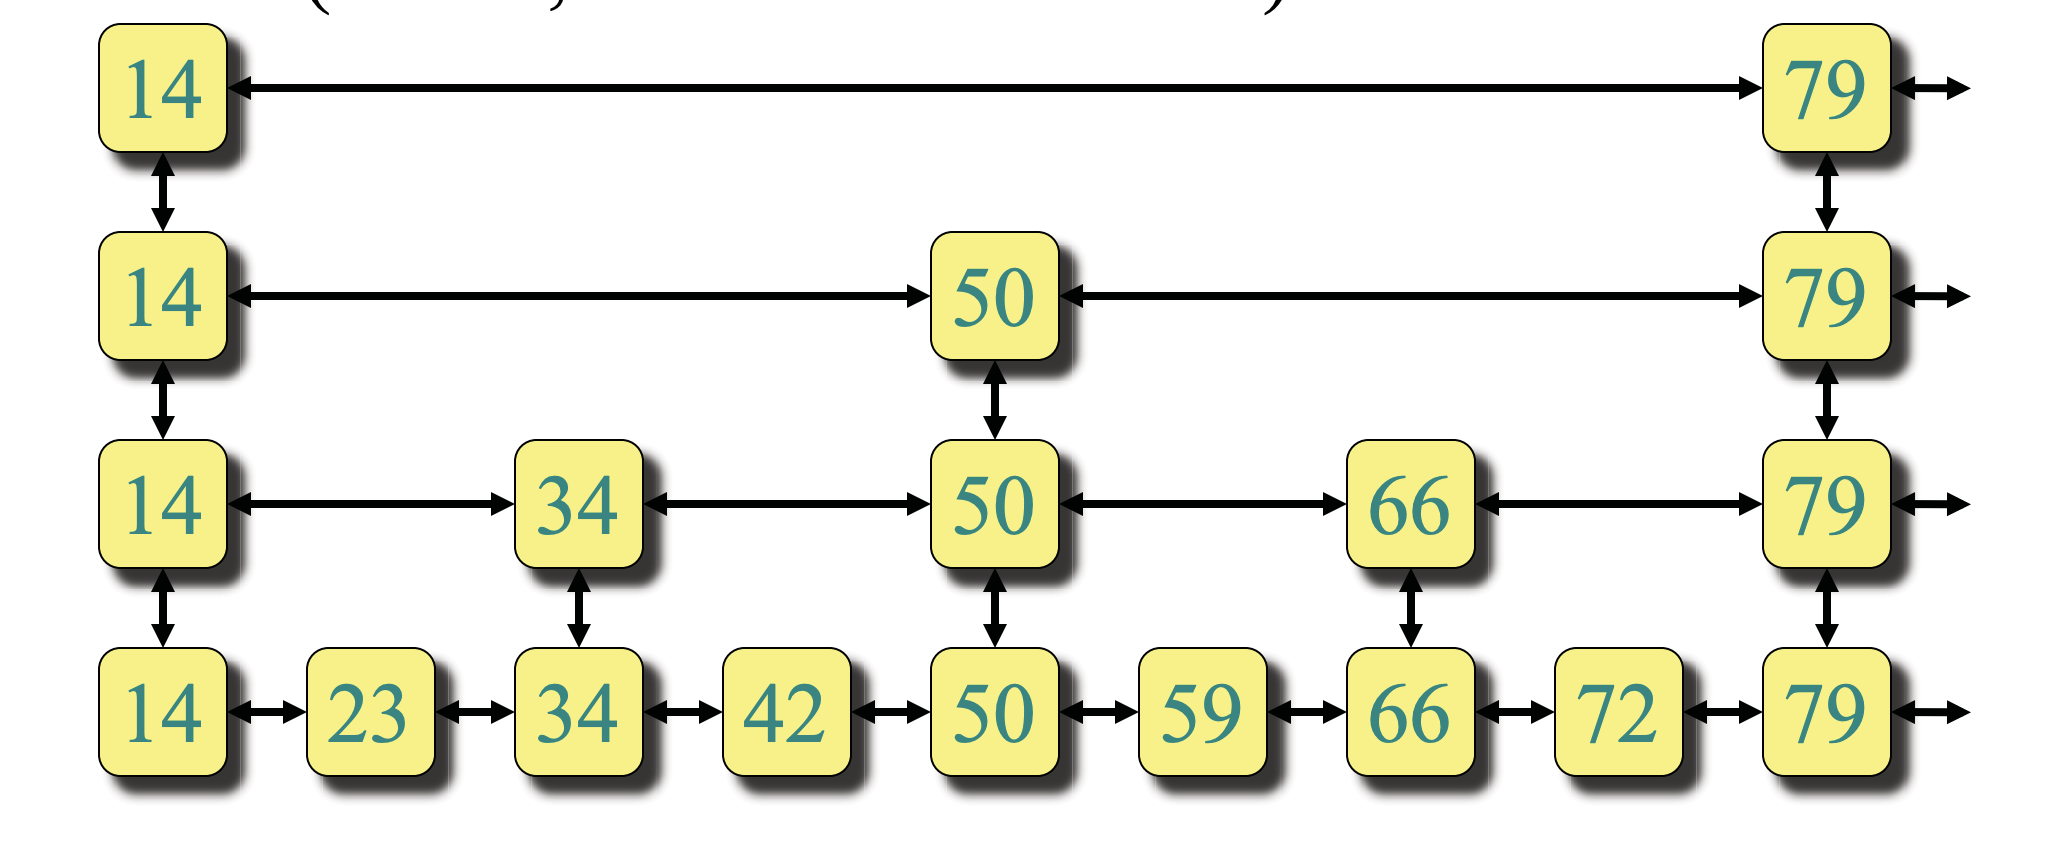
令层数取 k=log2n,则单次搜索步数收敛为:
Cost=(log2n)⋅n1/log2n=(log2n)⋅2=2log2n=O(logn)
然而,若在静态链表中严格维护均匀间距,每次插入或删除一个元素都会引发级联更新,维护成本高达 O(n)。William Pugh 在 1989 年提出的跳表(Skip List),通过引入局部随机化完美化解了动态维护难题。
跳表结构与随机化维护机制
随机硬币提升机制
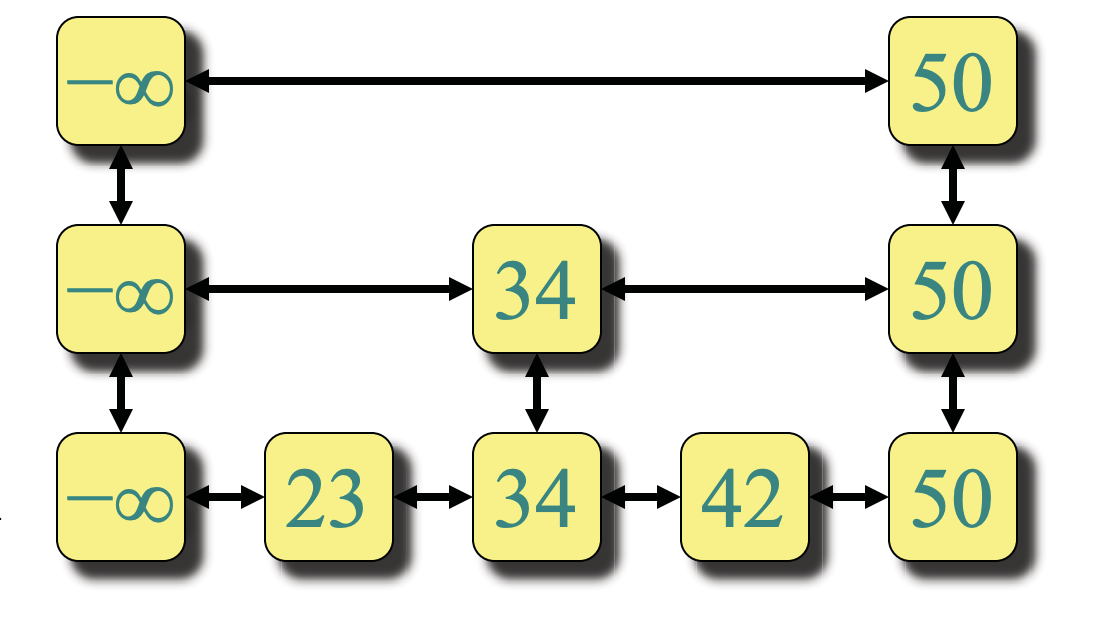
跳表由多层水平链表叠合而成,最底层(Level 0)包含全量元素:
- 每个节点从 Level 0 开始存在;
- 抛掷一枚公平硬币(正面朝上概率 p=1/2);
- 若为正面,将该节点晋升至上一层链表,并继续抛硬币;若为反面,停止提升;
- 节点在第 k 层出现的概率为 pk=(1/2)k。
动态操作
- 查找(Search):从最顶层左端虚拟哨兵 −∞ 开始:
- 若当前右侧指针指向的元素小于等于目标值,向右前进;
- 若右侧元素大于目标值或为空,向下移动一层;
- 当在 Level 0 无法向右推进时,判断当前节点是否等于目标。
- 插入(Insert):
- 执行
Search,在数组中记录下每一层“向下跳转”时经过的拐点指针(Update 数组);
- 随机决定新元素的高度;
- 类似单链表插入,仅更新各层拐点处的指针,耗时与高度呈线性关系。
- 删除(Delete):
- 通过
Search 找到各层的前驱节点,将前驱指针跨过目标节点相连并释放内存。
数学严密性证明:高概率界与向后分析
概率工具箱
定义
高概率事件(With High Probability, w.h.p.)
对于包含输入规模 n 的参数化事件 E,若对于任意选定的常数 α≥1,均存在常数 cα 使得:
Pr[E]≥1−nαcα则称事件 E 以高概率发生。这意味着失败概率 O(1/nα) 随着规模 n 增大而以多项式级急剧衰减,在工程与理论上均几乎必然成立。
定义
Boole 不等式(并集界 Union Bound)
对任意一组事件 E1,E2,…,Ek:
Pr[i=1⋃kEi]≤i=1∑kPr[Ei]若每个子事件的失效概率均为 O(1/nα) 且事件总数 k≤nc,则它们的联合失效概率依然是 O(1/nα−c)。
定义
Chernoff 界(Chernoff Bound)
设 X1,X2,…,Xm 为独立的 0-1 伯努利随机变量,其和为 Y=∑i=1mXi,数学期望为 μ=E[Y]。对于任意偏离量 r>0:
Pr[Y≥μ+r]≤e−m2r2
定理 1:跳表最大高度的高概率上界
定理
跳表高度界
包含 n 个元素的跳表,其最大高度以高概率满足 H≤clog2n(其中 c>1)。
证明:
任意固定元素 x 被提升至第 k 层的概率为 (1/2)k。
取常数 c≥2,令 k=clog2n。则单个元素高度超过 k 层的概率为:
Pr[元素 x 高度>clog2n]≤(21)clog2n=nc1
应用并集界(Union Bound),整个跳表中存在某个元素高度超过 clog2n 的概率为:
Pr[∃x∈S,高度>clog2n]≤x∈S∑Pr[高度>clog2n]≤n⋅nc1=nc−11
只要取 c=α+1,跳表最大层数超过 (α+1)log2n 的概率至多为 O(1/nα)。因此跳表高度以高概率受限于 O(logn)。
定理 2:单次搜索时间的高概率上界
前向分析搜索路径较为繁琐,因为每一步是向右还是向下依赖于复杂的键值大小关系。我们采用向后分析法(Backward Analysis)。
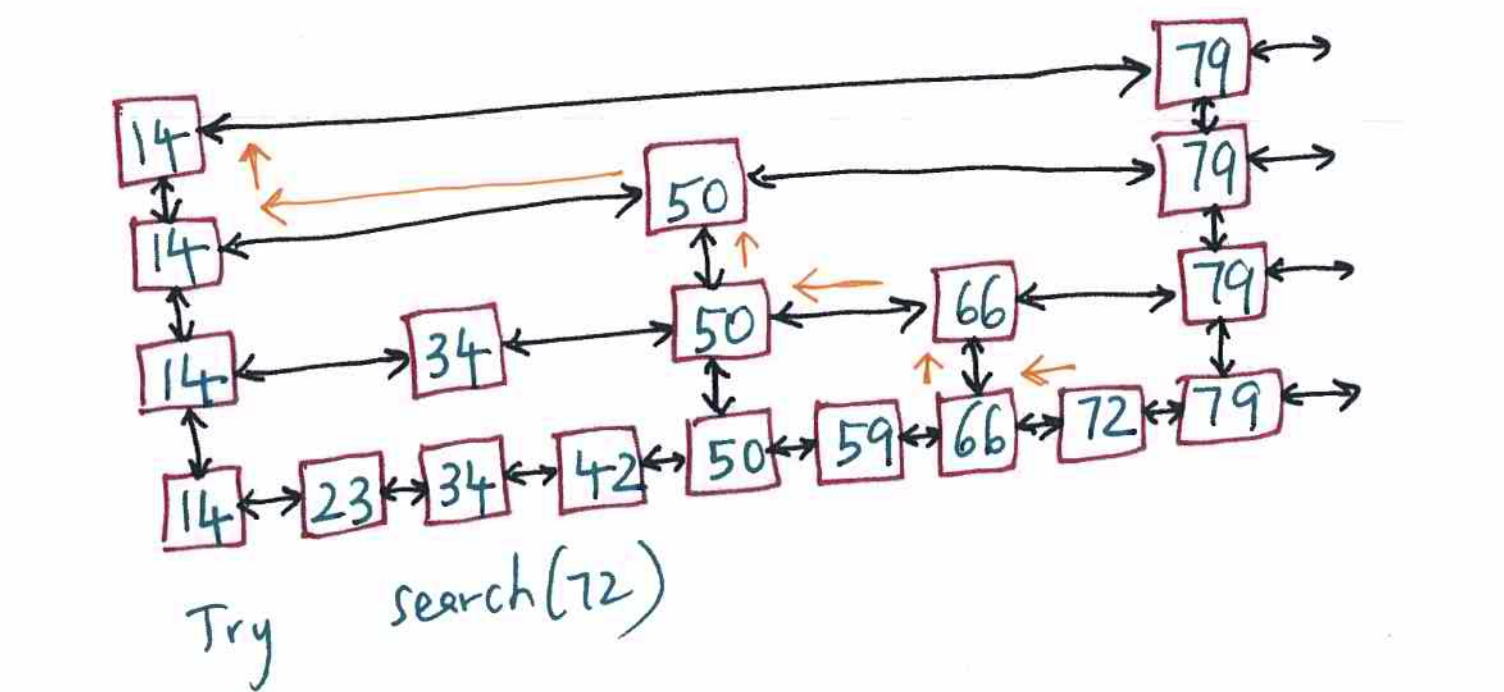
逆向追踪视角的独立性
设想我们将时间倒流,从目标节点在 Level 0 的位置反向往回走,直到抵达虚拟头节点 −∞:
- 在当前节点:
- 如果该节点曾经在建表时抛出硬币正面(即它成功晋升至上一层),则逆向路径向上移动一层(Up);
- 如果该节点在此层是反面未晋升(它是本层同簇里的前驱),则逆向路径向左移动一步(Left)。
- 关键性质:每个节点是否晋升完全由独立的抛硬币决定。因此在逆向追踪的每一步中:
Pr[Up]=21,Pr[Left]=21
- 逆向追踪终止的条件是:向上移动的步数达到了跳表的最大高度。
定理
跳表查询时间界
在包含 n 个元素的跳表中,任意单次搜索的运行步数以高概率满足 O(logn)。
证明:
根据定理 1,以高概率(记为事件 A),跳表的最大高度不超过 h=clog2n。这意味着逆向路径中向上移动(Up)的总步数至多为 clog2n。
现在考察逆向路径的总移动步数 M。若总移动步数 M>dlog2n(其中 d 为待定常数),则意味着在 m=dlog2n 次独立的伯努利实验中,出现“向上”(正面)的次数少于 clog2n 次,即出现“向左”(反面)的次数至少为 (d−c)log2n 次。
每次移动出现反面的期望次数为 μ=21m=2dlog2n。
取 d=6c,则 m=6clog2n,期望 μ=3clog2n。
反面次数超过 (d−c)log2n=5clog2n 对应于偏离期望的超出量:
r=5clog2n−3clog2n=2clog2n
根据 Chernoff 界:
Pr[反面≥5clog2n]≤e−m2r2=e−6clog2n2(2clog2n)2=e−6clog2n8c2log22n=e−34clog2n≤2−clog2n=nc1
定义事件 B 为“在 dlog2n 步内成功积累了 clog2n 次向上移动”。由上述分析,Pr[¬B]≤1/nc。
由并集界,事件 A(高度受限)与事件 B(步数收敛)同时成立的概率为:
Pr[A∧B]=1−Pr[¬A∨¬B]≥1−(Pr[¬A]+Pr[¬B])≥1−(nc−11+nc1)=1−O(nc−11)
因此,搜索步数以高概率不超过 dlog2n=O(logn)。
我的理解
跳表是随机化算法设计中最富启发性的经典范式之一:
- 以无序消除有序维护成本:平衡二叉树(AVL、红黑树)在每次增删时都需要竭尽全力通过旋转保持严格的树高几何平衡,其实现复杂度与常数代价高昂。跳表彻底放弃了确定性局部平衡,将每一层的密度控制权交给大数定律,以最轻量的抛硬币换取了同等的渐近速度。
- 向后分析的降维妙手:前向搜索路径充满了历史分支与边界依赖,直接求期望步数极为晦涩。向后分析法如同录像倒放——从已知终点逆流而上,原本不可预测的分支瞬间退化为标准的独立硬币投掷。这一分析范式在快速排序、随机增量构造等高级几何算法中同样大放异彩。
- 并发系统的工业宠儿:由于跳表的修改完全是局部的指针拼接,不存在跨子树全局重平衡旋转,因此在多线程并发场景(如 LevelDB、Redis Sorted Set、RocksDB)中,跳表可以通过轻量级 CAS 实现高并发无锁(Lock-Free)操作,在现代工业界完胜传统平衡树。
:::
