
Lec 1课程概览与区间调度
这是当前课程已收录的第一篇。
Lec 1 课程概览与区间调度(Overview & Interval Scheduling)
TL;DR
- 计算复杂性全景:区分多项式时间可解的 P 类、多项式时间可验证的 NP 类,以及最难的 NP 完全问题(NPC)。
- 无权区间调度:基于“最早完成时间优先”(Earliest Finish Time First)策略,通过拟置换法(Exchange Argument)严格证明贪心解的全局最优性。
- 带权区间调度:贪心选择失效后转为动态规划(DP),结合二分搜索查找前驱兼容区间,将复杂度由 优化至 。
- 区间划分与多机器调度:区间深度(Depth)构成了资源需求的刚性理论下界,按开始时间排序的贪心着色策略能以恰好 台机器完成全量无冲突调度。
计算复杂性导引:P、NP 与 NP 完全性
在算法设计中,极为相似的问题描述可能对应天壤之别的计算复杂度:
定义
P(Polynomial Time) 在确定性多项式时间内可判定的判定问题集合,即存在常数 使得算法运行时间在 之内。例如:单源最短路径(Dijkstra / Bellman-Ford,复杂度 或 )、欧拉回路判定(线性时间)。
定义
NP(Nondeterministic Polynomial Time) 在多项式时间内其实例解答可被验证(Verifiable)的判定问题集合。若给定一个解的候选凭据(Certificate),可在 时间内核验其有效性。例如:哈密顿回路判定(验证给定路径是否恰好访问每个顶点一次极为简单)。
定义
NP 完全性(NP-Complete) 问题属于 NP 类,且 NP 中的任意问题均可在多项式时间内归约至该问题。若任意一个 NP 完全问题存在多项式时间算法,则 。
无权区间调度与贪心选择
问题形式化定义
给定单个共享资源与 个请求构成的集合 。每个请求 包含起始时间 与结束时间 ,满足 。
若两请求 互不重叠,即 或 ,则称它们是兼容的(Compatible)。
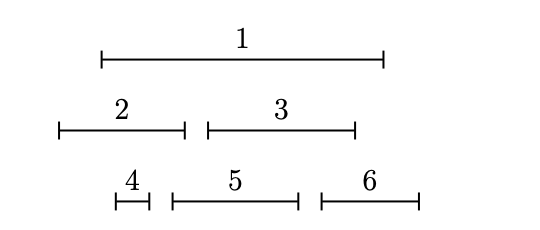
- 优化目标:选出一个两两兼容的请求子集 ,使得子集规模 最大。
贪心启发式规则尝试与反例分析
贪心算法每次依据局部启发式准则选择一个区间 ,剔除所有与其冲突的重叠请求,直到无可用区间。核心在于选取何种选择规则:
-
尝试 1:最早开始时间优先(Minimum )
- 反例:若存在一个超长区间跨越全局(例如 ),但内部存在数十个短区间,优先选择最早开始者将导致其余所有短区间被拒绝。
-
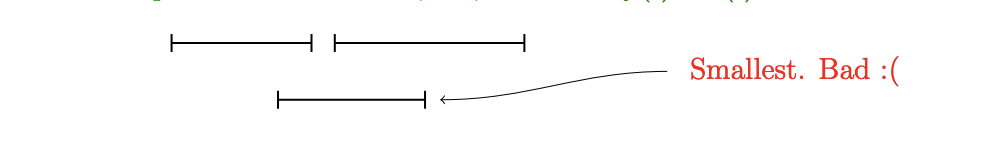
尝试 2:最短持续时间优先(Minimum )
- 反例:短区间可能横跨两个非重叠区间之间的间隙,导致选 1 弃 2。
-
尝试 3:最少冲突次数优先(Minimum Incompatible Count)
- 反例:在特定结构中,选择当前局部冲突最小的区间,可能会破坏后续多组更大规模的无冲突序列。
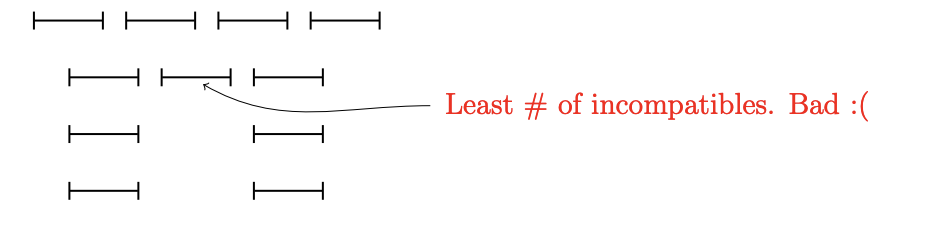
-
尝试 4:最早完成时间优先(Earliest Finish Time First)
- 策略:在当前候选集合中,选择 最小的请求。直觉在于:越早结束,为后续保留的可用时间窗口就越大。
贪心最优性数学证明
定理
最早完成时间贪心算法的最优性 设贪心算法按最早完成时间产出的调度为 ,最优调度为 。则必然有 。
证明(归纳法与置换论证 Exchange Argument):
-
基本情况:当 时,由于至少可选 1 个,贪心解 ,故 显然成立。
-
归纳假设:假设对于任意最优规模为 的子问题,贪心算法均能返回最优解。
-
归纳步骤:考虑规模为 的最优调度序列 :
贪心算法第一步选取的区间为 。根据贪心选择准则:
由于 仅与 中的自身冲突,且 的起始时间满足 ,因此区间 与 全部兼容!
我们构造新调度 :
依然由 个两两兼容的区间组成,故 亦为最优调度。
现在定义剩余问题空间 。因为 在全局最优,所以其后继序列 必须是子问题 的最优调度(规模为 )。
根据归纳假设,贪心算法在 上必定能找到规模为 的解。由于贪心算法在选定 后正是严格在 上继续执行并产出 ,因此:
证毕。
带权区间调度与动态规划
当每个请求带有独立权值 时,贪心准则立刻失效(极早结束的区间可能权值极微,而略长区间收益极高)。此时须转用动态规划(Dynamic Programming)。
子问题形式化与状态转移
将请求集合按结束时间升序预排序:。
对每个请求 ,定义其前驱兼容区间索引 :
对于第 个区间的子问题 ,决策仅有两种:
- 不选第 个区间:收益为 ;
- 选择第 个区间:获得收益 ,其前面不可包含任何重叠区间,因此前置最优只能延伸至 ,总收益为 。
状态转移方程如下:
边界条件为 。
复杂度优化:从 到
- 若每次线性查找 ,计算前驱需要 ,状态计算总耗时为 。
- 由于所有区间按结束时间 有序排列,利用**二分搜索(Binary Search)**查找满足 的最大下标只需 。
- 排序耗时 ,预处理所有 耗时 ,DP 填表耗时 ,整体运行时间严格控制在 。
区间划分与多机器调度
若任务无法丢弃,但允许多台相同的机器并行处理,如何使用最少的机器容纳所有请求?
定义
区间深度(Interval Depth) 在一组区间 中,任意时刻 覆盖该时刻的区间集合的最大重叠数称为该区间集的深度 :
显然,任何调度方案至少需要 台机器(因为在重叠峰值处有 个互不兼容的请求必须同时占用不同机器)。
贪心着色算法
- 将所有请求按起始时间递增排序:;
- 依次遍历每个区间 :
- 检查已有机器中是否存在当前空闲的机器(即机器上最后一个区间的结束时间 );
- 若存在,分配至该机器;
- 若所有机器均处于忙碌状态,开辟一台新机器并分配给区间 。
定理
多机器区间划分的最优性 上述按起始时间排序的贪心算法所分配的机器总数恰好等于区间深度 ,因此在机器数量上全局最优。
证明: 假设算法分配了第 台机器给区间 。这意味着在考虑区间 时,已存在的 台机器全部处于忙碌状态,即每台机器上都有一个区间的结束时间晚于 。同时,由于所有区间是按起始时间遍历的,这 台机器上的活动区间起始时间必然 。
因此,在时刻 ,连同区间 本身在内,共有至少 个区间彼此重叠并覆盖时刻 。根据深度的定义,必然有 。又因为算法终止时最大机器编号不会超过任何时刻检测到的重叠数,故最大机器数 。二者结合得到所需机器数恒等于 。
使用优先队列(小根堆)维护每台机器的最早可用时间,整体算法复杂度为 。
我的理解
区间调度是领悟“算法策略谱系”的最经典切片:
- 贪心选择的本质是空间压缩:无权区间调度之所以可以用贪心解决,是因为所有区间的收益权值完全等价,算法只需在时间轴上“尽可能紧凑地排列”,最早完成时间优先就是让未决时间资源最大化的保全策略。
- 权值打破拟阵,DP 接管全局:一旦引入权重,局部极早完成不再蕴含全局最优,局部贪心彻底失效。此时必须利用区间单向演进的时间箭头建立子问题拓扑序,动态规划通过“选或不选”的完备分支与二分查找,在多项式时间内穷尽了状态演化路径。
- 资源扩容的对偶之美:单机器调度关注“在固定资源下最大化吞吐”,多机器调度关注“在固定需求下最小化资源”。区间深度 既是下界障碍,又是按起始时间贪心所能达到的精确上界,体现了组合优化中强对偶定理的雏形。 :::