
Lec 23缓存无关算法:中位数与矩阵相乘
当前课程暂无后续已收录内容。
Lec 23 缓存无关算法:中位数与矩阵相乘(Cache-Oblivious: Medians & Matrices)
TL;DR
- 突破平坦内存假设:传统 RAM 模型假设访问任意内存地址耗时恒定,忽略了现代硬件 L1/L2/L3 缓存、主存与磁盘之间相差数个数量级的访问延迟金字塔。
- 缓存无关模型哲学(Frigo et al., 1999):算法代码中不硬编码任何硬件相关的缓存大小 与块大小 ,仅凭纯粹的分治递归自适应适配多级存储层次中的每一层。
- 缓存无关线性扫描与中位数选择:连续扫描产生 次缓存缺页;分治中位数选择以 为递归基,实现与内存搬运理论极限匹配的 内存传输。
- 分治矩阵乘法的二次加速:将 矩阵递归四等分,当子矩阵规模收缩至 时自然驻留缓存,将传统矩阵乘法的缺页数从 急剧压缩至 。
本讲导览
在经典的随机访问机(RAM)模型中,所有指令和内存访问都被假定需要相同的常数时间(1 个时钟周期)。然而在现代计算机物理体系中,CPU 寄存器访问仅需不到 1 纳秒,而 DRAM 主存访问需要约 50~100 纳秒,固态硬盘与机械磁盘的 I/O 延迟更是高达微秒乃至毫秒级(相差 倍)。
为了掩盖这一严峻的物理延迟鸿沟,现代体系结构构建了深度存储金字塔。**缓存无关算法(Cache-Oblivious Algorithms)**提供了一种极具美感的高级算法设计范式:在完全不知道底层缓存参数的前提下,使程序在所有存储层次上自适应地达到理论最优的 I/O 效率。
现代存储分层与两大计算模型
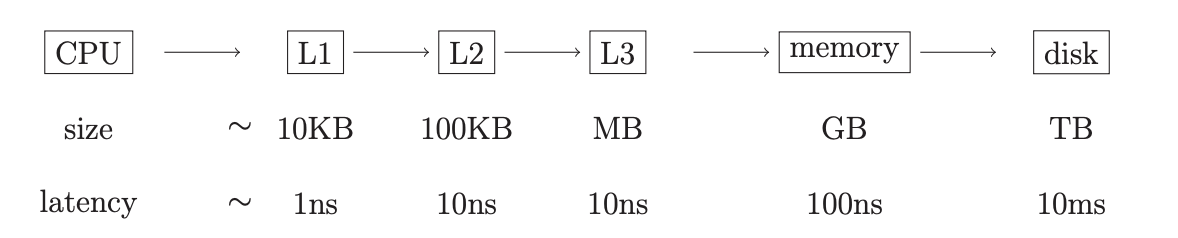
数据在存储层级之间的移动以**块(Block / Cache Line)**为基本单位:
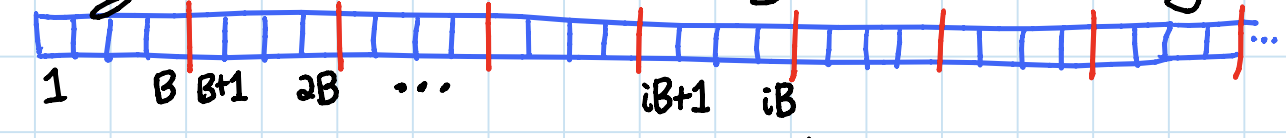
- 当 CPU 访问某个字时,系统会自动将包含该字的连续 个字节整块加载至上一级缓存;
- 空间局部性(Spatial Locality):尽量访问同一数据块内相邻的字;
- 时间局部性(Temporal Locality):在数据块被逐出之前尽可能多地重复使用它。
1. 外部内存模型(External Memory Model, Aggarwal & Vitter 1988)
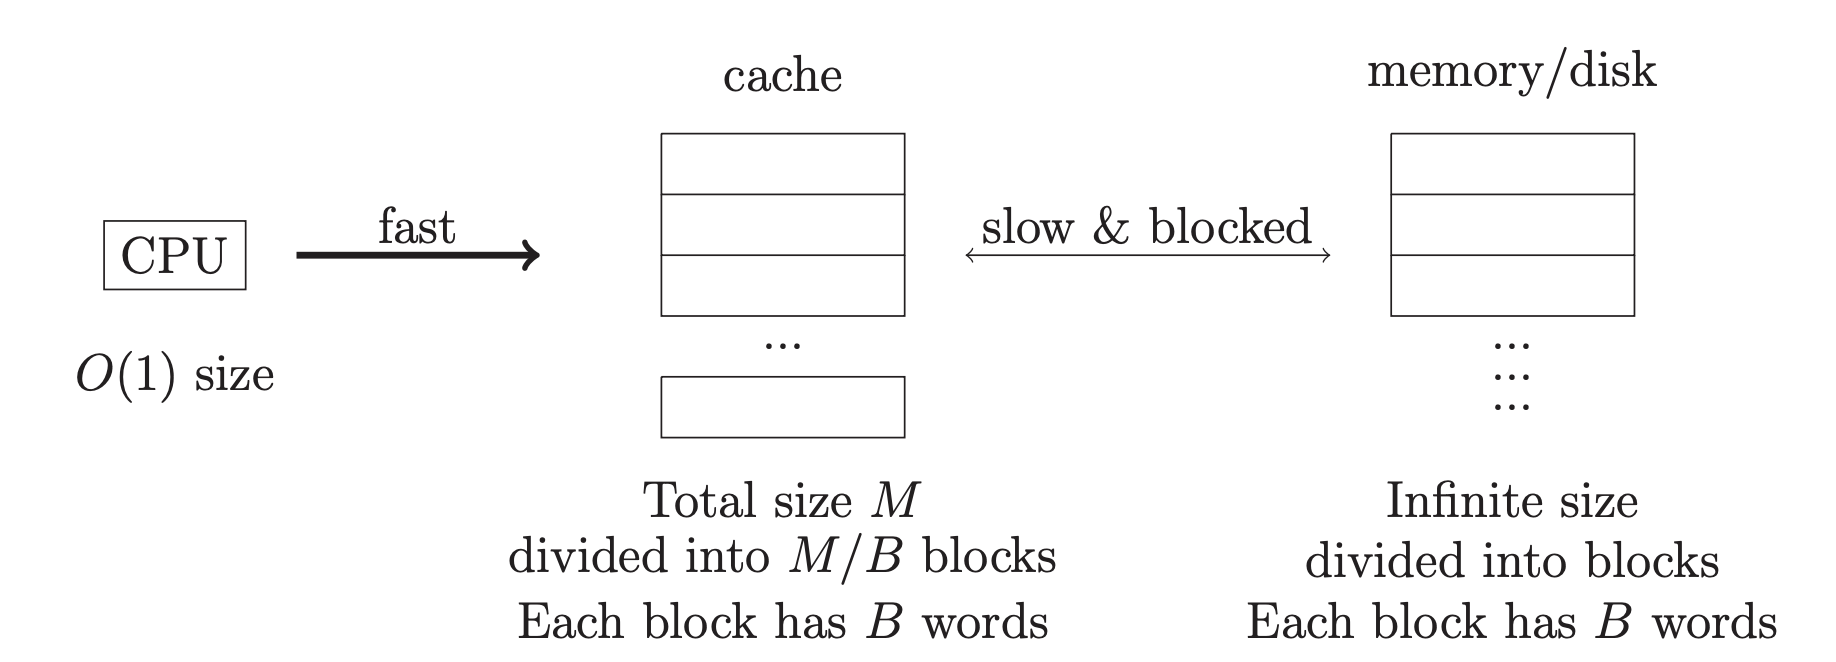
- 硬件假设:快速内部缓存容量为 ,块大小为 ;外部慢速存储(磁盘)容量无限;
- 算法行为:算法显式知晓参数 和 ,并显式发出“读取第 块”、“写入第 块”的 I/O 指令;
- 瓶颈衡量:内部 CPU 计算免费,仅统计缓存与外存之间的内存传输次数(Memory Transfers / I/O Complexity)。
- 局限性:算法参数与特定机器绑定,若移植到不同型号的 CPU 或固态盘上,必须针对新的 和 重新调优重编译;且无法兼顾 L1、L2、L3、主存等多级嵌套结构。
2. 缓存无关模型(Cache-Oblivious Model, Frigo et al. 1999)
- 核心设定:算法像编写普通单机程序一样运行,源代码中严禁出现任何关于 或 的参数!
- 底层契约:系统硬件或操作系统在发生缓存不命中(Cache Miss)时自动将缺失的块调入缓存,并采用最优离线替换策略(根据 Sleator-Tarjan 竞争分析,实际 LRU 仅带来至多 2 倍资源膨胀);
- 惊人优势:如果一个算法在未知参数 和 的情况下被证明具有最优的 渐近界,那么它将同时在存储金字塔的任意两个相邻层级之间(如 L1-L2、L2-L3、L3-DRAM、DRAM-NVMe)自动且同时达到最优传输效率!
基础操作:缓存无关线性扫描
考虑对长度为 的数组执行线性累加扫描:
total = 0
for i in range(N):
total += A[i]- 在已知 的外存模型中,可将数组起始地址与块边界严格对齐,传输次数为 ;
- 在缓存无关模型中,算法无法强制内存块对齐。数组的首尾元素可能横跨不完整的块边界;
- 最坏情况下,至多额外消耗 1 次未对齐的头部块与 1 次尾部块传输:
- 只要并发扫描的独立流(Streams)数量不超过缓存总块数 ,多路并行扫描的缺页总数依然保持为线性的 。
分治中位数查找的 I/O 复杂度
回顾第 2 讲中的 BFPRT 确定性选择算法,在不改变算法内部比较逻辑的前提下,我们从缓存缺页的角度重新审视其内存传输开销 :
- 五分划组:在连续内存中逻辑遍历,耗时与传输为 0;
- 求每组中位数:扫描全量 个元素,各组在局部完成排序,单次流式扫描消耗 次 I/O;
- 递归求中位数的中位数:在 个中位数上递归,产生 次 I/O;
- 主元划分(Partition):通过 3 个输出流将数组原位分为小于、等于、大于三部分,属于常数路扫描,产生 次 I/O;
- 单分支递归:最坏情况下在规模至多 的子数组上递归,产生 次 I/O。
由此得到内存传输递归关系式:
关键递归基分析
在单机 CPU 复杂度分析中,递归基是 。 但在存储层次分析中,存在一个极其强大的天然物理递归基: ::: theorem 块驻留递归基 当子问题规模收缩至 (其中 为常数)时,整个子数组的数据可以完全装入单个连续块中。一旦该块被载入缓存,后续所有组内排序与划分均在缓存内部发生,不再产生任何外部内存传输:
利用主定理对递归树求和:每一层所有节点的扫描开销总和以公比 几何递减,根节点所在层占据主导地位。展开至叶节点(规模为 )时,总传输次数为:
这证明了:经典 BFPRT 算法本身天然就是缓存无关最优的!它的内存缺页数与单次简单线性扫描完全相同。
分治矩阵乘法的二次方级加速
给定两个 的稠密矩阵 与 ,计算其乘积 。
朴素三层循环的缓存灾难
若采用教科书中的朴素实现:
- 按行优先存储,计算每一行时具有良好的空间局部性( 次缺页);
- 但 按列访问,如果每列跨越不同的内存页面且 ,访问 的每一项都会触发一次新的缓存缺页;
- 朴素算法的内存传输总次数高达 ,硬件缓存近乎完全失效!
分治分块矩阵乘法
将 矩阵均分为 4 个 (N/2) 的子矩阵:
每个子矩阵的计算转化为 2 次规模为 的乘法与 1 次矩阵加法:
递归关系式包含 8 个子矩阵乘法与线性扫描矩阵加法:
缓存自适应吸收与极限复杂度推导
由于算法并不知道缓存大小 ,它会盲目地向下无限递归切分。 然而在物理执行时,当子矩阵规模缩小到可以全部装入物理缓存时,递归在硬件层面上自然截断!
全缓存驻留阈值 当子问题规模 满足三个参与的子矩阵总大小不超过缓存容量时:
此时,矩阵 、 与 可以同时常驻在缓存中。完成该子乘法只需将这三个子矩阵全量装入缓存,产生的内存传输仅为扫描代价:
在此规模以下的所有更深层递归调用,缺页数为 0!
现在考察递归树在这一高度被物理截断时的总体传输量:
- 叶节点规模:;
- 叶节点数量:递归树每一层分支数为 8,问题规模每层减半,树深为 。因此叶节点总数为:
- 全局 I/O 总代价:叶节点数量乘以每个叶节点的实际加载代价:
性能跃迁对比:
- 朴素矩阵乘法: 次传输;
- 缓存无关分治矩阵乘法: 次传输。 在分母上额外获得了 的巨大加速因子! 若缓存大小 (约可容纳 个双精度浮点数),。这意味着分治算法相比朴素算法将总内存访问延迟削减了上千倍,且无需在源码中写死任何针对该机器 值的硬编码! :::
我的理解
缓存无关算法是理论计算机科学中“大道至简”理念的最高境界:
- 无知反成全知(Ignorance is Bliss):传统高性能工程迷信“手动参数调优”(Tuning),工程师耗费数月针对特定机器的 L1/L2 缓存写满汇编分块内联,换一台机器便性能崩塌。缓存无关算法向我们证明:通过分治自相似性(Self-similarity),算法对底层硬件参数的“全然不知”,反而成就了它跨越任意多层存储金字塔的“处处最优”。
- 几何分治的天然致密性:矩阵乘法从 到 的飞跃,其代数本质在于表面积与体积的比率守恒。规模为 的子矩阵计算需要 次算术运算,但其物理内存占用仅为 。递归分治持续挤压数据尺寸,直到数据完全跌入缓存池,在内部一次性完成密集的立体碰撞。
- 现代软硬件契约的终极范式:在当今 CPU 异构架构(大小核、三级缓存共享、NUMA 节点、HBM 显存并存)极其错综复杂的环境下,试图在应用层静态预测内存流向已不合时宜。缓存无关范式把分层调度的自由度完全交还给硬件控制器,以递归结构与大数定律实现了软件与硬件的完美共生。 :::