Lec 8 随机化:通用哈希与完美哈希(Randomization: Universal & Perfect Hashing)
TL;DR
- 打破简单均匀假设:传统哈希依赖“输入数据完全随机分布”的不切实际假设,通用哈希通过在运行时由算法随机挑选哈希函数,将随机性掌控在算法自身手中以防御对抗性输入。
- 通用哈希族定义与界限:若函数族 H 满足任意两不同键发生冲突的概率 ≤1/m,则任意槽的期望冲突数被严格限制在 1+α(装填因子 α=n/m)。
- 两级完美哈希(FKS 方案):第一级哈希将 n 个键分散到 m=n 个桶中,第二级为包含 nj 个键的桶分配 mj=nj2 大小的二次方表,利用生日悖论消除冲突。
- 最坏 O(1) 查找与线性空间:通过马尔可夫不等式严格证明二级散列表的总空间期望为 E[∑nj2]<2n,在最坏情况下仅需 2 次哈希计算即可完成确定性无冲突检索。
字典 ADT 与简单均匀哈希的缺陷
字典(Dictionary)是一种基础抽象数据类型(ADT),用于维护一组动态元素集合,支持以下核心操作:
Insert(x):插入元素 xDelete(x):删除指定元素 xSearch(k):检索键为 k 的元素
设关键字全集为 U={0,1,…,u−1},当前集合包含 n 个键,散列表大小为 m。
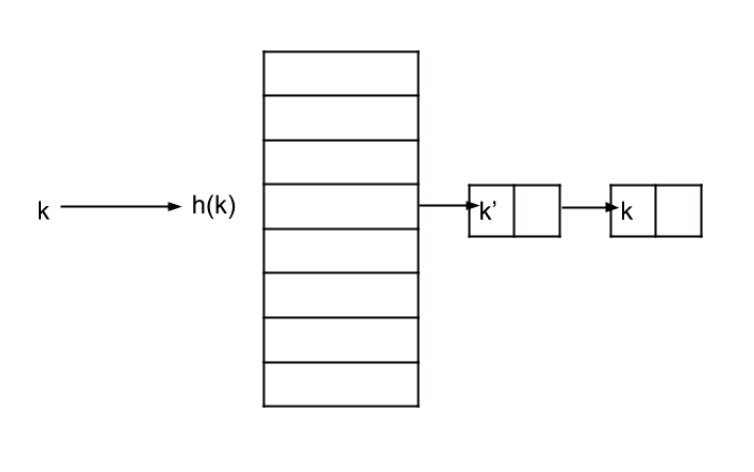
在初等算法教学中,通常引入简单均匀散列假设(Simple Uniform Hashing Assumption, SUHA):假设任意关键字等可能地散列到 m 个槽中的每一个,且各关键字的散列彼此独立。在此假设下,采用链地址法解决冲突时,槽的平均链长为装填因子 α=n/m,单次查找的期望耗时为 Θ(1+α)。
然而在现实对抗环境中,SUHA 存在致命漏洞:若攻击者获知了固定的哈希函数 h,便可专门构造一组全部映射到同一槽位 h(k1)=h(k2)=… 的对抗样本,导致查找时间退化至最坏情况下的 Θ(n),引发哈希拒绝服务攻击(Hash DoS)。
通用哈希(Universal Hashing)及其严格期望界
解决对抗性攻击的根本途径是将随机性交由算法内部掌管:在算法启动时,从一组预先设计好的哈希函数族 H 中,以均匀分布独立随机抽取一个哈希函数 h。此时即使攻击者预先知晓输入数据,由于不知道算法当前抽取的是哪个具体函数,依然无法诱发最坏情况。
定义
通用哈希函数族(Universal Hash Family)
设 H 是将全集 U 映射至 {0,1,…,m−1} 的有限哈希函数集合。若对于 U 中任意两个互异的关键字 k1=k2,随机选取的函数 h∈H 发生冲突的概率满足:
h∈HPr[h(k1)=h(k2)]≤m1则称 H 为通用哈希函数族。
冲突期望的严格证明
定理
通用哈希链长界
设 h 从通用函数族 H 中均匀随机选出,并将任意包含 n 个不同键的集合 S 散列至大小为 m 的表中。对于任意给定键 k∈U(无论 k 是否在 S 中),包含 k 的槽内来自 S 的期望键数满足:
E[nh(k)]≤{α1+α(k∈/S)(k∈S)(其中 α=mn)证明:
对任意 x∈S,定义指示随机变量 Ik,x∈{0,1} 表示 k 与 x 是否发生冲突:
Ik,x=1{h(k)=h(x)}
由通用哈希定义,对于所有 x=k:
E[Ik,x]=Pr[h(k)=h(x)]≤m1
与键 k 同槽的集合 S 中元素总数可表示为:
nh(k)=x∈S∑Ik,x
由期望的线性性质(Linearity of Expectation):
- 若 k∈/S,所有 x∈S 均与 k 互异:
E[nh(k)]=x∈S∑E[Ik,x]≤x∈S∑m1=mn=α
- 若 k∈S,分解出自身项 x=k(此时必有 Ik,k=1):
E[nh(k)]=E[Ik,k]+x∈S∖{k}∑E[Ik,x]≤1+mn−1<1+α
证毕。只要维护 m=Θ(n),所有操作的期望时间严格受限于 O(1)。
构造通用哈希函数族
如何高效构造满足通用性的哈希族?Carter 与 Wegman 给出了基于有限域乘法与模运算的经典方案:
- 选取一个足够大的素数 p,使得 p>u(全集中的每个键均满足 0≤k<p);
- 令 Zp={0,1,…,p−1},Zp∗={1,2,…,p−1};
- 对于任意 a∈Zp∗ 与 b∈Zp,定义哈希函数 ha,b:
ha,b(k)=((ak+b)modp)modm
- 函数族 Hp,m={ha,b∣a∈Zp∗,b∈Zp}。
定理
函数族 Hp,m 是一个通用哈希函数族,其包含 p(p−1) 个不同的哈希函数。
证明思路:
对两个互异键 k1=k2,线性映射 r=(ak1+b)modp 与 s=(ak2+b)modp 在模 p 的有限域上构成双射。两式相减得 r−s≡a(k1−k2)(modp)。由于 p 是素数且 k1=k2,a=0,故 r=s。
当 (a,b) 均匀遍历所有可能时,(r,s) 等概率地遍历所有不同的有序对。
进一步对 m 取模时,对于固定的 r,在剩余的 p−1 个 s 中,满足 r≡s(modm) 的取值个数至多为 ⌈p/m⌉−1≤(p−1)/m。因此碰撞概率 ≤p−1(p−1)/m=m1。
两级完美哈希(FKS 方案)与最坏 O(1) 查找
通用哈希仅保证期望单次 O(1),但在最坏情况下单槽冲突仍可能较大。对于静态字典(如编程语言保留字检索、光盘固定字典、只读知识库索引),Fredman、Komlós 与 Szemerédi 于 1984 年提出了划时代的 FKS 两级完美哈希方案,实现最坏情况下 O(1) 查找与线性 O(n) 空间消耗。
两级体系架构设计
- 第一级(主表):
- 选取容量为 m=n 的主散列表,使用通用哈希函数 h 将 n 个键分发至 m 个槽;
- 设落入槽 j 的键数为 nj。
- 第二级(二级子表):
- 为每个非空槽 j 分配一个独立的二级散列表 Sj,其容量设为平方规模:
mj=nj2
- 从二级通用哈希族中随机挑选一个函数 hj,将槽 j 内的 nj 个键散列至大小为 nj2 的二级表中,直到没有任何冲突发生为止。
为什么 mj=nj2 能保证无冲突?
定理
生日悖论与二次空间零冲突
若将 nj 个键通过通用哈希映射至大小为 mj=nj2 的表中,发生至少一次冲突的概率严格小于 1/2。
证明:
在包含 nj 个键的集合中,可能发生冲突的键对总数为 (2nj)=2nj(nj−1)。
设指示变量 Cx,y=1{hj(x)=hj(y)},由通用哈希性质,E[Cx,y]≤1/mj=1/nj2。
冲突对总数 C 的数学期望为:
E[C]=x<y∑E[Cx,y]≤(2nj)nj21=2nj2nj(nj−1)<21
应用马尔可夫不等式(Markov's Inequality):
Pr[C≥1]≤1E[C]<21
因此,只要随机抽取二级哈希函数 hj,至少有 1/2 的概率实现完全零冲突!若发生冲突,只需重新随机生成 hj 再次尝试,期望尝试次数不超过 2 次即可找到完美的二级哈希函数。
全局空间消耗的线性约束
总存储空间为 ∑j=0m−1mj=∑j=0m−1nj2。二级分配平方空间是否会导致总空间爆炸?
定理
全局空间期望界
当第一级散列表大小取 m=n 时,二级子表空间总和的期望值满足:
E[j=0∑m−1nj2]<2n证明:
利用恒等式 nj2=nj+2(2nj):
j=0∑m−1nj2=j=0∑m−1nj+2j=0∑m−1(2nj)=n+2j=0∑m−1x<y∑1{h(x)=h(y)=j}=n+2x<y∑1{h(x)=h(y)}
两边取期望:
E[j=0∑m−1nj2]=n+2x<y∑Pr[h(x)=h(y)]≤n+2(2n)m1=n+22nn(n−1)=n+(n−1)<2n
再次应用马尔可夫不等式:
Pr[j=0∑m−1nj2≥4n]≤4nE[∑nj2]<4n2n=21
因此,第一级哈希建表时,总空间受控在 4n 以内的概率大于 1/2。若超过 4n,直接重选第一级哈希函数重构即可,期望重构次数至多 2 次。
检索性能
查询任意键 k:
- 计算 j=h(k) 定位二级子表;
- 计算 pos=hj(k) 读取槽内键值;
- 检查 Sj[pos] 是否等于 k。
全过程包含且仅包含 2 次算术哈希计算与 2 次内存间接寻址,无循环、无链表遍历、无分支重试,在最坏情况下确定性耗时严格为 O(1),总空间复杂度严格为 O(n)。
我的理解
通用哈希与完美哈希是“算法博弈论”与“概率分层”的巅峰之作:
- 从被动假设到主动打破:经典算法往往假设“输入服从良好分布”,在现实对抗中不堪一击。通用哈希反客为主,将随机源收拢于算法内部。它告诉我们:最强大的确定性往往源于算法主动引入的不可预测性。
- 两级架构的宏微解耦:如果对全量 n 个元素直接采用单一无冲突表,由生日悖论需要 O(n2) 空间,代价不可承受。FKS 巧妙地利用第一级将规模拆解至微观桶,使得宏观期望满足线性 ∑nj2<2n。这是一种“宏观用期望平摊、微观用平方防碰撞”的精妙解耦。
- 确定性无冲突的工业价值:在现代高性能网关查找、编译器符号表解析与密码学字典验证中,消除“长尾延迟抖动”往往比单纯提高平均速度更为关键。FKS 证明了:即使在完全静态的哈希查找中,我们也可以彻底消灭冲突链,将运行时间锁定在硬实时常数内。
:::
