
Lec 4分治法:van Emde Boas 树
Lec 4 分治法:van Emde Boas 树(Divide & Conquer: van Emde Boas Trees)
TL;DR
- 突破比较模型下界:在有界全集 内,利用整数位结构绕开基于比较的 操作下界,将优先队列的核心操作加速至 。
- 递归簇分解思想:将规模为 的全集划分为 个大小为 的簇,将待查键解耦为高位簇号 与低位偏移 。
- 极值独立缓存与单次递归收敛:通过在每个节点独立缓存
min与max(且min不下沉存储到任何子簇中),确保插入、删除与后继查询在递归中至多触发一次规模为 的子调用,满足 。 - 空间紧凑化:将全集指针数组优化为散列表动态分配,空间消耗从 压缩至 。
突破比较排序下界与问题背景
在经典数据结构(二叉搜索树、AVL 树、红黑树、斐波那契堆)中,元素大小仅能通过两两比较确定。由于排序下界为 ,任何基于比较的动态优先队列(支持插入、删除、查找后继)至少有一项操作必须耗费 时间。
然而在计算机系统实际场景中,关键字往往落在固定位宽的有界整数域中(例如 32 位或 64 位 IPv4/IPv6 路由前缀)。此时我们可以在有界全集 内维护 个动态元素。
Peter van Emde Boas 于 1975 年提出的 van Emde Boas 树(vEB 树),能以 最坏时间复杂度同时支持:
Insert(x):插入元素Delete(x):删除元素Successor(x):寻找大于 的最小元素Predecessor(x):寻找小于 的最大元素Member(x):判定 是否存在
当全集规模 (多项式阶)时,操作时间为 ,在渐近速度上相比平衡二叉搜索树实现了指数级跃迁。
演进之路:从位向量到原型 vEB 结构
朴素位向量(Bit Vector)
维护一个长度为 的布尔数组 :若 则 ,否则为 。
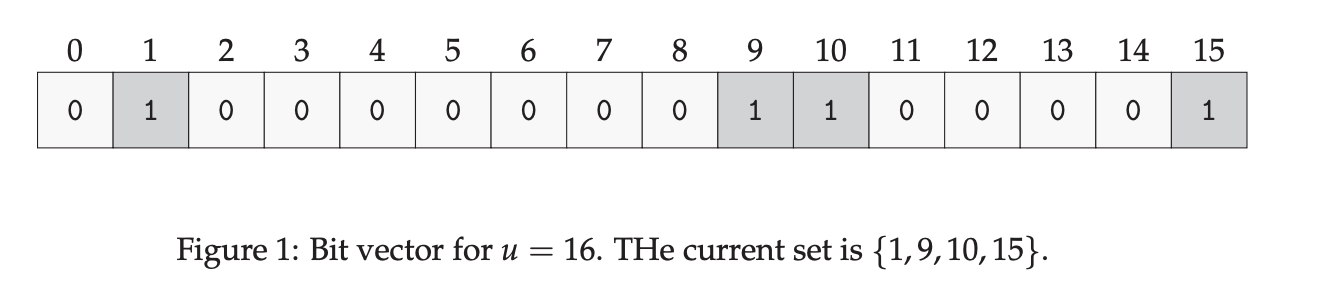
Insert / Delete:翻转对应二进制位,耗时 ;Successor / Predecessor:需向后/向前顺序扫描位向量,最坏耗时 。
分块与平方根划分
将范围 划分为 个连续的簇(Cluster),每个簇包含 个元素。任意数值 可唯一拆解为:
- 簇号:
- 簇内偏移:
- 逆映射:
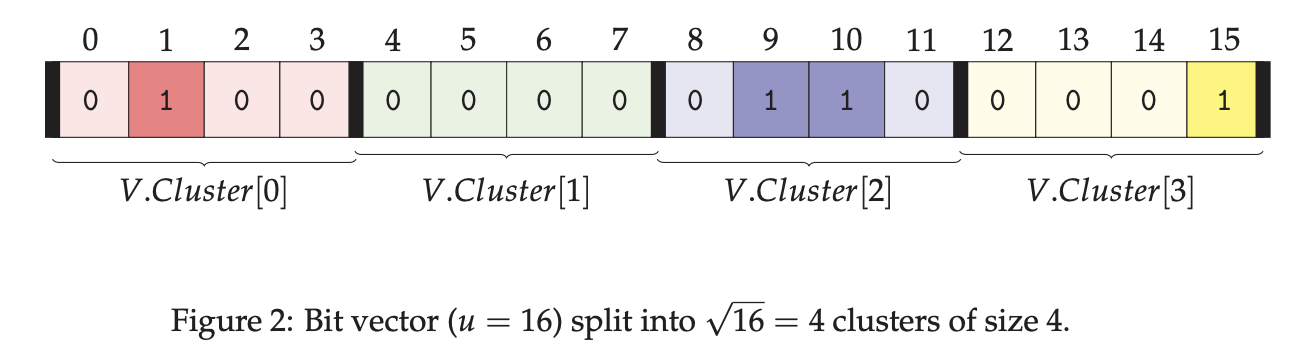
为了避免在空簇中盲目扫描,增设一个大小为 的摘要结构(Summary),其中 当且仅当第 个簇非空。
查找 的后继:
- 首先在簇 内查找是否存在大于 的元素(耗时 );
- 若不存在,在 中查找下一个非空簇 (耗时 );
- 在簇 中找到最小的元素 (耗时 );
- 返回 。
操作复杂度从 降至 。
原型 vEB 的递归瓶颈
若将 和各 本身也递归定义为规模为 的分块结构:
- 在朴素递归实现中,
Successor在最坏情况下需要递归查询当前子簇、递归查询 、再递归查询目标子簇,递推式为: 令 ,得 ,故 。 - 朴素
Insert需要同时插入子簇与更新 ,递推式为 。 由于递归调用分支数大于 1,仍然无法达到 。
终极 vEB 树设计:极值缓存与单分支递归
要实现 ,核心法则必须是:任何操作在递归树的每个节点至多只能触发一次对子结构的递归调用。
核心不变量与极值缓存
vEB 节点包含以下域:
- :全集大小(通常为 )
- :当前结构中的全局最小值
- :当前结构中的全局最大值
- :大小为 的 vEB 指针
- :大小为 的 vEB 节点指针数组
定理
vEB 极值存储不变量 元素仅被保存在当前节点的 字段中,绝不下沉存储到任何一个子簇 中;而 元素虽然记录在当前节点的 字段中,但它依然会正常保存在其对应的子簇中。
正是这条不对称的不变量,成就了 vEB 树惊人的效率:
- 空簇插入无需递归:当一个子簇为空时,向其插入元素只需将其 与 直接赋值为该元素即可完成初始化,耗时 ,无需进一步向下递归!
- 快速极值定位:获取子簇极小值仅需读取 ,耗时 。
后继操作(Successor)
查询后继操作 Successor(V, x) 的核心目标是在集合中寻找严格大于 的最小元素。朴素递归往往需要先在子簇中找,找不到再去摘要找,造成多次分治分支。而在终极 vEB 树中,我们借助子簇的 max 缓存实现了精确剪枝:在进入子簇之前,先花费 时间比对当前偏移 是否严格小于该簇的最大值 。若小于,则后继必定位于该子簇内部;若不小于,则该簇内绝无可能存在合法后继,我们直接转向 寻找下一个非空簇。
def Successor(V, x):
    if V.u == 2:
        if x == 0 and V.max == 1:
            return 1
        return None
    elif V.min is not None and x < V.min:
        return V.min

    # 获取高低位
    h, l = high(x), low(x)
    max_in_cluster = V.cluster[h].max if V.cluster[h] is not None else None

    # 核心分支判断:后继是否在同一个子簇内?
    if max_in_cluster is not None and l < max_in_cluster:
        # 只在当前子簇递归 1 次
        offset = Successor(V.cluster[h], l)
        return index(h, offset)
    else:
        # 否则在 summary 中递归 1 次找到下一个非空簇
        succ_cluster = Successor(V.summary, h)
        if succ_cluster is None:
            return None
        # 直接通过 min 读取该簇的最小元素(O(1),无额外递归!)
        offset = V.cluster[succ_cluster].min
        return index(succ_cluster, offset)
在执行过程中,整个函数严格保证只执行一次递归调用:
- 递归基处理:当全集大小退化至 的位基元时,直接通过简单位逻辑判断返回,无需分治;若 小于当前结构中全局记录的 ,则后继就是 。
- 簇内递归路径:若 ,直接调用
Successor(V.cluster[h], l),本次查找完毕; - 跨簇跃迁路径:若 ,通过
Successor(V.summary, h)递归定位下一个包含元素的簇号succ_cluster。由于该簇的最小值直接记录在其根部字段min中,无需再次递归深搜,直接读取并拼接下标即可。
因此,单次后继操作的递推关系严格受限于单分支递归:
插入操作(Insert)
插入操作 Insert(V, x) 的难点在于维持两个相互依赖的组件:既要将元素存入对应的子簇,又要在子簇首次非空时向 summary 注册簇号。若两项操作均向下递归,递归式将退化为 。
终极 vEB 树利用极值缓存不变量化解了这一矛盾:如果当前待插入的子簇此前完全为空,我们只需在 summary 中递归注册该簇号,而子簇本身只需要将其局部 min 和 max 直接置为该元素( 赋值,绝不再向下递归!);反之,若子簇已经包含元素,说明该簇在 summary 中早已完成注册,我们只需向子簇递归插入一次,完全无需触碰 summary。
def Insert(V, x):
    # 结构为空,直接常数时间初始化
    if V.min is None:
        V.min = V.max = x
        return

    # 若插入值小于当前最小值,将 x 换为新的 min,原 min 下沉插入子簇
    if x < V.min:
        x, V.min = V.min, x

    if V.u > 2:
        h, l = high(x), low(x)
        # 若子簇此前为空,说明 summary 中尚未标记此簇
        if V.cluster[h].min is None:
            Insert(V.summary, h)      # 递归更新 summary
            # 下沉插入空簇耗时 O(1),无深层递归!
            V.cluster[h].min = V.cluster[h].max = l
        else:
            # 若子簇非空,summary 早已标记,只需递归插入该子簇
            Insert(V.cluster[h], l)

    if x > V.max:
        V.max = x
通过这一精巧安排,插入过程在任何时刻都只进入两个互斥分支之一:
- 首次建簇分支:仅调用
Insert(V.summary, h)(1 次递归); - 已存簇分支:仅调用
Insert(V.cluster[h], l)(1 次递归)。 全局max的更新仅需在递归归并时进行常数时间的比较和替换。因此插入操作同样满足:
- 若子簇此前为空:
Insert(V.summary, h)递归一次,而向空子簇写入只修改指针与极值(); - 若子簇此前非空:
Insert(V.cluster[h], l)递归一次,无需触碰summary。 两种情况互斥,递归调用次数恒等于 1,满足 。
删除操作(Delete)
删除操作同样利用 字段的特殊地位:
- 若被删元素为当前节点唯一的元素,直接置空;
- 若删除的是 ,需要从第一个非空子簇中取出最小值提升为新的 ,然后在该子簇中删除该元素;
- 递归删除该元素后,若该子簇变为空,则在 中删除该簇号;
- 若删除的是 ,通过 与对应子簇在 内更新 。
递归依然至多进入一次子结构,整体运行时间为严格 。
空间复杂度优化
朴素 vEB 树为每个节点静态分配 长度的指针数组。整棵树占用的空间递推关系为:
当 时, 存储空间无法在物理内存中实现。
动态散列压缩
- 惰性分配(Lazy Allocation):仅在子簇非空时分配对应节点;
- 哈希表替代静态数组:使用两级完美哈希或 cuckoo hashing 存储非空的子簇指针。 动态构建的 vEB 树空间消耗降为 。配合基于前缀树压缩的 y-fast trie 技术,空间可进一步压缩至严格 。
我的理解
vEB 树是计算机体系结构与高级算法设计高度共鸣的艺术品:
- 分治对象的升维转换:标准二分查找是对 个已排序元素按数量对半切分,单步递归深度为 ;而 vEB 树是对**二进制位宽(Bit Length)**按半切分,在 维的位空间上执行二分搜索,从而将复杂度推进至 。
- 不对称设计带来的单分支奇迹:原型 vEB 树之所以被困在 ,是因为对称地对待了所有元素。终极 vEB 树创造性地将
min悬空在子簇之外,这一看似微小的不对称性,彻底消除了“既要建簇又要填摘要”的双重递归瓶颈。 - 硬件路由与极速分派:vEB 的核心映射 与 在底层就是位移(Bit Shift)与位掩码(Bit Mask)操作,无任何乘除开销,使得这种理论神级结构在硬件转发流水线中具有无与伦比的工程亲和力。 :::