
Lec 10如何对概念编码:与 LLM 共享上下文
Lec 10 如何对概念编码:与 LLM 共享上下文
学习目标
- 使用 LLM 编码的现在和未来
- 协作的本质:管理上下文
- 概念的实现及其兼容性
TL;DR
- LLM 的错误可以区分为 Hallucination 与 Confusion:前者忽略上下文中已有的证据,后者源于信息缺失、组织混乱或处理能力不足。
- Context Engineering 的重点不是微调一句 Prompt,而是识别、筛选并组织模型完成当前任务真正需要的知识、约束、示例和工具结果。
- Concept Design 把软件的目的、状态、动作和原则组织成可独立实现的知识单元,从而弥合 Code 与 Design Intent 之间的 Context Gap。
哪些能力仍然是人的核心工作?
假设人工智能助手已经变得和最优秀的人类软件工程师一样优秀, 并且能够无限制地访问互联网资源。 使用人工智能进行编码意味着什么?
- 我们不再需要哪些现有的实践和技能?
- 哪些实践和技能会保留下来,甚至可能变得更加重要?
可能逐渐不重要的:
syntax familiarity:记住语言语法specific APIs:记住某个框架/API 怎么调用,甚至部分算法实现prompt engineering:反复琢磨“这句话怎么写 AI 才听得懂”wireframing:大量手工把想法画成具体界面
反而更重要的:
- 理解用户视角: 用户到底有什么问题?真正需要什么?
- 从新的情境中发现人的需求: 当世界发生变化时,能不能发现过去不存在的新问题?
- 适应并演化既有方案:不是简单复制现有产品,而是知道在新的用户、环境和限制下应该如何调整。
假设未来所有人都能这样:一句话描述需求,AI 一次就把完整软件做出来。那么....
- 做出来的软件真的有人需要、真的有价值吗?
- 当所有人都能轻松做软件,你凭什么与别人不同?
- 你作为人的主动性和决定权体现在哪里?你选择解决什么问题、做什么判断、推动什么改变?
弥合差距
课程把模型“答错”进一步拆成两个不同问题:
- Confusion(混淆 / 犯错):模型因为知识、训练、记忆或信息不足而得到错误答案。模型容量有限,人类其实也会犯类似错误。
- Hallucination(真正的幻觉):上下文中已经提供了足够证据,模型却仍然违背这些证据,仿佛“当着你的面否认现实”。
随着技术进步,真正的 Hallucination 有望大幅减少;但由于缺少信息、上下文或能力造成的 Confusion 不可能完全消失。前者主要取决于模型技术进步,后者则是我们在设计 AI 系统时可以主动管理的问题。
常见的 Confusion 包括:记错事实;弄错参数、语法或 API;正确执行了代码却实现了错误的需求;以及面对大量、复杂甚至冲突的指令时 losing the plot——逐渐忘记最初目标、抓错重点。
这也引出了后面的 susceptible model:不同模型对不同类型的 Confusion 有不同敏感程度,因此选择模型时不能只看总体能力,还要看它是否容易在你的具体任务上犯错。
因此,和 LLM 协作的重点会从“避免幻觉”逐步转向 管理上下文(context engineering)。
人与 LLM 共有的上下文失败模式
信息过载
当信息量和复杂度超过处理能力时:
- LLM 会发生 上下文稀释(context dilution):关键要求被大量无关信息稀释。
- 人会受到认知负荷(cognitive load) 限制。
认知负荷可分为:
| 类型 | 含义 | 对 LLM 上下文的启示 |
|---|---|---|
| 内在负荷(intrinsic) | 完成任务本身不可避免的复杂度 | 确保完整放入上下文中,不要遗漏。 |
| 外在负荷(extraneous) | 与任务无关、分散注意力的信息 | 尽可能压缩、减少。 |
| 促进性负荷(germane) | 将新问题与已有知识联系起来所需的理解工作 | 通过 Few-shot、模型画像等方式提供,并随着使用不断积累优化。例如提供几个高质量示例,让模型理解期望的模式和输出。 |
我的理解
Context 管理原则:必要信息给完整,无关信息尽量少,有助于模型理解任务的信息则通过示例和持续学习来强化
信息分裂
信息被分散在多条消息、多个文件或多个页面时:
- LLM 可能难以跨多轮对话稳定保持关键约束;
- 人类也会遇到 分散注意效应(split-attention effect):需要在多个位置来回寻找并拼接信息。
课件引用的研究指出,任务从单轮转为多轮对话时,模型表现可能显著下降。
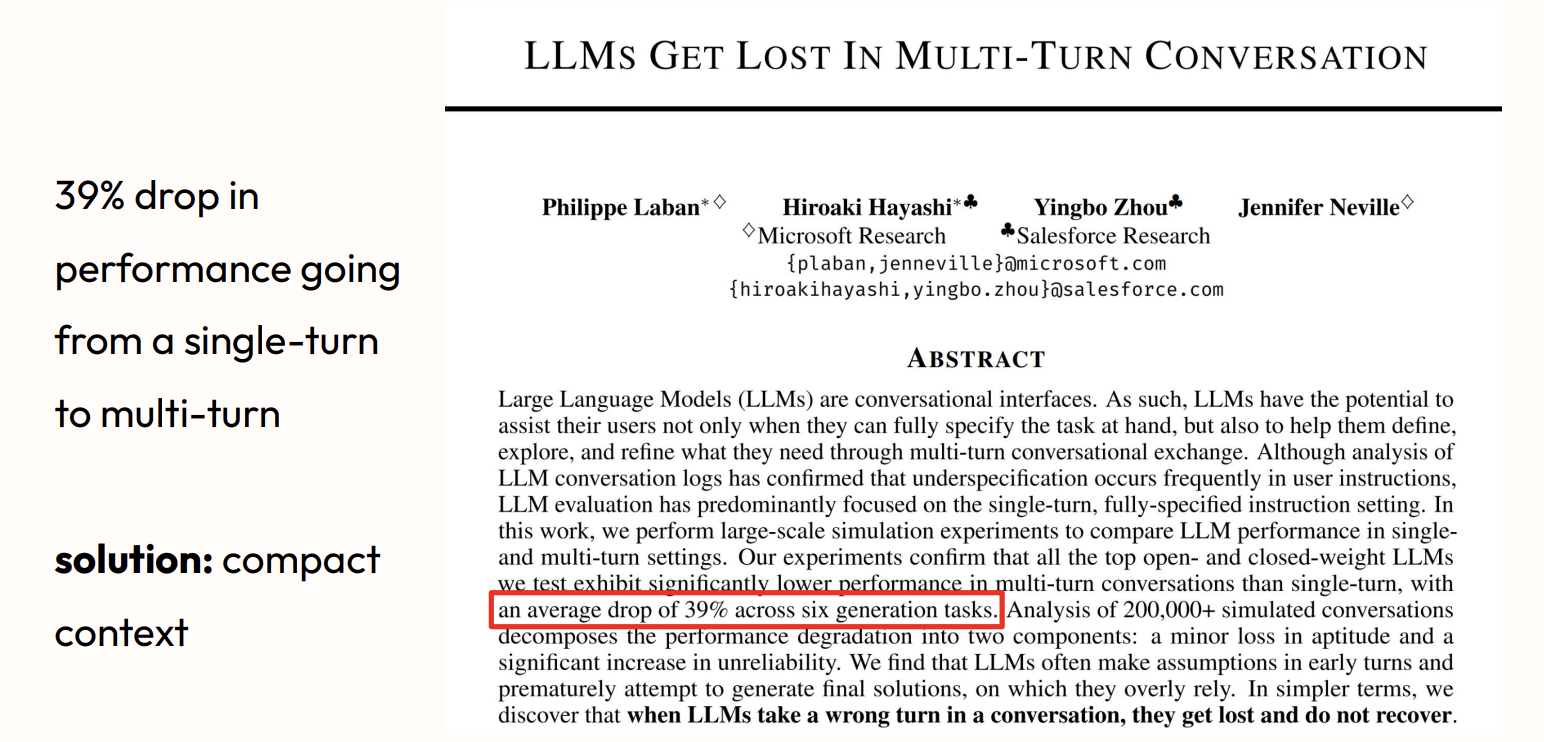
应对方式:压缩上下文。
把当前任务真正需要的设计背景、接口、约束、示例和验收条件集中到一个可读、可版本控制的上下文文档中,而不是期待模型从漫长聊天记录里自行找出重点。
固着性:被过早的锚定
- LLM 可能被系统提示词、早期指令或错误假设锚定,持续沿着错误方向回答。
- 人类也有 锚定效应(anchoring effect):过度依赖最先获得的信息或最初方案。
因此应明确区分“不可改变的约束”和“可质疑的假设”,并允许模型与人重新检查早期判断。
上下文工程
从提示词到上下文工程
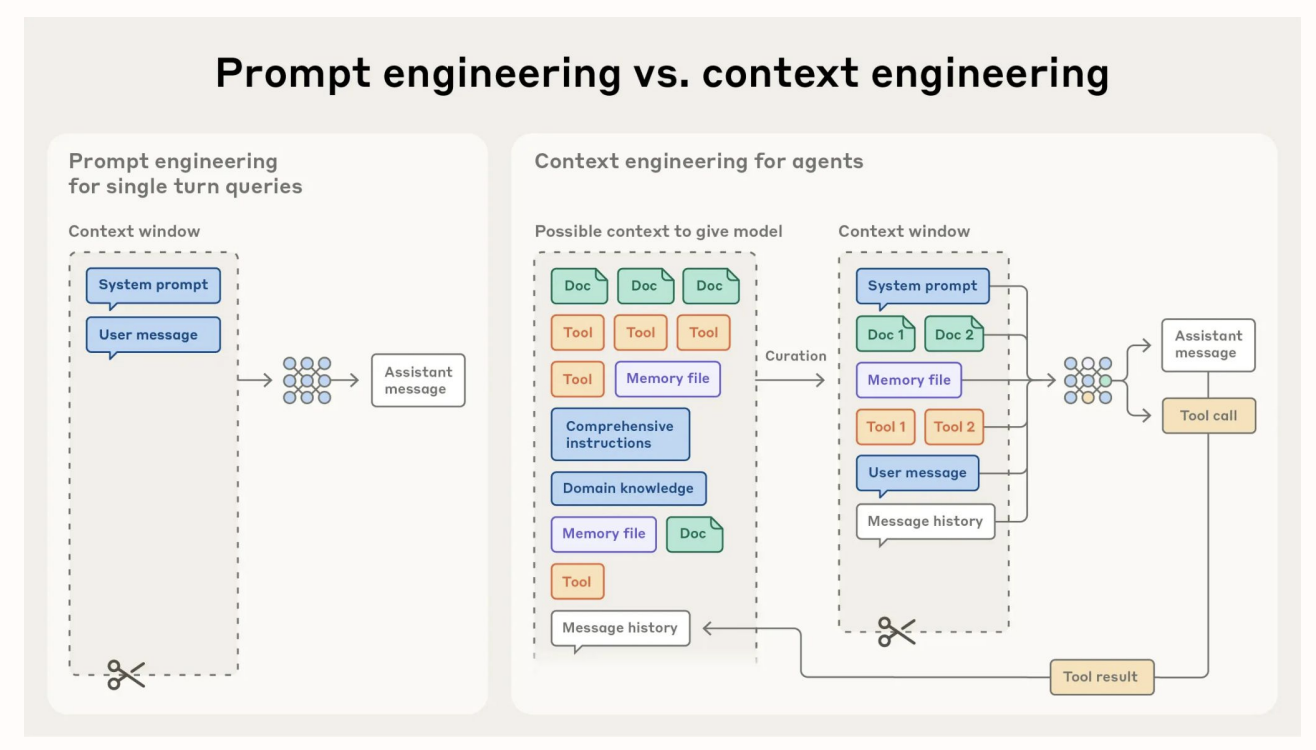
随着 AI 从单轮问答发展到长期运行的 Agent,重点正在从 提示词工程(Prompt Engineering)转向 上下文工程(Context Engineering)。
Prompt Engineering 主要关注“这一句话应该怎么写”,通常是:
System Prompt + User Message → Model → Response而 Agent 面对的 Context 要复杂得多:除了 Prompt,还可能包含文档、工具、Memory、领域知识、历史消息和工具执行结果等。由于 Context Window 是有限资源,关键不再是把所有信息塞进去,而是持续决定:模型此刻应该看到什么、不应该看到什么,以及如何组织这些信息。
上下文工程的核心
可以把 Context Engineering 理解为:
为模型识别、筛选、组织和动态提供完成当前任务真正需要的信息。
它主要包含三个过程:
- 识别重要信息:哪些知识、假设、用户请求、历史、工具和数据与当前任务有关。
- 拆分信息:不要把所有东西混在一个巨大 Prompt 或聊天记录中,而是将知识、Memory、Instructions、Tools 等作为不同的信息来源管理。
- 重新组合:根据当前任务,从这些来源中选择最相关的信息,构造当前 Context。
因此它和前面的 上下文过载 原则可以直接连起来:
内部信息完整保留;外部信息尽量压缩;促进性信息通过示例、Memory、模型画像等有选择地加入。
当前的问题:Context 是“隐藏”的
今天很多 AI 产品虽然已经自动进行 Context Engineering,但用户很难看到它到底在做什么。Context 往往埋在冗长的聊天记录、工具自行构造的 Prompt,以及系统自动管理的 Memory / Tool Results 中。
结果是用户很难回答:
模型现在到底知道什么?
为什么记住了这个,却忘了那个?
哪些信息正在占用 Context?
这次回答究竟参考了哪些信息?
大家都在强调上下文工程,却缺乏让用户查看、理解和控制 Context 的好工具。
设计的本质
老师主张管理好上下文就是设计的本质,这一个部分最重要的观点。
构造 Context 实际上就是:
找出什么重要 → 把复杂信息拆开 → 按有意义的方式重新组合。
老师认为这和设计本身的核心过程非常相似。而且它可能比 Prompt、代码甚至具体 AI 模型更持久:模型越来越强,很多实现工作会被自动化,但决定哪些知识、假设和需求重要,以及如何组织它们仍然需要设计判断。
我的理解
核心:Prompt Engineering 优化“怎么对 AI 说”;Context Engineering 设计“AI 在做这件事时应该知道什么”。随着 Agent 复杂度提高,后者会越来越重要。
上下文工具:把上下文变成可管理的 Artifact
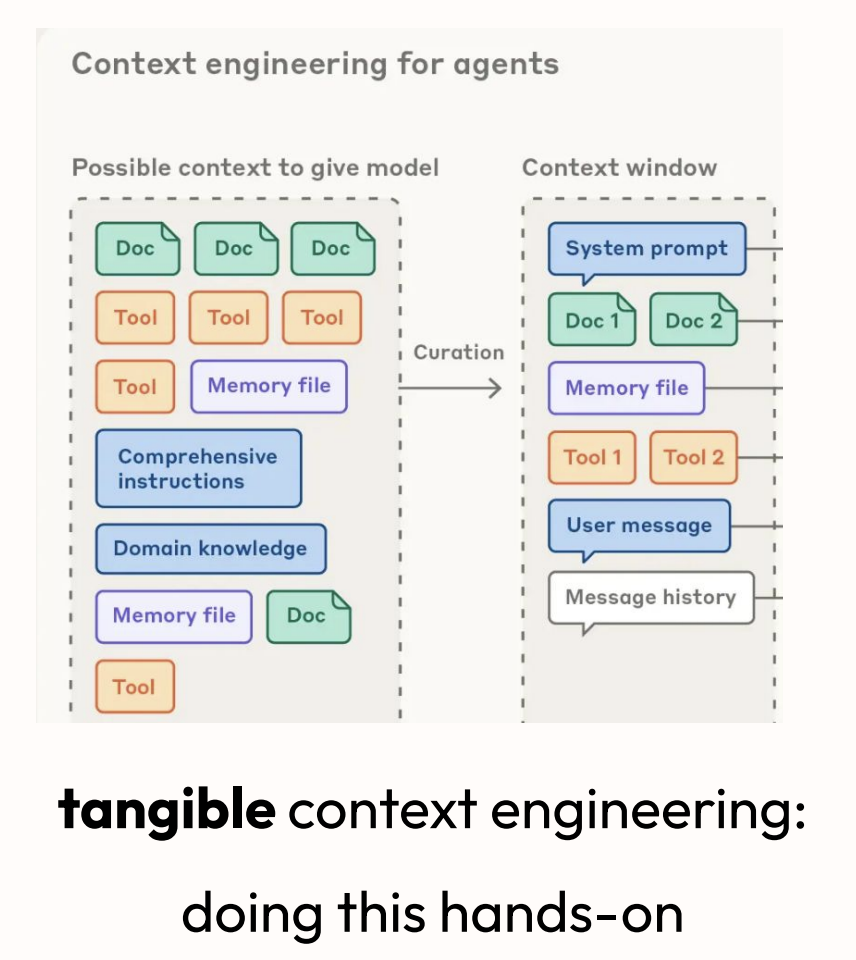
基本机制:一个 Markdown 文档代表一次完整的 Context,不需要特殊语法:
ctx prompt file.md需要引入其他资料时,直接通过 Markdown 链接引用,并在描述名前加 @:
[@prompt.md](prompt.md)
[@MyConcept.ts](/src/MyConcept.ts)
这样可以把原本散落在代码、文档、Prompt 等位置的信息组合成一个明确的 Context。其总体目标为
- 可读 / 可检查:能直接看到一次 LLM 调用获得的完整上下文。不再需要猜“AI 到底看到了什么”。
- 语义模块化(Semantically modular)。Context 不等于一个巨大 Prompt,而是由具有明确意义的模块组成。例如:
design/
background/
requirements/
concepts/
这些内容同时可以作为人类文档和 LLM Context,避免“给人看的文档”和“给 AI 的 Prompt”维护两套。
- Version controlled — 可版本控制:因为 Context 本质上是 Markdown + 文件,所以可以进入 Git:修改、比较、回滚、实验不同 Context 都变得很自然。
Concept 实现——TS 为例
将一个概念放在单一 TypeScript class 中,且不得 import 其他概念。每个方法要么是动作,要么是查询:动作的输入/输出使用 record;查询以 _ 开头,并返回 record 数组(即使当前只预期一个结果,也保留“可能有多个”的语义)。这套约定不是语法洁癖,而是把模块边界变成 AI 和人都看得见、可检查的事实。
type Empty = Record<PropertyKey, never>;

export class CounterConcept {
  count = 0;
  increment(_: Empty): Empty {
    this.count++;
    return {};
  }

  _getCount(_: Empty): { count: number }[] {
    return [{ count: this.count }];
  }
}
可以把整个实现规范压缩成:
| 结构 | 规则 |
|---|---|
| Concept | 一个 TypeScript class |
| Independence | 不 import 其他 Concept |
| Method | 只能是 Action 或 Query |
| Action | 输入 Record → 修改状态 → 输出 Record |
| Query | _ 开头,只查询状态 |
| Query output | Record[],永远是数组 |
| Empty | Record<PropertyKey, never> |
课程实现采用:
- Deno:简单、一体化的 TypeScript Runtime
- MongoDB:Document Database,用于持久化 Concept State
不过这里真正要学的并不是 Deno 或 MongoDB 本身,而是这个实现映射:
Concept Spec                    TypeScript Implementation

State       ───────────────→    class fields / persistent storage
Action      ───────────────→    normal method
Query       ───────────────→    _method() → Record[]
Concept     ───────────────→    independent class
Composition ───────────────→    Synchronization
核心:每个 Concept 是一个完全独立的状态与行为单元;Action 改变状态,Query 暴露状态,Concept 之间不直接依赖,而由 Sync 在外部组合。
这就是前面 Concept Design 从 设计语言 真正落到 代码架构 的地方。
为什么还需要 Concept
这一部分是在把前面的 Concept Design、Context Engineering 和 LLM 串起来。核心问题是:既然 AI 已经能直接读写代码,为什么还需要 Concepts?
1. Concept 提供更好的软件粒度
Granular(细粒度):可以一个 Concept、一个 Action 地逐步设计和实现软件。
Concept
├── State
├── Action
├── Query
└── Purpose / Principle
相比“一次生成整个系统”,Concept 是一个有明确边界和意义的构建单元,因此更容易逐步开发、修改和理解。
2. Concept 不只是 OOP 结构,而是带有 Purpose 的知识单元
普通 class 更多表达:
代码在结构上是什么。
Concept 还表达:
这个行为为什么存在、用户如何理解它、它解决什么问题。
一个熟悉的 Concept 名称可以天然唤起更多背景知识。
3. Code 只表达了软件的一半
传统上,我们容易把软件理解为“能够编译和运行的代码”。
但在 LLM 时代,语义(Semantic)越来越重要:注释、文档、Purpose、设计意图虽然不会直接执行,却能帮助人和 AI 理解“为什么代码是这样的”。
过去注释可能只是辅助材料;当 LLM 直接读取整个代码库时,这些语义信息会成为模型的 Context,直接影响它生成和修改代码的方式。
4. Concepts 弥补了 context 的差距
只有 Code,不足以完整表达软件。
OOP、React 等主要告诉我们软件的结构:
class
function
component
module
dependency
但仅看这些,很难知道:
为什么存在这个功能?
用户认为它是什么?
它应该遵循什么行为原则?
修改它会不会破坏原本的设计意图?
Concept 则把这种设计理解显式组织起来:
Purpose
   ↓
Concept
├── State
├── Actions
├── Queries
└── Principle
   ↓
Implementation
因此 Concept 成为连接 Design Context ↔ Code 的桥梁。
5. LLM 让这种做法变得更有价值
以前程序员必须把设计最终“翻译”为非常精确的代码,所以代码往往成为最主要的 artifact。
LLM 出现以后,我们可以更多地在**设计层级(level of design)**工作:
人
↓
Concept / Purpose / Principle
↓
提供结构化 Context
↓
LLM
↓
Implementation
Concept 就成为一种很适合提供给 LLM 的 granular building block(细粒度构建块):既足够抽象,可以表达设计意图;又足够具体,可以映射到 State、Action、Query 和代码。
我的理解
核心:Code 告诉 AI“软件现在是怎么实现的”,Concept 告诉 AI“这个软件本质上在做什么、为什么这样做”。在 LLM 时代,Concept 可以把原本缺失的设计语义变成 Context,让人和 AI 都能在设计层级理解和修改软件。