
Lec 16后端设计
Lec 16 后端设计
本节目标:
- 巩固 理解异步请求对 Web 应用的核心意义,以及为什么客户端侧的同步还不够
- 记忆 掌握列表函数式(filter / map / reduce)这一重要编程范式
- 联系 理解关系型数据库(SQL)与集合型数据库(MongoDB)的操作异同
- 理解 明白同步中
where子句的工作原理:对 frames 列表的函数管道处理
TL;DR
- 异步请求使页面能在网络往返期间继续交互,但也引入 loading、失败、竞态和客户端陈旧状态;服务端仍必须独立完成身份、权限和输入校验。
filter、map与reduce提供了描述数据变换的共同语言,SQL 查询和 MongoDB 聚合管道可理解为对相同思想的不同数据模型实现。- Sync 的
where子句把 frames 视为绑定集合:查询逐步扩展、过滤或投影这些绑定,再由后续动作消费匹配结果。 - 部署把前端、后端、API 基址和 Sync 执行链放进真实网络环境;可访问 URL 与 trace 共同验证系统不仅能构建,还能端到端运行。
异步请求重要性
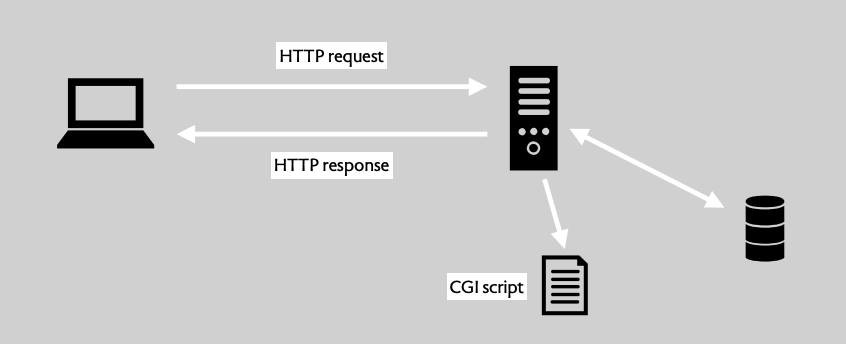
在 Web 的早期时代(1991–1993), 使用 CGI(1993)通过 HTTP 请求触发服务端脚本,但客户端在整个过程中处于阻塞状态。
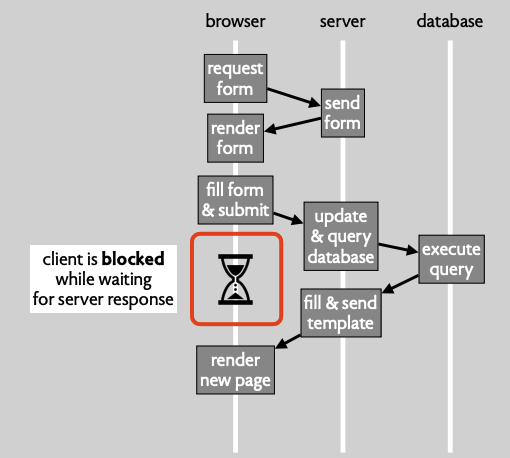
传统的多页面应用的请求流程:
- 浏览器发起 Get 表单单页
- 服务器渲染并返回表单 HTML
- 浏览器用户填写表单并提交
- 浏览器阻塞: 等待服务器处理,用户无法操作页面
- 服务器写库+查询+填充模板 → 返回新页面
- 浏览器渲染新页面,交互恢复
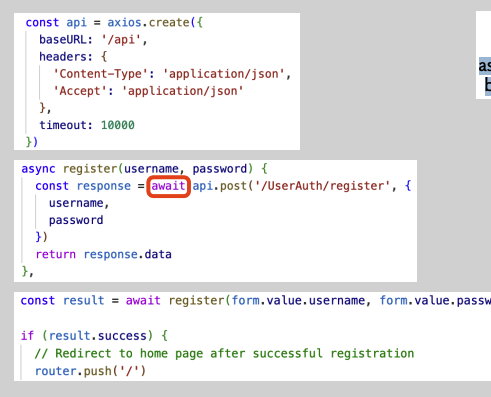
1998 年,微软引入 AJAX(asynchronous Javascript and XML), 后被所有浏览器标准化。 允许在页面脚本内部向服务器发出请求,无需重载页面。
客户端代码
var xhr = new XMLHttpRequest();
xhr.open("GET", "example.txt", true);
xhr.onreadystatechange = function() {
  if (xhr.readyState === 4 && xhr.status === 200) {
    console.log(xhr.responseText);
  }
};
xhr.send();
发送 POST 请求的客户端代码
var xhr = new XMLHttpRequest();
xhr.open("POST", "/submit", true);
xhr.setRequestHeader("Content-Type", "application/x-www-form-urlencoded");
xhr.send("name=Daniel&message=Hello");
如果放在今天,这个代码就是
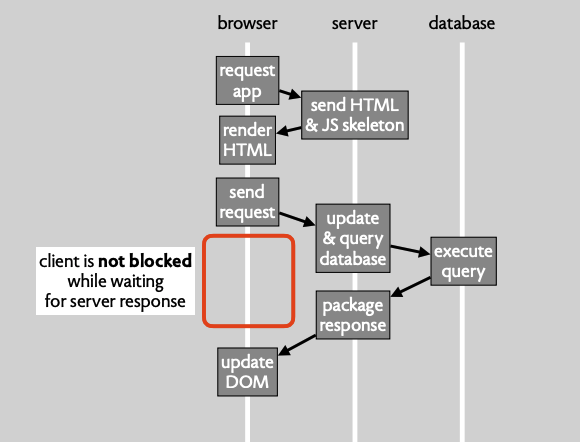
单页应用(SPA)的流程
- 浏览器请求 HTML+JS 骨架
- 渲染页面,用户可立即交互
- 后台异步拉取数据
- 收到响应后更新 DOM(不阻塞)
什么放在客户端,什么放在服务端
浏览器中的代码和数据对用户完全可见、可修改(通过开发者工具或控制台)。用户可伪造任意 HTTP 请求。 下面哪些是好的策略呢?
❌ 在 URL/请求中传递用户名 → 任何人都能伪造他人数据,不安全
❌ 使用自增 Session ID 存入 Cookie → 可被枚举猜测,不安全
❌ 必须先经过登录页才能访问敏感页面 → 本质上是一种客户端导航约束。 不安全
✅ 生成随机 Session ID 存入 Cookie → 无法被猜测,推荐做法
性能考量
| 指标 | 更多数据在客户端 | 更多数据在服务端 |
|---|---|---|
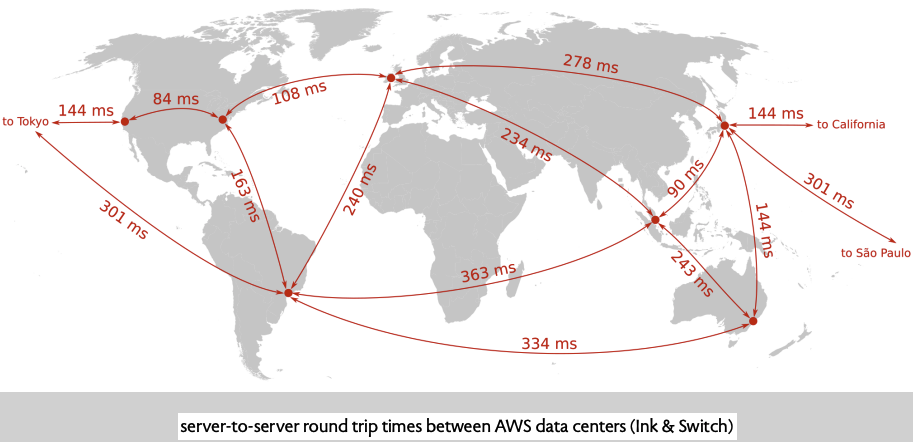
| 查询速度 | 快(本地) | 慢(网络往返) |
| 本地存储占用 | 高 | 低 |
| 初始启动时间 | 慢 | 快 |
| 离线可用性 | 支持 | 不支持 |
| 多客户端扩展 | 难 | 易 |
| 隐私风险 | 高 | 低 |
下图是 AWS 数据中心之间的往返时间
列表函数式
给定 users 数组(含姓名、是否活跃、消费记录),要求输出所有活跃用户及其消费总额。
下面三个高阶函数分别表达“保留哪些元素”“把每个元素变成什么”和“如何把多个元素汇总成一个结果”。先读懂它们各自的输入输出类型,再看组合后的数据流,会比从循环变量入手更容易验证意图。
// filter — 过滤,保留满足条件的元素
filter(arr, predicate: T => boolean): T[]
// 例:filter(a, e => e % 2 === 1)  // [1, 3]

// map — 映射,对每个元素做变换
map(arr, f: T => U): U[]
// 例:map(a, x => x * 2)           // [2, 4, 6]

// reduce — 归约,将数组折叠为单一值
reduce(arr, f: (acc, e) => T, init: T): T
// 例:reduce(a, (acc, e) => acc + e, 0)  // 6
传统命令式写法 vs 函数式写法
// 传统写法(for 循环)
const result = [];
for (const user of users) {
  if (!user.active || ...) continue;
  let total = 0;
  for (const p of user.purchases)
    total += p;
  result.push({ name, total });
}

// 函数式写法(更清晰)
const result = map(
  filter(users, u => u.active),
  u => ({
    name: u.name,
    total: reduce(
      u.purchases,
      (acc, p) => acc + p, 0)
  })
);
函数式写法将"做什么"(过滤 → 映射 → 归约)与"怎么做"(循环细节)分离,结构更清晰,意图更明确。
从类型流看,第一步把 User[] 缩小为活跃用户,第二步仍逐个处理 User,第三步才把每位用户的 purchases 折叠成一个金额。每一步都能单独测试,且中间结果可以打印检查;命令式循环虽然能得到同一结果,却把筛选、遍历和累加共享在同一组可变变量中,更难定位错误属于哪一阶段。
这种写法不是为了追求更短,而是为了让组合结构与需求句子保持同序:“保留活跃用户,再为每人计算消费总额”。当转换包含异步请求、可能失败的解析或副作用时,仍要显式处理错误和执行顺序,不能把“使用高阶函数”误认为自动获得了纯函数或并发安全。
SQL 关系型查询
关系型数据库将数据表示为标量表,通过 JOIN、WHERE、GROUP BY 等操作进行查询。
SELECT u.name, SUM(p.amount) AS total
FROM users u
JOIN purchases p ON p.name = u.name
WHERE u.active = TRUE
GROUP BY u.name
ORDER BY u.name;各步骤对应:WHERE ≈ filter,SUM/GROUP BY ≈ reduce,JOIN ≈ map 展开关联表,ORDER BY 排序。
SQL 与列表函数式的对应关系
| 列表函数式 | SQL 等价 |
|---|---|
filter | WHERE 子句 |
reduce | 聚合函数(SUM、COUNT 等) |
map | 计算 JOIN(展开关联行) |
MongoDB 集合查询
MongoDB 使用聚合管道(Aggregation Pipeline)对集合进行链式操作,与函数式管道理念一致。
聚合管道中的每个 stage 都接收一组文档并产生下一组文档。阅读复杂查询时,可以逐步写出各 stage 之后的文档形状与数量:$match 改变数量,$lookup 增加关联数组,$unwind 可能把一条文档展开成多条,$group 再按键收拢。这样能同时检查字段路径和基数变化,避免只盯着最终结果猜错在哪一步。
规范化集合(Normalized)
规范化方案把用户与消费记录放在独立集合中,查询时通过 $lookup 建立关联,再把一对多结果展开并聚合。步骤较多,但每类事实只有一个主要存储位置,独立更新和复用更直接。
// Note:users + purchases两个独立集合
interface UserDoc {
  _id: string;
  name: string;
  active: boolean;
}

interface PurchaseDoc {
  _id: string;
  name: string;
  amount: number;
}

db.users.aggregate([
  { $match: { active: true } },          // filter
  { $lookup: {                            // JOIN
      from: "purchases",
      localField: "name",
      foreignField: "name",
      as: "purchases"
  }},
  { $unwind: "$purchases" },             // 展开数组
  { $group: { _id: "$name",
      total: { $sum: "$purchases.amount" } } }, // reduce
  { $project: { _id: 0, name: "$_id", total: 1 } },
  { $sort: { name: 1 } }
]);
这里的关键代价发生在 $lookup:消费记录可以独立写入和查询,但读取用户总额时必须跨集合关联。关联字段应有合适索引,且必须明确没有消费记录的活跃用户是否应保留;不同的 $unwind 选项会影响这类边界情况。规范化不是“查询一定更慢”的同义词,而是把写入一致性与读取组合成本做了明确交换。
这个示例用 name 做关联键只是为了说明管道形状,实际系统更适合使用稳定、不可变且有索引的用户标识。姓名可能重复或修改,把它直接当外键会让多个用户的消费记录被误合并,也会使改名变成跨集合迁移。数据模型应区分供人阅读的名称与供系统引用的标识,这也呼应 Lec 19 对 Simple Naming 和 Global Id 的区分。
还应先写清期望的结果语义:输出是否包含消费为零的活跃用户、金额是否允许负数、缺失字段如何处理、货币是否能直接相加。聚合语法只能执行已经决定的规则,不能替设计者补齐这些业务含义。先用几个边界文档手算每个 stage 的中间结果,再运行真实查询,通常比直接调试整条管道更稳妥。
嵌套集合(Embedded)
嵌套方案把消费记录直接放进用户文档,读取单个用户时更局部;聚合时仍需展开数组。它减少跨集合关联,却会让文档增长、并发写入和跨用户统计承担更多成本。
// Note:purchases 内嵌在 users 文档中
interface UserEmbeddedDoc {
  _id: string;
  name: string;
  active: boolean;
  purchases: { amount: number }[];
}

db.users.aggregate([
  { $match: { active: true } },
  { $unwind: "$purchases" },
  { $group: { _id: "$name",
      total: { $sum: "$purchases.amount" } } },
  { $project: { _id: 0, name: "$_id", total: 1 } },
  { $sort: { name: 1 } }
]);
嵌套版本省去了 $lookup,因为消费数据已经随用户文档一起读取;但每次新增消费都会改写同一用户文档,同一热点用户的并发写入也集中到一个位置。选择嵌套还是引用,应依据数据是否总被一起读取、子项数量是否有界、更新频率与一致性要求,而不是用“MongoDB 是文档数据库”直接推出所有关系都该嵌套。
嵌套写法更简洁,但为什么生产环境更推荐规范化?
- 关注点分离(Separation of Concerns)
- 减少写入冲突与锁竞争
在同步中使用查询
where 子句的核心理解:它是一个对 frames 列表的函数管道。Frame 不是数据库中的永久记录,而是一次 Sync 匹配过程中已经绑定的变量集合;前面的 when 产生候选 frames,where 再从概念状态中补充匹配条件。
一次查询可以产生三种效果:没有匹配时淘汰当前 frame;恰有一个匹配时扩展新的变量绑定;有多个匹配时把一个 frame 展开为多个 frame。连续查询因此近似 flatMap → filter → map 的组合,每一步都消费上一步的结果,而不是各自从空白上下文开始。
when 产生候选 frames
  → query A:按已有变量查状态,扩展或淘汰 frame
  → query B:使用 A 新绑定的变量继续关联
  → 条件过滤:只保留满足约束的 frames
  → then:对每个最终 frame 执行动作
这与 SQL 的 JOIN/WHERE、MongoDB 的 $lookup/$match 以及数组的 flatMap/filter 是同一类数据流。区别在于,Sync 查询的输出不是面向页面展示的结果表,而是决定哪些因果规则实例可以继续执行的绑定环境。理解这一点后,where 就不再是隐藏控制流,而是可检查的匹配管道。
我的理解
把 Sync 查询写成 frames 管道有一个重要收益:规则的“触发事实”和“补充事实”被分开表达,但仍通过显式变量绑定连接。调试时可以逐步检查每次查询让 frame 数量如何变化;若某条规则意外触发过多或完全不触发,问题会落在具体的扩展、过滤或关联步骤,而不是模糊的全局副作用。
配套 Recitation:应用部署
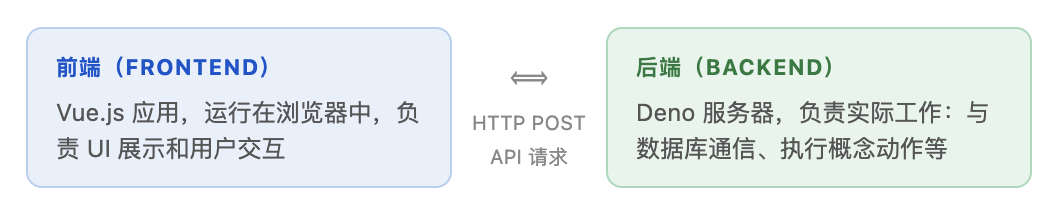
1. 架构回顾:前端与后端是两个独立程序
2. 后端 API 机制
2.1 概念文件结构
后端入口位于 backend/src/concept_server.ts, 自动扫描src/concepts/ 目录:
src/concepts/
├── ToDoList/
│   └── ToDoListConcept.ts
├── GiftRegistry/
│   └── GiftRegistryConcept.ts
每个子目录对应一个概念,目录内必须有一个 Concept.ts 文件。框架会自动扫描所有方法名,并为其创建对应的 API 路由,无需手动注册。
2.2 API Endpoint 格式
所有概念动作均以 POST 请求的形式暴露为 API 端点。 格式为
/api/<conceptName>/<actionName>

# conceptName = src/concepts/ 下的子目录名
# actionName = 该概念类中定义的方法名| HTTP 方法 | 端点路径 | 实际调用 |
|---|---|---|
POST | /api/ToDoList/addItem | ToDoListConcept.addItem() |
POST | /api/ToDoList/removeItem | ToDoListConcept.removeItem() |
POST | /api/GiftRegistry/addGift | GiftRegistryConcept.addGift() |
2.3 API Base 配置:开发环境 vs 生产环境
开发环境: vite.config.js 将所有 /api 请求代理到 http://localhost:8000/api,需先手动启动 Deno 后端
生产环境:部署后,前端将所有 API 请求指向 https://snoopy-backend.onrender.com/api/<concept>/<action>,后端永远在线,无需手动启动
3. 新版后端架构:加入 Syncs
3.1 新入口文件
旧入口: concept_server.ts — 仅处理概念直连,无 Syncs
新入口:your-backend/src/main.ts — 包含日志(Logging)、Requesting 概念、Syncs 三项能力
3.2 日志
后端默认打印每个动作的完整调用链(trace),便于在控制台查看哪些 Sync 被触发。提交作业时需附上 demo 视频对应的 trace 日志。
3.3 Requesting 概念:路由判断核心
位于 src/concepts/Requesting/RequestingConcept.ts,作为 API 请求服务器的封装层。路由分为两类:
- 直通路由(passthrough)
- 定义在
passthrough.ts的 inclusions 列表 - 服务器直接执行概念动作。
Concept.action({ inputs })- 返回值直接序列化为 JSON 发回前端
- 定义在
- Sync 路由(excluded)
- 定义在
passthrough.ts的 exclusions 列表 - 触发
Requesting.request({ path, inputs }) - 依次执行:Request Sync → Respond Sync
- 最终 JSON 响应返回前端
- 适合:需要多概念协调的复杂操作
- 定义在
配套作业:Assignment 4c — Project Complete
官方作业页:Assignment 4c。
这是 Assignment 4 系列(4a 后端概念 → 4b 前端界面 → 4c 完整项目)的最后一步,要求把前面独立完成的后端概念和前端界面,通过 Sync 引擎正式接到一起,并部署为一个公网可访问的完整应用——直接对应本讲"Rec 应用部署"里讲的前后端分离部署流程(前端指向 https://<backend>.onrender.com/api/...,后端持续在线)。验收标准包括:应用可通过公开 URL 完整跑通核心用户旅程,后端日志能打印出每次请求触发的 Sync 调用链(trace),且交付时需附带演示视频与对应的 trace 日志,证明 Sync 确实按预期被触发。