
Lec 19设计经验总结
Lec 19 设计经验总结
本节的目标:
- 将想法放入上下文 将课程中学到的各种思想放入更大的背景中理解——它们从哪里来,行业里其他人怎么使用
- 思想解耦 课程教的是一套完整方法,但这些思想可以独立应用——即使你的公司不采用完整的概念设计
TL;DR
- 概念设计与行业中的无头架构、模块化单体和事件驱动架构共享目标:让状态边界清晰、组合显式,并控制跨模块依赖。
- 反腐层把外部事件或模型翻译成服务自己的动作,是 Sync 在常见架构语言中的对应模式;它解耦实现,却不能消除 schema 与一致性成本。
- 视图分离、无界多态和抽象状态/动作可以独立使用:分别按目的拆分状态、避免对外部类型作结构假设,并以实现无关的状态转移描述行为。
- 概念是一种软件模式语言;命名、全局标识和命名空间解决不同问题,组合它们比寻找一个万能“名称字段”更可靠。
行业架构术语与概念设计的关联
我们所学的很多思想,在工作中用这些词可能没人听得懂。但这些想法其实在行业中有对应的 流行语(buzz phrases),下面逐一解读。
无头架构
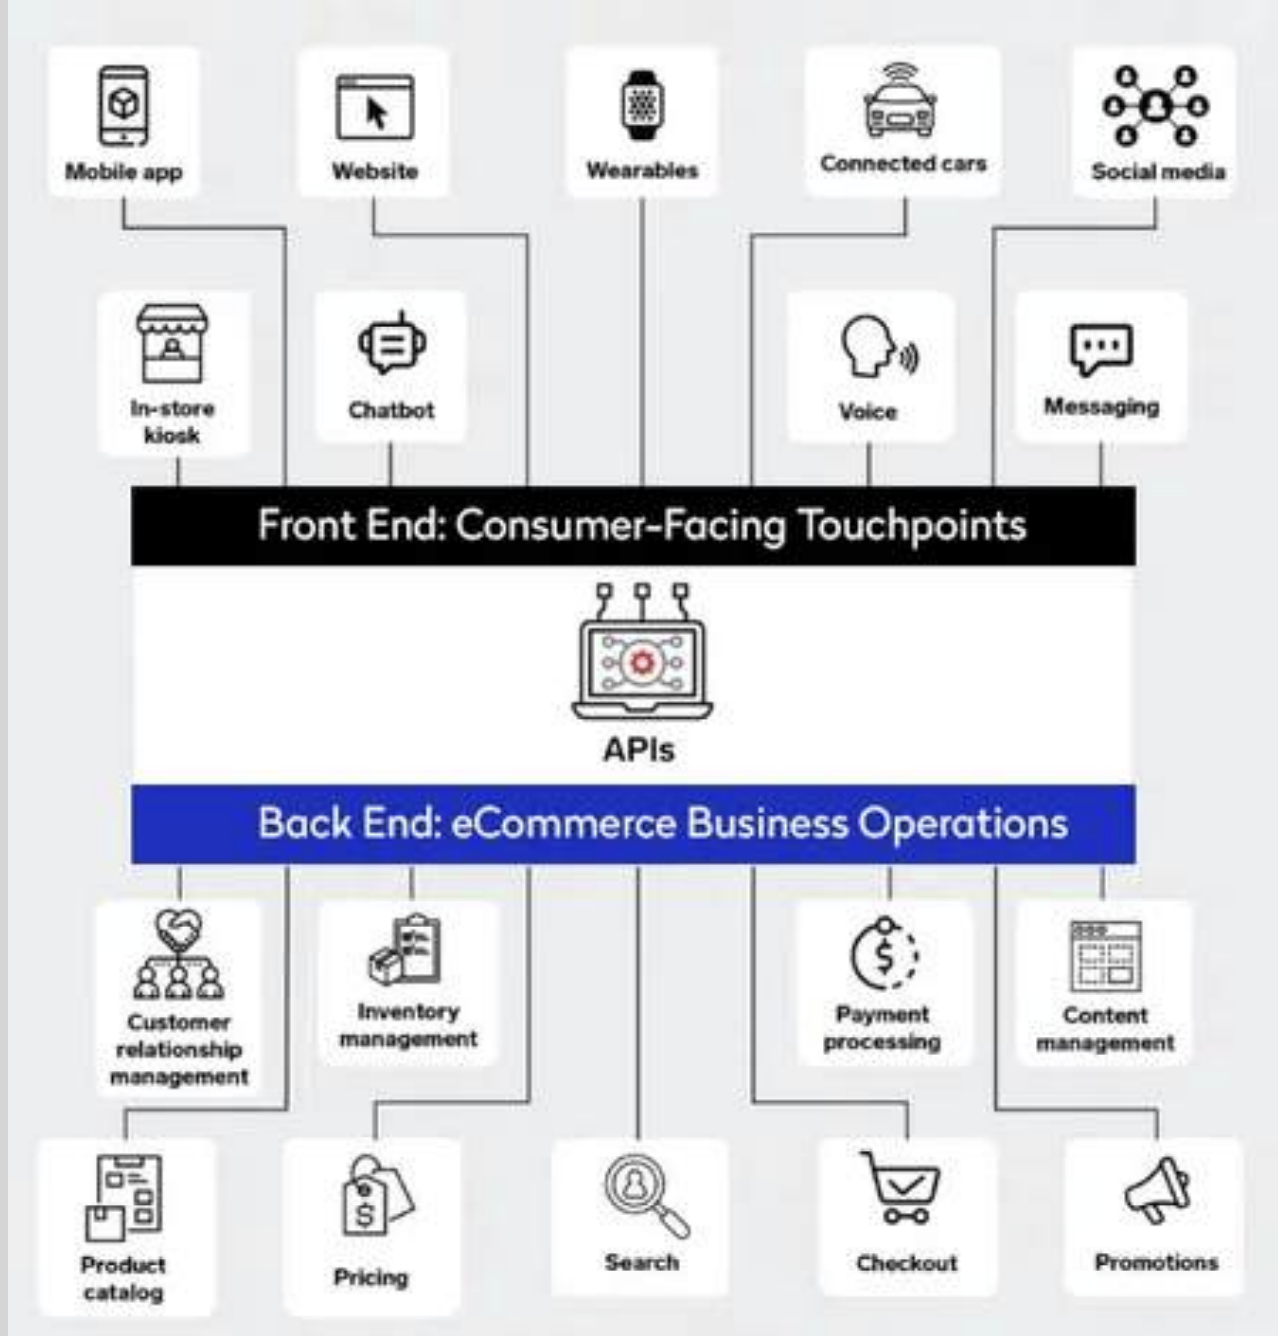
无头架构(headless architecture),其背景是现代应用需要将后端服务与各种不同的前端消费者端点进行匹配和连接, 前端不仅是传统的网站,还包括移动端 App、穿戴设备、智能联网汽车、社交媒体、实体店自助终端(Kiosk)、语音助手以及聊天机器人等。 为了实现前后端完全解耦, 后端不返回耦合度高的 HTML,而是直接返回结构化数据(如 JSON)。各项服务可以独立运行,并且通常拥有各自独立的身份验证(Auth)机制。
带来的挑战是,前端需要承担更多的工作(因为没有现成的“打包”端点);后端需要暴露更细粒度的端点,导致请求数量增多。
应对方案:常需要通过缓存或 **为前端定制后端(Backend for Frontend,BFF)**的设计模式来弥补和优化。
这个术语最初源自内容管理系统(CMS)厂商,对于它们而言,这种架构转变相当激进;但对于常规应用来说,这现在已经成为了标准开发实践。
对应概念: 就是课程里的前后端分离——前端(Vue)+ 后端(Deno),API 返回 JSON,通过 Sync 协调
模块化单体
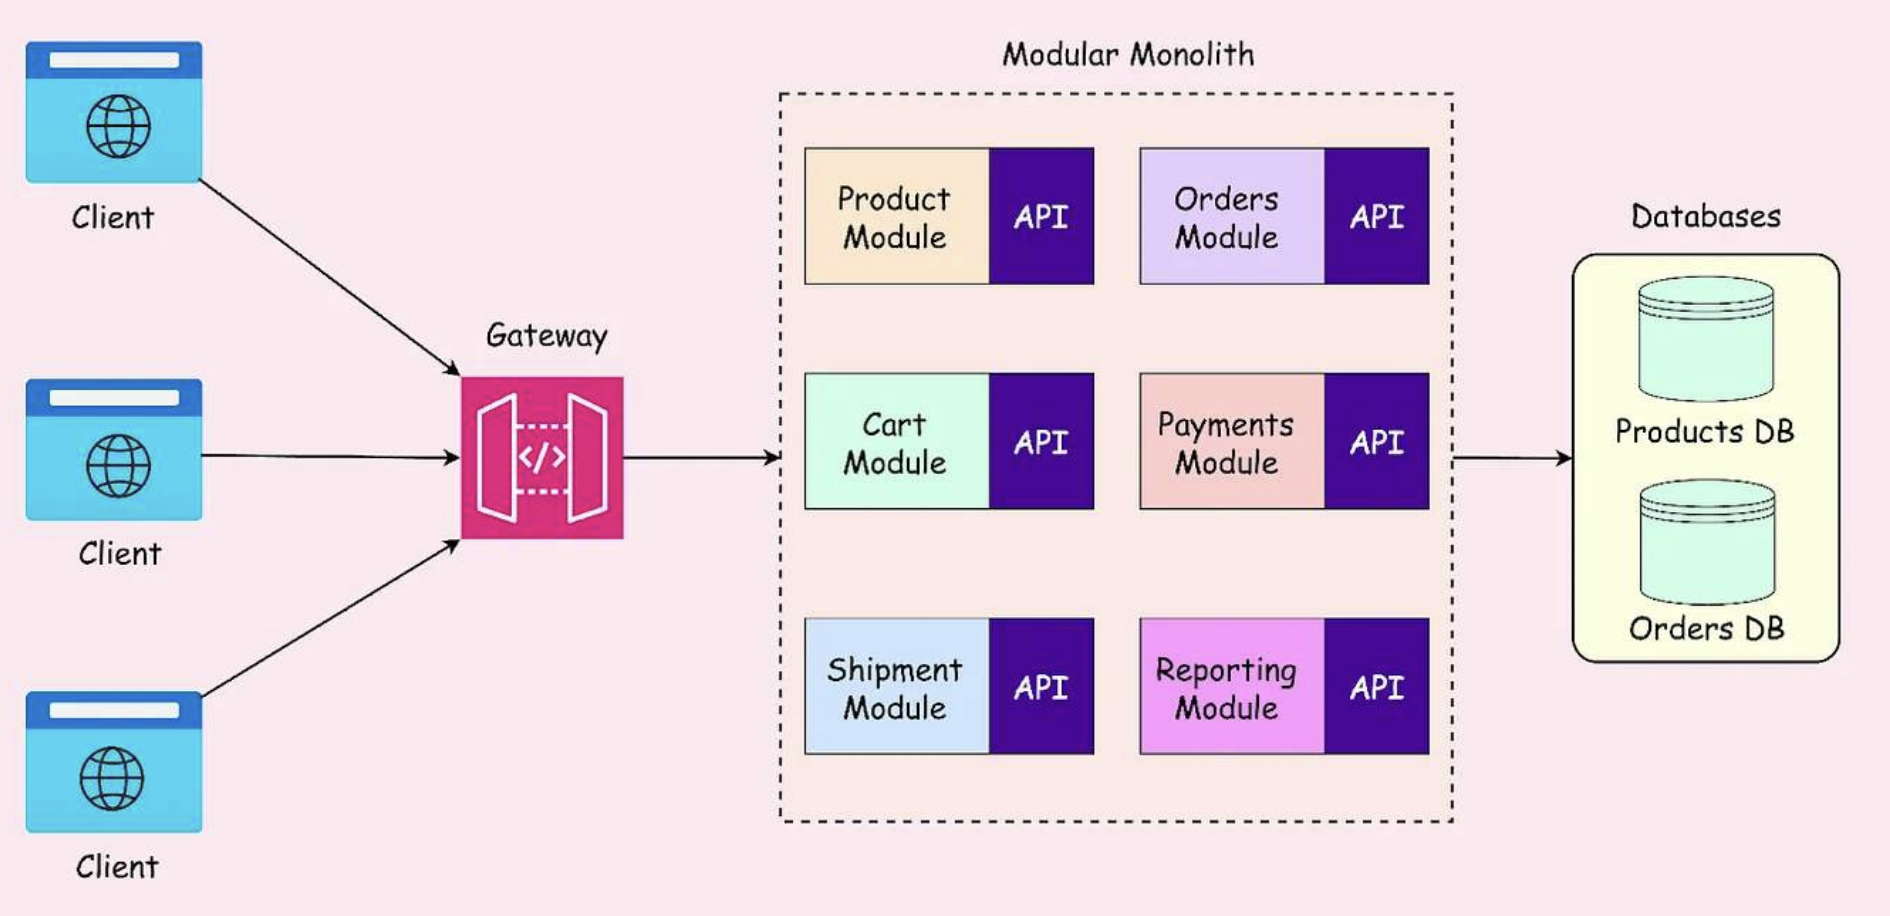
微服务(Microservices)在 2011 年左右兴起,当时采用完全独立的仓库与构建方式。但随着时间推移,纯粹的微服务变得过于沉重。因此,在过去的 5 年里,业界关于“回归单体“的讨论越来越多,而模块化单体则折中地结合了两者的优势。
其核心思想是,与其构建 N 个微小的独立服务,不如构建单个可部署的应用程序,但在内部将其结构化得像一个微服务系统。服务只通过 API 访问;每个服务拥有自己的数据。所有的模块都运行在同一个运行时下,共用一个数据库和同一个部署流水线。
面临的挑战在于, 由于各模块数据独立,传统的数据库 Join 变得困难(如下图)。业界衍生出了许多应对方法,例如采用独立的 数据读取存储(Separate Read Store)等策略。
数据读取存储(
Separate Read Store)
将写入端的主数据库与专门用于复杂查询的读取存储进行隔离的设计模式。通过异步事件同步数据(event-driven),解决微服务或模块化单体中跨库 JOIN 困难的痛点,提升查询性能
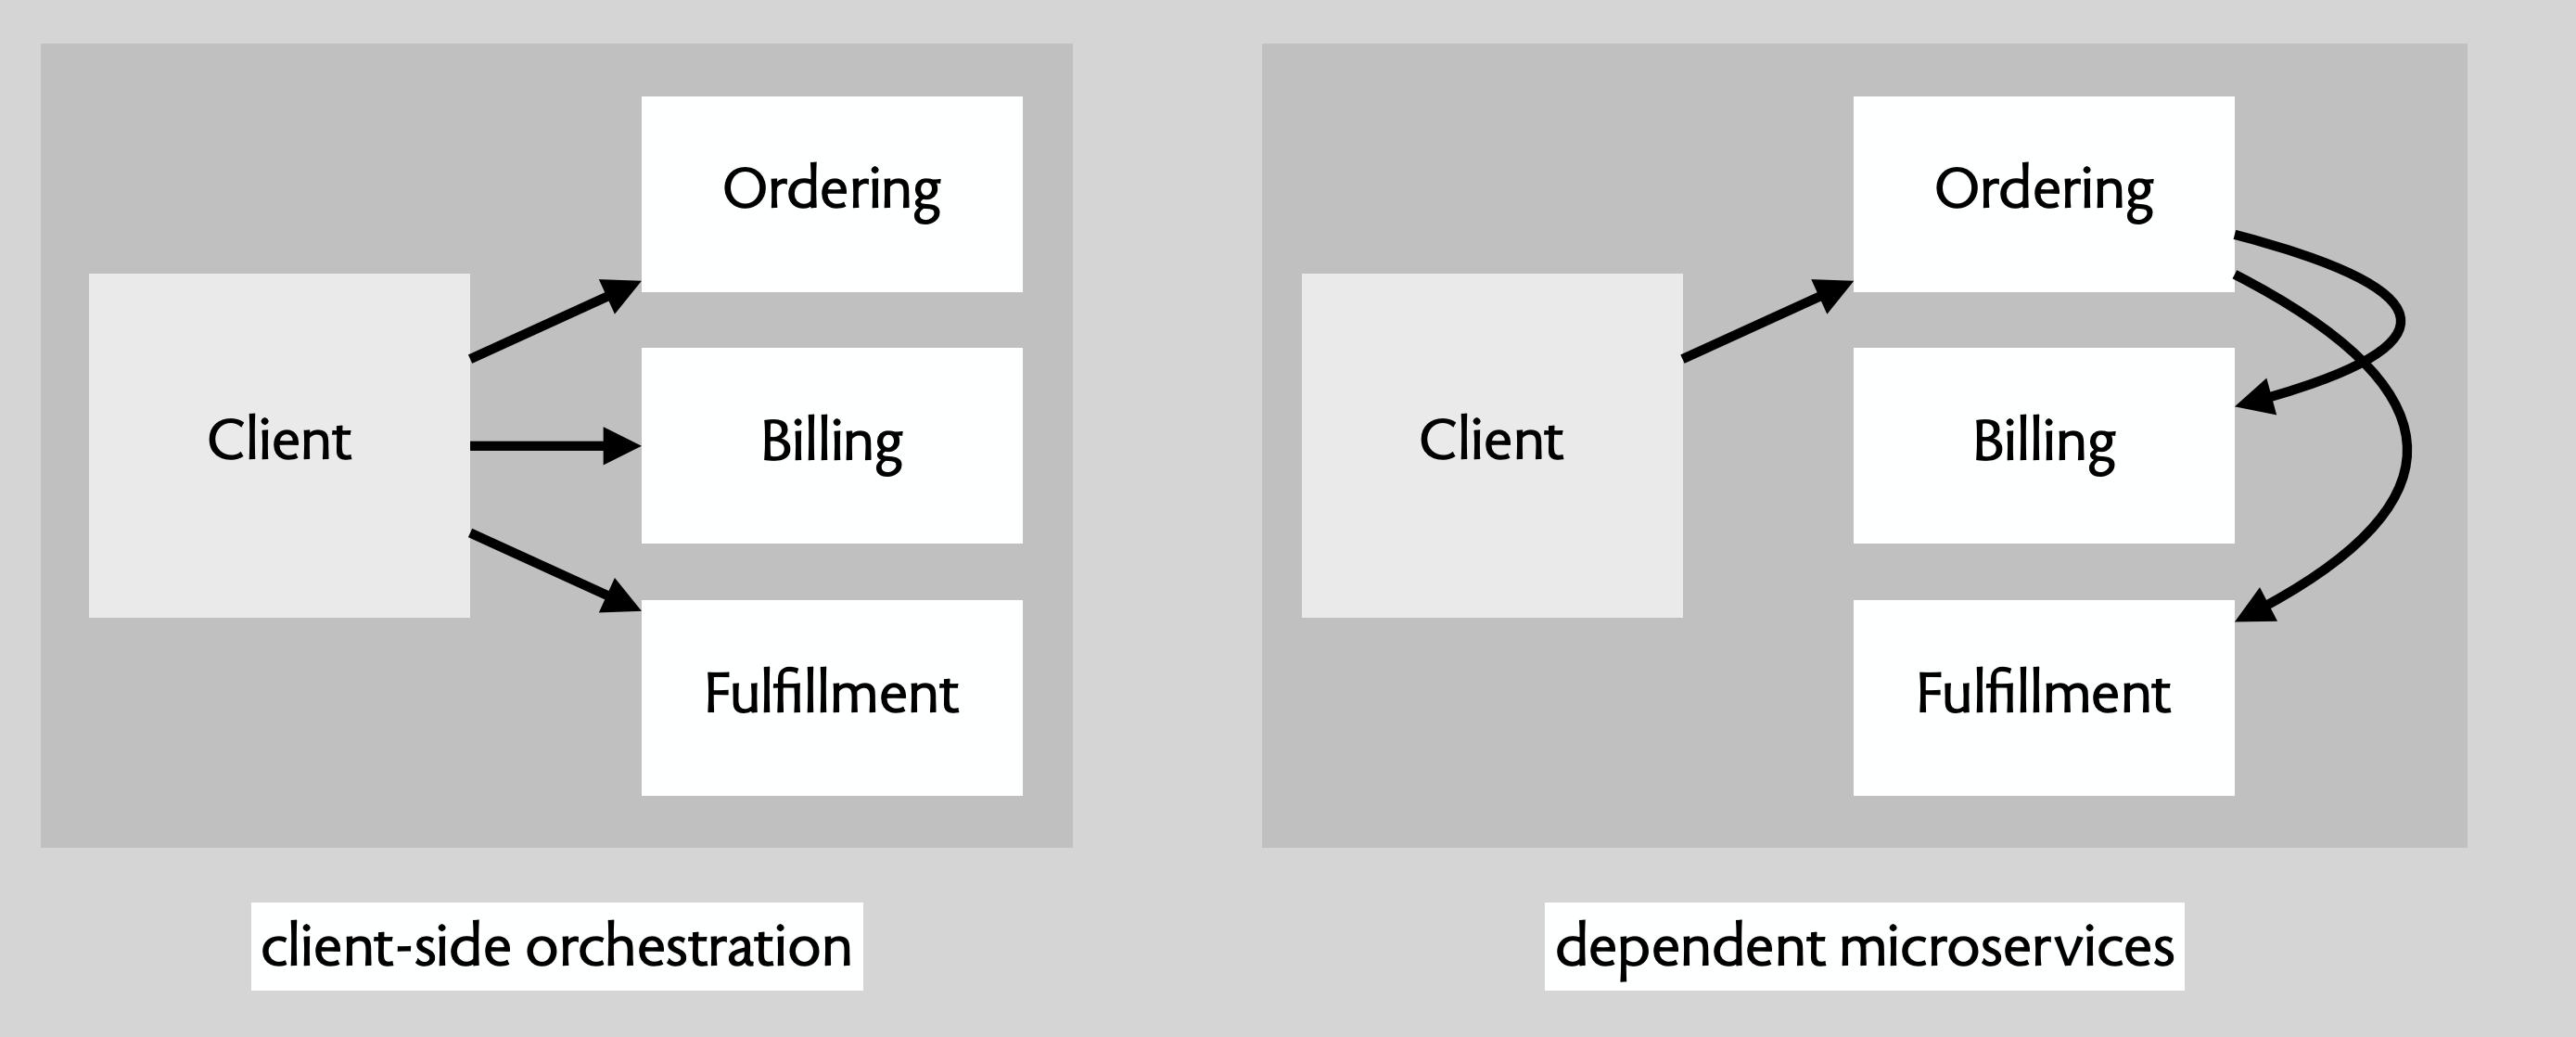
客户端编排(Client-side orchestration)和依赖微服务(Dependent microservices)都存在耦合问题。
事件驱动架构
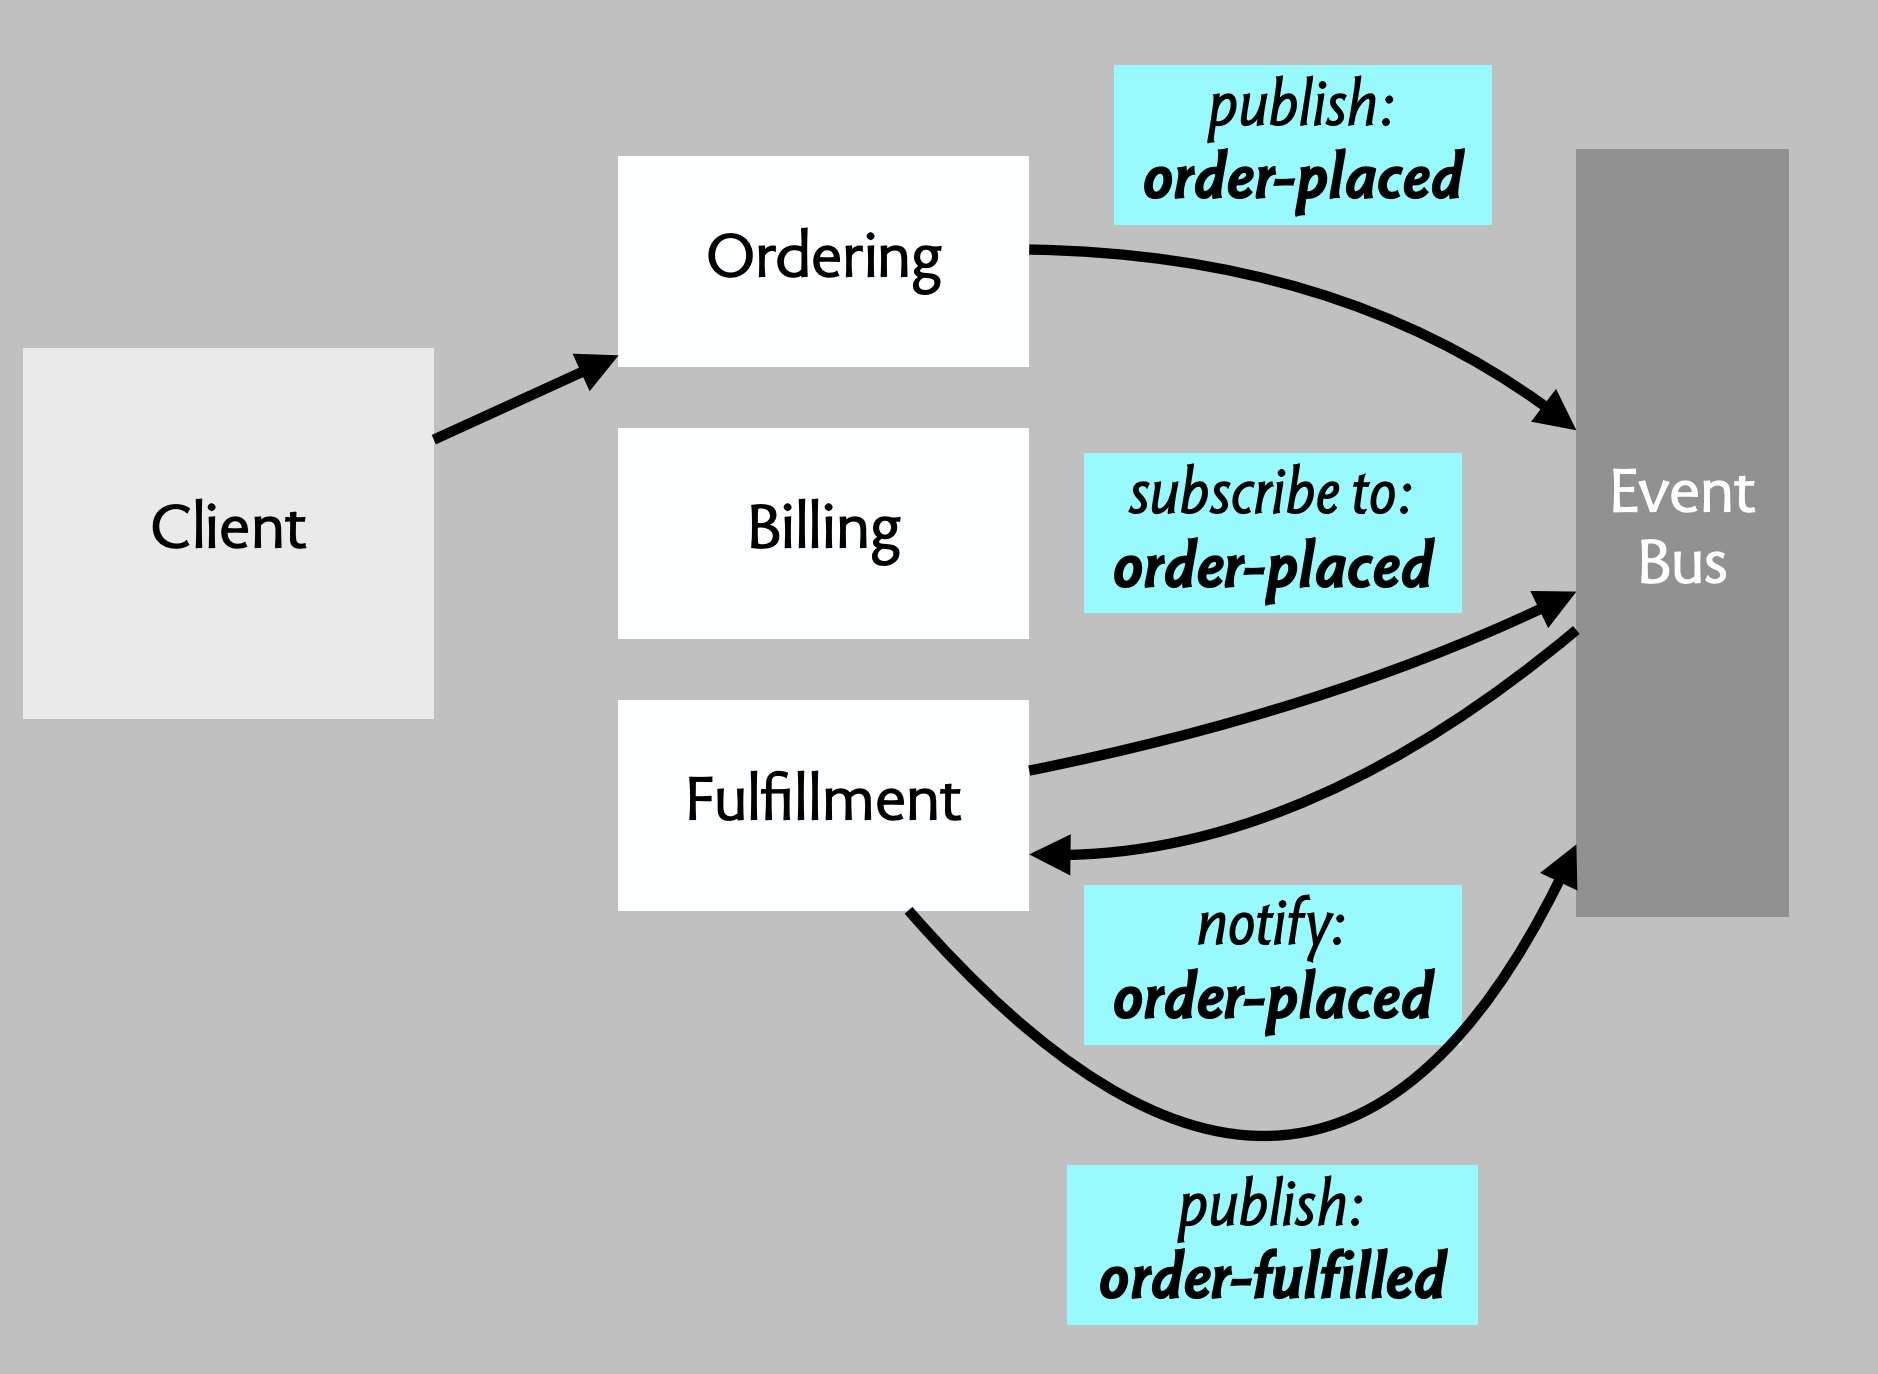
事件驱动架构(event driven architecture)的背景是, 在传统的微服务或模块化系统中,如果服务之间采用直接调用(例如订购服务直接去调用计费服务),服务之间就会产生强烈的耦合。为了实现服务之间的解耦,一个常用的做法是,服务通过 Event Bus 发布/订阅事件("隐式调用");用 event ID 确保幂等性。
积极影响是,扩展性好,可异步;可观测性强(事件作为审计日志);支持时间旅行——重返事件(Replay events)或进行 回滚。
带来的挑战,一致性变难:分布式系统中,相比于强一致性,处理最终一致性要复杂得多; 分布式调试也变得困难,追踪一个请求在多个服务间的流转会变得比较棘手。
历史:1980 年代第一批 pub/sub 系统;而在当今的现代架构中,它已经演化出了众多成熟的工业界主流框架,例如 Apache Kafka
事件驱动中的状态传递问题——产生服务间依赖
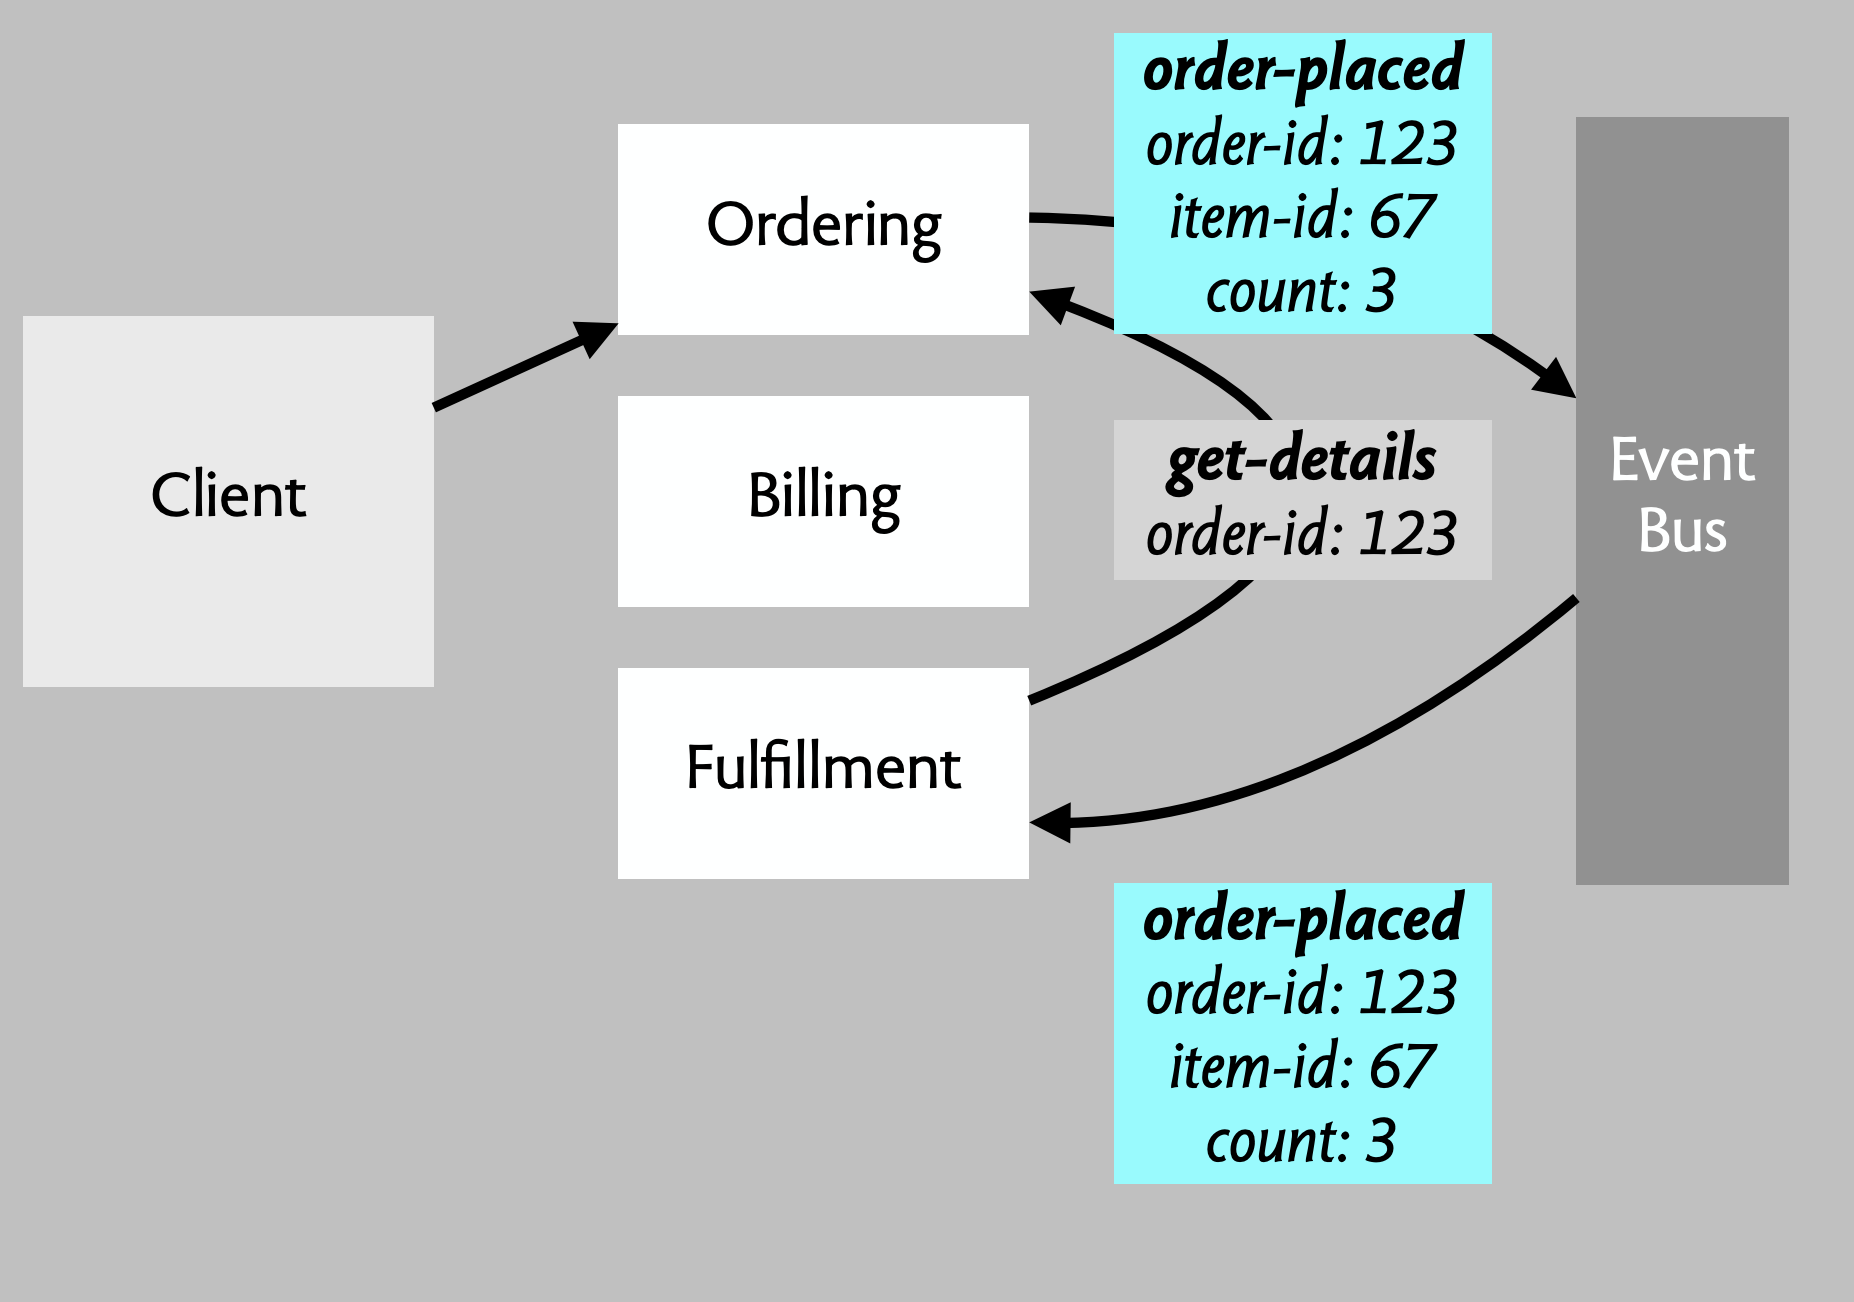
当发生一个事件(例如 order-placed)时,消费服务(如 Fulfillment 履约服务)通常面临一个两难的抉择:
- 方案 A(消费者主动调用):消费者收到事件通知后,需要反向通过 API 去向生产者(如
Ordering订购服务)请求详细数据。这导致服务间依然存在强耦合。 - 方案 B(事件携带状态 / Event-carried state):事件本身携带了所有详细数据。但这会导致消费者直接死死绑定在生产者的事件数据结构上,一旦生产者改了事件格式,消费者就会崩溃。
为了解决这种因直接依赖外部事件结构而导致的“系统污染”或紧耦合问题,业界引入了 ACL(防腐层)。
反腐层
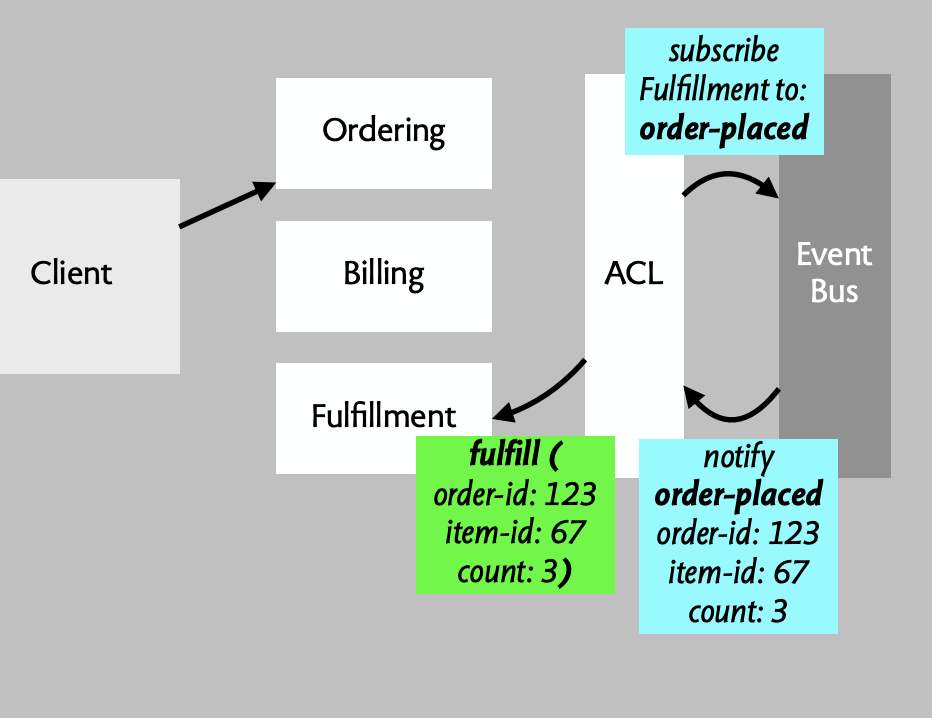
反腐层(Anti-Corruption Layer,ACL)介于事件总线与下游业务服务的之间的中介/翻译官,它负责将底层事件总线上的事件细节“隐藏”起来,不让外部的事件结构直接污染核心业务服务的代码。
一个典型的处理流程如下:
- 事件触发与监听:
ACL订阅并监听事件总线上的order-placed事件。 - 接收通知:当
order-placed事件发生时,ACL 收到带有订单、商品、数量等基础信息的通知。 - 转换与调用:ACL 将这些事件数据进行清洗和转换,随后向内部的
Fulfillment(履约服务)发起标准的fulfillAPI 调用。
探究概念设计的思想
如果公司不允许我完整地、从头到尾应用“概念设计”这一套理论,那我学习它还有什么意义?
Sol:可以借鉴部分价值观。
视图分离
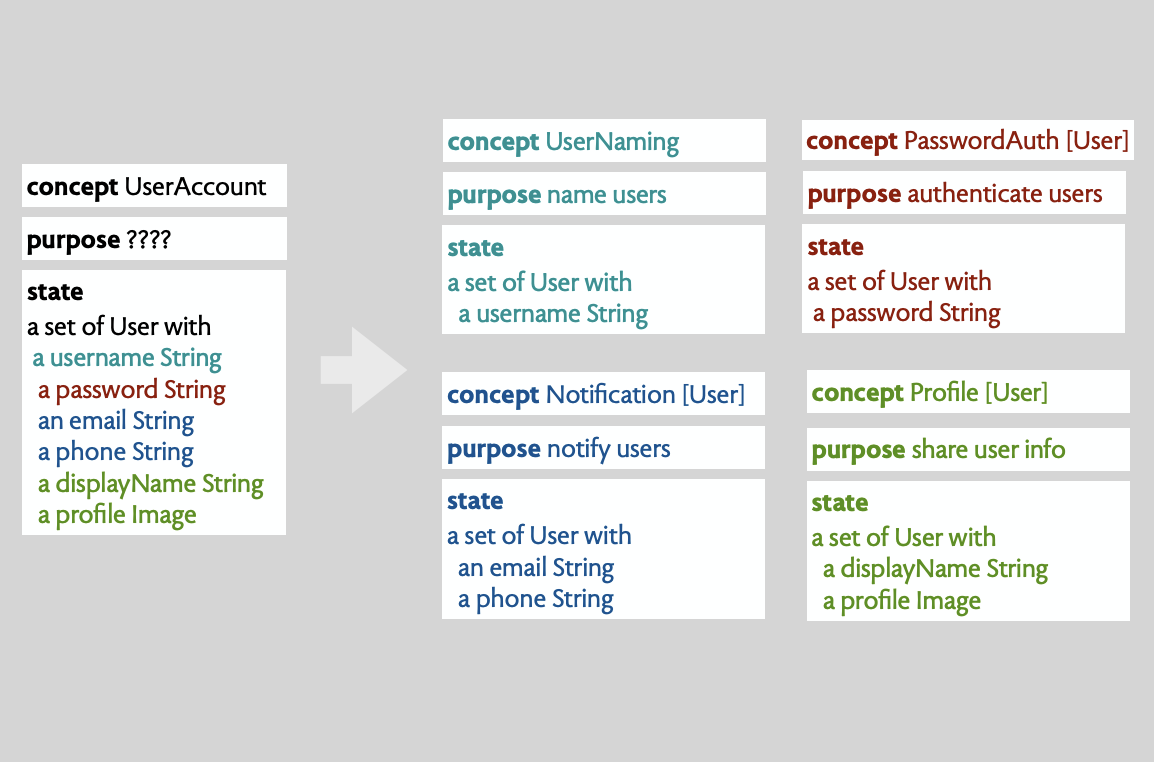
视图分离(View Separation)核心思想: 将功能目的划分,而非按对象归组(如上图所示)。
如何帮助? 它能做到分离关注点的作用,更多代码复用的机会;概念不与具体应用绑定。
如何做到? 避免 OOP 的对象归组方式; 对同一实体建立多个视图
挑战是什么? 跨视图查询需要 join
谁在用? RDB 的标准实践; OOP 中少见,但有 Mixin、实体-组件系统等补救方案
传统 OOP 把所有属性堆在一个 UserAccount 对象里,视图分离将其按目的拆分:
- PasswordAuth: 目的是认证用户,状态是 password
- UserNaming: 目的是用户命名,状态是 username
- Notification: 目的是通知用户,状态是 email、phone
- Profile: 目的是分享用户信息, 状态:displayName, image
Python Mixin 写法
from dataclasses import dataclass
class NamingMixin:
  username: str
  def set_username(self, username: str): self.username = username

class AuthMixin:
    _password_hash: str
    def set_password(self, h: str): self._password_hash = h
    def check_password(self, h: str) -> bool: return h == self._password_hash

class ProfileMixin:
    display_name: str = ""
    bio: str = ""
    avatar_url: str | None = None


@dataclass
class User(NamingMixin, AuthMixin, ProfileMixin):
      user_id: int

# demo
u = User(user_id=1);
u.set_username("dnj");
u.set_password("hash123")
u.display_name = "Daniel";
u.bio = "Daniel works at MIT";
实体-组件(ECS)写法
Entity = int

@dataclass
class Naming: username: str
@dataclass
class Auth: password_hash: str
@dataclass
class Profile: display_name: str; bio: str; avatar_url: str | None = None

naming: Dict[Entity, Naming] = {}
auth: Dict[Entity, Auth] = {}
profiles: Dict[Entity, Profile] = {}


# systems operate over sets of components
def register_user(e: Entity, username: str, pwd_hash: str):
  naming[e] = Naming(username); auth[e] = Auth(pwd_hash)

def set_profile(e: Entity, display_name: str, bio: str):
    profiles[e] = Profile(display_name, bio)

# demo
e = 42;
register_user(e, "dnj", “hash123");
set_profile(e, "Daniel", "Daniel works at MIT")
无界多态
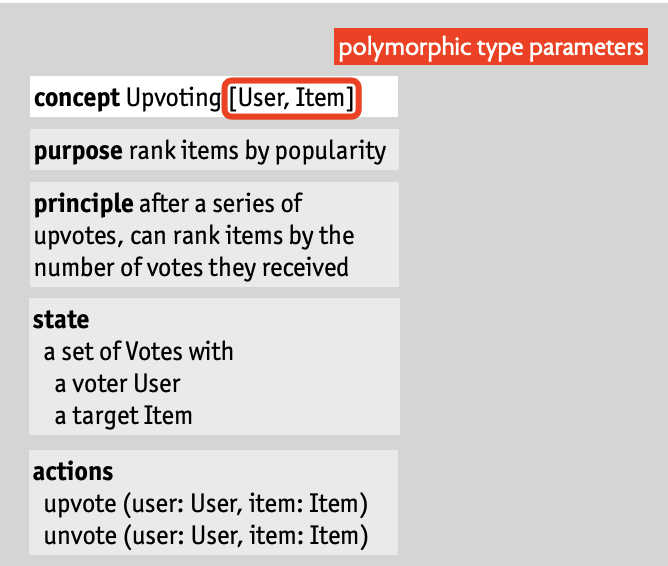
无界多态(unbounded polymorphism)核心思想:概念的类型参数应当是完全泛型的,例如 concept Upvoting [User, Item],这里的 User 和 Item 。
如何帮助? 服务/概念可以被完全独立地定义,专注于自己的目的,不需要为了适配某个具体应用而做定制——Upvoting 不需要知道 Item 到底是一篇帖子还是一条评论。
如何做到? 调用方只需要传入一个不透明的 id 或引用(或者一个原始类型),概念内部不对其做任何结构假设。
挑战是什么? 因为概念之间不共享类型定义,跨概念的协调需要更多"编排"(orchestration)工作
谁在用? 函数式语言(如 SML、Haskell)里的多态函数是这一思想的理论源头。一个完全通用的多态函数(如 reverse: ∀X. X* → X*),仅凭它的类型签名就能推导出它必须满足的行为定理,而不需要看函数的具体实现。这说明"不对类型做任何假设"这件事本身,恰恰保证了行为的可预测性。
**领域驱动设计(Domain-Driven Design)**里的"限界上下文"(bounded context)也是同一思想的工程实践:每个上下文(如 Catalog、Order、Billing、Fulfillment)独立开发、不共享假设或 schema,彼此之间只通过翻译层(如反腐层 ACL)通信。
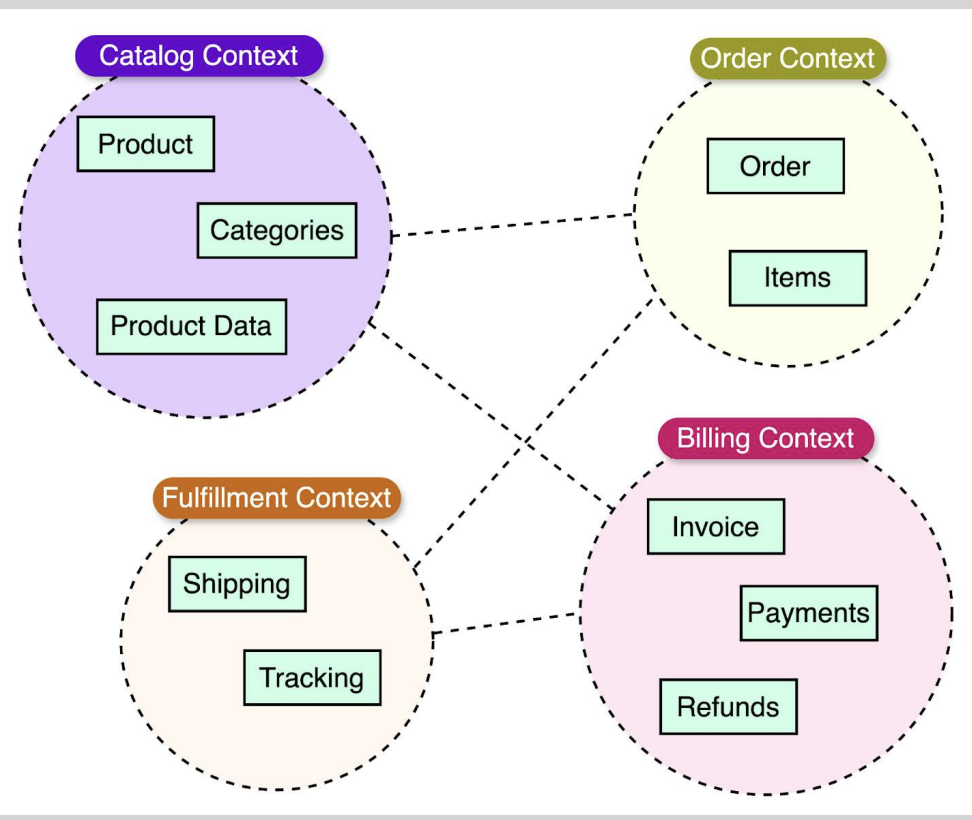
我的理解
概念设计 vs 领域驱动设计的区别在于,概念设计是微观层面的,对某个通用、可复用的机制建模;而领域驱动设计是比较宏观一些,界定业务边界,然后不同业务实体之间通过某种方式聚合。DDD 解决的是“怎么把大业务切成合理的模块并让团队分工协作”,而概念设计解决的是“怎么把单个模块内部的逻辑抽象得最纯粹、最严密”。
抽象状态与动作
抽象状态与动作(abstract state & actions)的核心思想:把系统行为建模成一个自动机(automaton)——用抽象的状态(state)和作用在状态上的关系(actions)来描述系统会做什么,
如何帮助?:状态描述与具体的代码实现无关(representation independent)——同一份状态与动作规格,可以用完全不同的代码实现,但语义上保持一致;这样的规格比读代码本身更简单、更容易理解。
如何做到? 需要一种能声明状态的语言(本课程用的是自己的 SSF 记号),并且为每个动作显式写出前置条件与后置条件。
谁在用? 这是是形式化方法领域几十年的标准实践——状态型规格语言(VDM、Z、B、Alloy)、软件建模语言(UML)、以及模型检验器(TLA+、Alloy、NuSMV)都建立在同样的思想上。
LLM 编码的思想
从 提示词工程 到 上下文工程
核心转变:过去构建 AI 应用主要聚焦于如何写好单轮对话的提示词(Prompt Engineering);现在则转变为研究如何配置最优的上下文(Context Configuration)来稳定触发模型的期望行为。
资源的稀缺性:上下文窗口虽然变大了,但它依然是有限且易受干扰的资源。因此,如何高效策展、组织背景文档、代码库状态和历史记录至关重要。
利用显式上下文管理项目
显式链接:通过 Markdown 链接将背景文档、设计草案、核心概念定义直接引入工作流,避免盲目堆砌全局代码。
按需加载模块:将项目的背景知识拆解为独立的 .ctx 或文档文件,使 AI 能够根据任务精准加载相关模块(如 User、Purchasing 等概念),减少噪声干扰。
agent 工具的陷阱与 破坏构建
破坏构建(Breaking the Build)的背景来自团队现实,当提供一个共享的核心框架或模板时,往往有 80% 的人会忍不住让 AI 代理去修改底层框架或全局配置。虽然自己的 AI 代理让局部代码跑通了,但由于私自篡改了通用核心,导致团队其他人的代码全盘崩溃。
防范策略:在使用 AI 代理(如 Cursor 或 Claude Code)时,必须严格约束其可操作的上下文和修改权限,不能盲目放任其乱改核心架构。
驾驭 AI 编码工具的最佳实践
- 建立工具的心智模型:清楚了解所用 AI 工具或代理的优势、盲区以及容易犯错的类型。
- 代码不脱离掌控:绝不能完全托管,工程师必须能够看得懂、解释得了 AI 生成的每一段核心逻辑。
- 小步快跑、逐步推进:不要让 AI 一次性实现宏大的功能,而是通过一次一个极小的指令稳步构建。
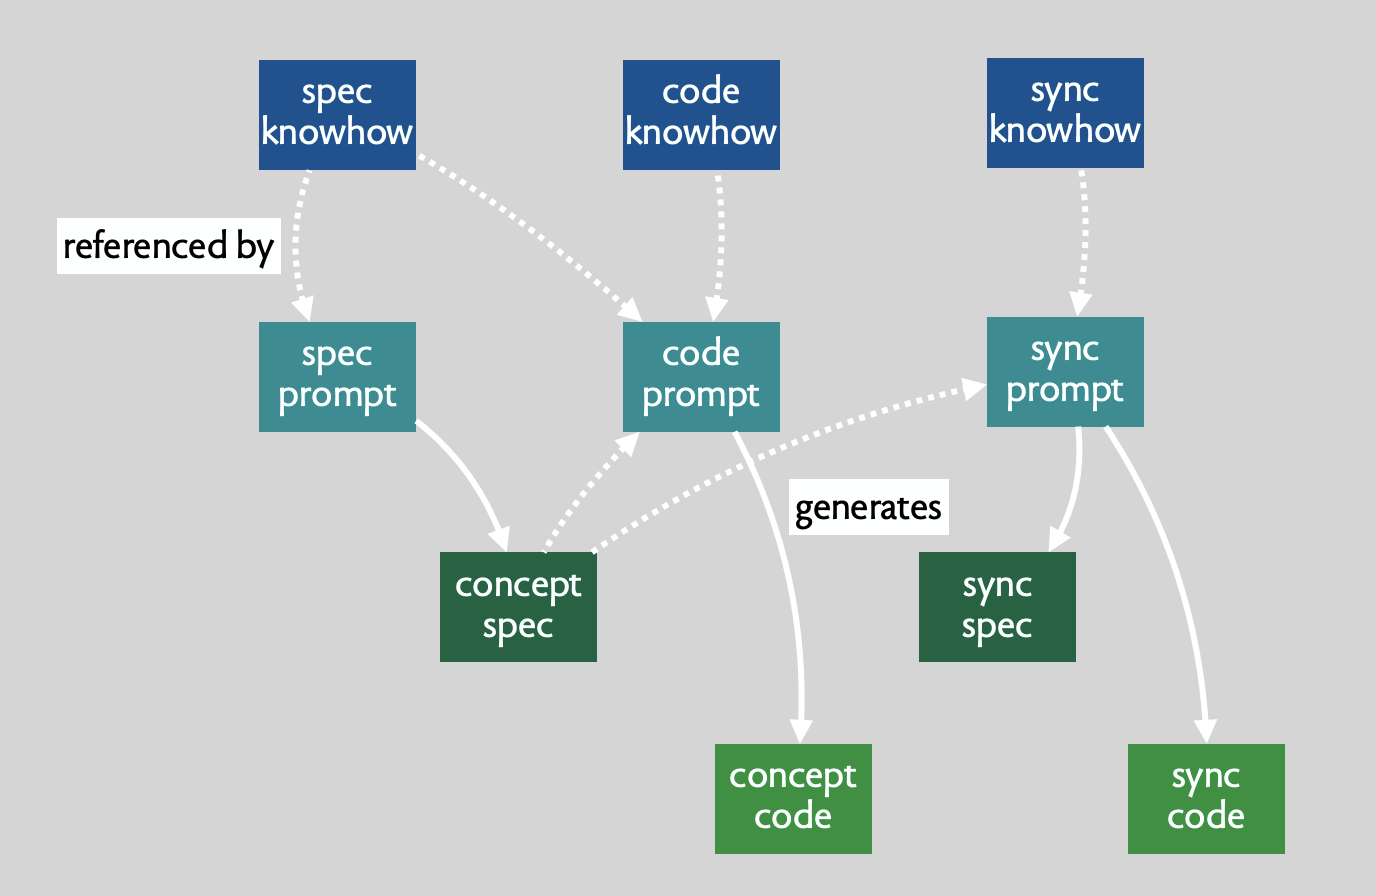
这张图揭示了在 AI 时代,人类的隐性知识(Know-how)是如何被系统化沉淀的:
- 多条独立的流水线:软件开发不能只靠一套万能 Prompt,而是需要针对不同环节(如规格说明
spec、代码实现code、模块同步sync)分别沉淀出各司其职的专属提示词(Prompts)。 - 全流程物化:人类脑子里的工程经验(Know-how) 转化为结构化的提示词(Prompt) 最终由 AI 驱动生成具体的规范、同步机制与实现代码。
设计模式及其起源
从建筑到软件——模式语言的传承
- Christopher Alexander 等人于 1977 年出版《A Pattern Language》,描述建筑设计中反复出现的模式(如门的位置、采光方式等)。
- 1994 年,Gang of Four(四人帮)将这一思想引入软件,出版《Design Patterns》——2025 年仍是亚马逊 OOP 类图书销量第一。
- Daniel 的观点:软件中的"概念"就是一种模式语言——反复出现、有名字、有结构的设计单元。
命名概念
本节依据官方课件 Design Lessons 第 41–61 页整理。
“名称”看似只是一个字符串,实际可能承担助记、唯一标识、层级解析或组织条目等不同职责。课件把这些职责拆成 Foldering、SimpleNaming、GlobalId 和 Namespacing 四个概念。区分它们的关键不在界面是否显示一个“名字”,而在系统对名称作出了什么保证。
Foldering:用树组织条目
Foldering 的目的不是识别条目,而是把条目组织成一棵树。Apple Mail 和 Obsidian 都是课件给出的例子。
concept Foldering [Item]
purpose organize items in tree
principle create a folder, add items to it, and move the folder;
          the items remain inside it
state
  a set of Folders, each with
    an optional parent Folder
    a set of Items
actions
  new (): Folder
  new (parent: Folder): Folder
  add (i: Item, f: Folder)
  remove (i: Item, f: Folder)
move (f: Folder, to: Folder)这个概念的核心语义是包含关系随文件夹一起移动。move 必须保证目标文件夹不是 f 自身,也不是 f 的后代,否则父子关系会形成环,不再是一棵树。
课件用 Apple Photos 追问“为什么这不是 Foldering”。照片可以同时出现在人物、日期、收藏和多个相册视图中,这些集合会重叠,也不一定通过唯一父节点形成树。界面上出现类似文件夹的侧栏,不代表背后的概念就是 Foldering。
SimpleNaming:名称便于记忆,但不保证唯一
SimpleNaming 只负责给条目分配助记名称。之后可以用名称识别条目,但往往还要结合其他属性消除歧义。
concept SimpleNaming [Item]
purpose assign mnemonic names to items
principle name an item and later use the name,
          perhaps with other properties, to identify it
state
  a set of Items, each with a name String
actions
  assignName (i: Item, n: String)
名称没有预定义的上下文,也没有唯一性保证。因此“起名”很容易,“根据名称找到唯一对象”却更难:街道名要配合邮编,患者姓名要配合出生日期,社交媒体显示名和书名都允许重复。
课件中的 Alcoa 案例说明,缺少技术上的冲突处理时,系统会把问题推到社会和法律层面。MIT 的 Alloy Constraint Analyzer 早期名为 Alcoa,随后收到铝业公司 Alcoa 的商标侵权通知。名称冲突没有由数据模型解决,只能借助商标权与社会压力协调。
Spotify 的歌曲标题也是名称属性。同名歌曲大量存在,标题适合展示和搜索,却不适合作为数据库中的稳定身份。
Safari 书签使用了哪些概念?
课件展示的 Safari 书签同时使用了 Foldering 和 SimpleNaming:文件夹把书签组织成树,文件夹名与书签标题为人提供助记名称。书签的 URL 是条目的地址属性,不能仅因为它看起来唯一,就自动把整个书签设计归类为 GlobalId。
GlobalId:用全局唯一标识追踪条目
GlobalId 为每个已注册条目分配一个全局唯一的标识符,之后可以用该标识符取回原条目。
concept GlobalId [Item]
purpose track items by unique global ids
principle register an item, receive an id,
          and later retrieve the item with that id
state
  a set of Ids, each associated with an Item
actions
  register (i: Item): Id
  _get (i: Id): Item
全局 ID 位于同一个唯一标识空间中,通常不承诺可读结构或业务含义。课件列出的例子包括社会安全号码、驾驶执照号、Spotify 曲目、YouTube 视频,以及用于会话、用户、卷和数据库记录的 UUID。
这与 SimpleNaming 的取舍正好相反:助记名称方便人理解,但可能重复;全局 ID 方便系统稳定引用,却通常不适合人记忆。分布式系统也不一定需要一台中央服务器逐个发号,可以通过足够大的随机空间生成 UUID,或先划分权威前缀再由各方独立生成;无论采用哪种实现,概念层需要维持的都是“不重复”这一保证。
课件还回顾了 URN(Uniform Resource Name):Tim Berners-Lee 最初希望用与位置无关的名称标识资源,使资源移动后不必改名。通用 URN 没有普及,但 ISBN、DOI 等权威命名体系保留了这一思路,例如 urn:isbn:9780141182636。
Namespacing:分散式的层级命名
Namespacing 把“名称必须唯一”的范围缩小到单个命名空间。每个绑定由局部名称和目标组成,目标既可以是普通条目,也可以是另一个命名空间,因此多个局部绑定可以组成路径。
concept Namespacing [Item]
purpose decentralized hierarchical naming
principle create a namespace, bind an item to a name there,
          and later look up the item by that name
state
  a set of Namespaces, each with a set of Bindings
  a set of Bindings, each with
    a name String
    a target Item or Namespace
  a Root Namespace
actions
  new (s: Namespace, n: String): Namespace
  bind (s: Namespace, i: Item, n: String)
  _get (s: Namespace, n: String): Item
  _resolve (path: seq String): Item
bind 的关键前置条件是:命名空间 s 中还不存在名称为 n 的绑定。否则同一局部名称会指向多个目标,_get(s, n) 便无法给出唯一结果。不同命名空间仍可重复使用同一个名称,所以命名权可以分散给各个命名空间的管理者。
Unix 文件系统是这一概念的直接例子。根目录和每个子目录都是命名空间,/Users/dnj/.ssh 是依次解析 Users、dnj、.ssh 三个局部绑定得到的路径。**硬链接(hard link)**允许两个绑定指向同一个文件,因此同一个文件可以同时拥有:
/Users/dnj/work/tasks.txt/Users/dnj/today/todo.txt
这说明路径是绑定构成的名称,不是文件对象本身的身份。重命名或移动一个路径,本质上是在改变绑定,未必改变目标对象。
DNS 也采用分层命名。课件中的 _resolve(<edu, mit, www>) 从根开始,依次进入 edu、mit 命名空间,最后解析 www。每一层只需要管理自己的局部名称,不必由一个机构维护所有完整域名。
Dropbox:共享的是对象还是命名空间
课件用 Unix 的命名空间和硬链接解释 Dropbox 的重命名行为。这是一个概念模型,用来说明用户可观察到的行为,不是对 Dropbox 内部实现细节的断言。
- 直接共享文件或文件夹:Dropbox 在接收者自己的根命名空间中增加一个指向共享对象的绑定。Ava 和 Bella 各自拥有局部绑定,因此一方修改名称,只改变自己的绑定,另一方看到的名称不变。
- 共享文件夹中的条目:共享文件夹本身就是双方共同使用的命名空间。条目的名称属于这个共享命名空间,因此任何一方重命名,其他人都会看到变化。
课件把这种设计概括为“Dropbox follows Unix”:文件夹是命名空间,共享类似硬链接。它同时给出另一种选择:Google Drive 用 GlobalId 标识文件,用 SimpleNaming 保存展示名称;快捷方式则是额外的概念问题。
| 概念 | 主要目的 | 名称保证 | 结构特征 |
|---|---|---|---|
Foldering | 组织条目 | 不负责唯一识别 | 父子关系形成树,移动文件夹会带走内部条目 |
SimpleNaming | 提供助记名称 | 不保证唯一 | 名称是条目属性,查找时可能需要其他属性消歧 |
GlobalId | 稳定追踪条目 | 全局唯一 | ID 通常不透明,不依赖条目所在位置 |
Namespacing | 分散式层级解析 | 同一命名空间内唯一 | 局部绑定组成路径,多个绑定可以指向同一目标 |
我的理解
建模时应把“对象身份”“给人看的名称”“对象所在路径”和“组织关系”分别检查。把这四件事都塞进一个 name 字段,会让改名、移动、共享和去重互相干扰。概念设计的价值正在于先拆开这些保证,再根据产品需要组合它们。