
Lec 11理解同步
Lec 11 理解同步
官方课件:Understanding Synchronizations。
本节目标:
- 理解 Web 端应用的架构:关于服务器
- 理解事情如何发生:执行流及其构成
- 理解和实现同步(synchronization)
放在一起就是说,
概念为我们提供了有用的独立构建模块,每个模块都能独立运行,并且可以单独理解。但是,
- 我们如何将它们组合起来呢?
- 入口点在哪里?
- 一个完整的应用程序是怎么样的?
TL;DR
- 当同一个 Concept Action 可以由多个 Route 触发时,把后续业务逻辑写进 Route 会造成重复、分散和分层耦合。
- Synchronization 用
when / where / then分别声明触发行为、状态条件和后续动作,使跨 Concept 的因果关系只定义一次。 - 将 HTTP 请求建模为
RequestingConcept 后,Express 只承担连接外部世界的适配职责,应用核心可以保持为扁平的 Concepts + Syncs。 - 同步引擎使用 Frame 保存一次执行中的变量绑定;
when建立绑定,where扩展或筛选绑定,then据此执行动作并自然表达跨 Concept Join。
理解 Web 应用
典型的 Web 应用可以理解成如下:
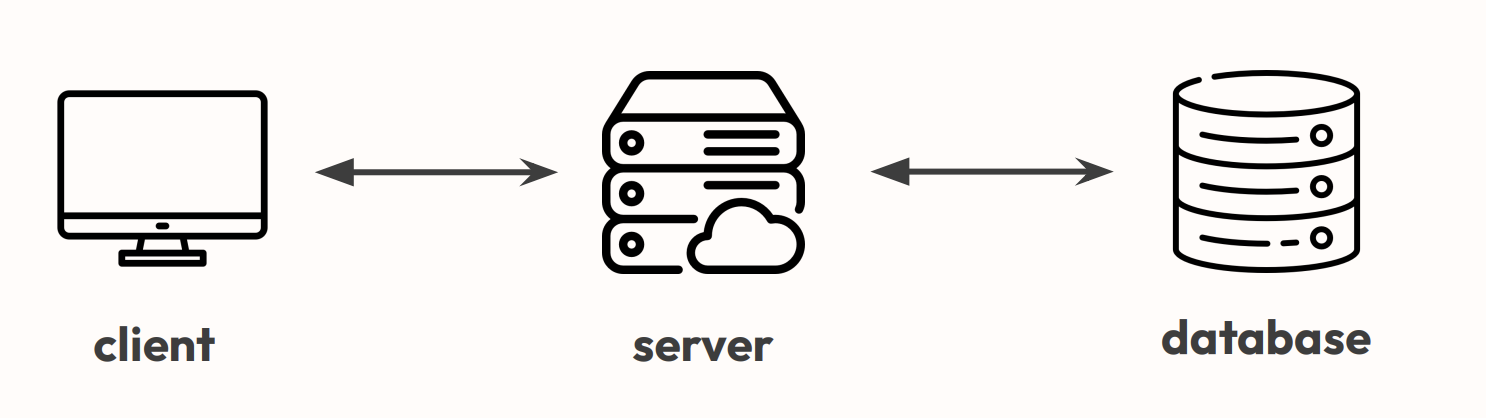
- Client:用户使用的浏览器,负责展示和交互。
- Server:接收请求、执行应用逻辑、返回结果。
- Database:持久化保存应用的数据。
这里一个关键问题是:Frontend 到底“活”在哪里?最终用户看到的 HTML 是在哪里生成的?
Frontend 的三种形式
1. Server-based
Frontend 主要在 Server。服务器从数据库获取数据、执行逻辑,然后生成最终 HTML 发送给浏览器。
Client → request → Server → Database
                    ↓
              generate HTML
                    ↓
Client ← HTML ← Server
即:
Server 负责生成页面,Client 主要负责显示。
2. Client-based
Frontend 主要在 Client,典型代表是 SPA(Single-Page Application)。
浏览器先获得较大的 JavaScript bundle,之后由客户端自己执行前端逻辑、更新页面;Server 主要提供数据。
Client → request data → Server → Database
Client ←    data     ← Server

Client:
JS + data → generate/update UI
即:
Server 主要返回 Data,Client 自己生成和更新页面。
React、Vue 这类 SPA 通常属于这种模式。
3. Database-based
HTML 本身也可以直接作为数据存储起来,常见于简单的静态网站。
Database
   ↓
stored HTML
   ↓
Server → Client
这里所谓 “frontend in database” 并不是数据库真的在运行前端,而是最终 HTML 已经被存储起来,而不是每次动态生成。
Server:API、HTTP 与 REST
API:Client 与 Server 的接口
Client 不需要知道 Server 内部如何实现,只通过 API 与 Server 交互:
Client ── Request ──→ Server
Client ←─ Response ── Server
Web API 通常建立在 HTTP 之上,并经常按照 REST 风格组织。
HTTP:Request / Response 的通信协议
HTTP(Hypertext Transfer Protocol)是一种 Client 与 Server 通信的协议,核心模式就是:
Request → Server → Response一个 HTTP Request 大致包含:
GET / HTTP/1.1
Host: www.example.com

<optional body>
其中包括请求方法、目标地址、Headers,以及可选的 Body。
Server 返回 HTTP Response:
HTTP/1.1 200 OK
Content-Type: text/html

<html><body><p>hi</p></body></html>
Response 同样包含状态信息、Headers 和 Body。
HTTP 规定的是 Client 和 Server 如何交换 Request / Response。
REST:如何组织 API
REST(Representational State Transfer)不是 HTTP 本身,也不等于 API,而是一种利用 HTTP 操作资源和管理状态的设计风格。
常见映射:
| 操作 | HTTP Method |
|---|---|
| Create | POST |
| Read | GET |
| Update | PUT / PATCH |
| Delete | DELETE |
例如:
GET    /users/34
POST   /users
PATCH  /users/34
DELETE /users/34
REST 的价值之一是解耦 Client 与 Server:双方只要遵守约定好的 API,就不必了解对方内部实现。
一个很好记的区别是:
HTTP 是通信规则;REST 是利用 HTTP 设计 API 的方式;API 是 Client 与 Server 之间暴露的接口。
Express:在 Server 中实现这些东西
Express 把前面的概念落实到代码:
- 接收 HTTP Request
- 根据 HTTP Method + Route 匹配处理逻辑
- 读取请求参数
- 执行 Server 逻辑
- 返回 HTTP Response
例如:
app.get('/', (req, res) => {
  res.send('hello world')
})
可以理解为:
GET + "/"
    ↓
匹配到对应 handler
    ↓
执行函数
    ↓
Response: "hello world"
这里 app.get() 对应 HTTP 的 GET,'/' 是 Route。
路由参数
Route 可以包含动态参数,用 : 表示:
app.get('/users/:userId/books/:bookId', (req, res) => {
  res.send(req.params)
})
如果请求:
/users/34/books/8989Express 会解析为:
req.params = {
  userId: "34",
  bookId: "8989"
}
因此 :userId、:bookId 不是固定字符串,而是 URL 中需要提取出来的变量。
一个请求的生命
假设社交应用里出现了一条新的 Post。创建 Post 的来源其实可能很多:
用户主动发帖 → Post.new
上传照片 → 自动 Post.new
Bot → Post.new
其他功能 → Post.new
而 Post.new 发生之后,又可能触发很多事情:
Post.new
├── 给用户确认
├── 查询 Followers
├── 通知 Followers
├── 更新推荐算法
├── 内容分析
└── 广告 / 支付系统……
也就是说,真正重要的业务关系不是:
“用户访问了哪个 Route?”
而是:
“某个行为发生以后,还应该发生什么?”
传统 Route 写法
例如普通用户发帖:
POST /posts/:user_id

→ Session:检查登录
→ Post.new
→ Following:获取 followers
→ Notification.notify
→ *新增 Algorithm.update*
如果上传图片也会自动创建 Post:
POST /images/:user_id

→ Image.new
→ Post.new
→ Following:获取 followers
→ Notification.notify
→ *新增 Algorithm.update*
问题出现了:只要 Post.new 有多个来源,所有 Post 创建后的逻辑都必须在每条 Route 里重复。漏掉任何一个 Route,系统行为就不一致。
为什么这是设计问题?
之前 Synchronization 的定义是声明式的:
when A happens
where B is true
then C happens
例如:
when Post.new(post)
then Algorithm.update(post)它表达的是一个全局成立的因果关系:
不管
Post.new是从哪个 Route、哪个功能产生的,只要它发生,就应该更新 Algorithm。
但如果把逻辑写死在 Route:
Route A
→ Post.new
→ Algorithm.update

Route B
→ Post.new
→ Algorithm.update
你实际上是在不同地方反复实现同一条 Sync,而不是声明一次规则,让它始终成立。
三个问题
1. 线性重复
一个 Route = 一条线性执行流程。同一个行为从不同 Route 产生,就会复制相同逻辑。
2. 结果/影响 分散
Post.new 会导致什么结果,散落在不同 Route 中。想知道完整行为必须到处找代码,维护困难。
3. 分层耦合
所有业务行为都挂在 Router / Server 下面:
Router
├── Route A
│   ├── Post
│   ├── Following
│   └── Notification
│
└── Route B
    ├── Image
    ├── Post
    ├── Following
    └── Notification
Router 逐渐变成一个知道所有业务规则的“大总管”,Concept 之间也无法真正独立。
解决方法
更理想的思路是把两件事情分开:
Route
↓
负责让某个 Action 发生

Post.new
↓
Syncs
├── Notification...
├── Algorithm.update
└── Moderation...
例如:
when Post.new(post)
then Algorithm.update(post)
这样无论:
POST /posts → Post.new还是:
POST /images → Image.new → Post.new一旦 Post.new 真正发生,同一条 Sync 都会自动适用。
我的理解
Route 描述“请求从哪里进入系统”,Sync 描述“一个行为发生后应该触发什么行为”。如果把 Sync 逻辑直接写进每个 Route,同一业务规则就会被重复实现,导致逻辑分散、耦合和维护困难。更好的目标是:业务因果关系只声明一次,与触发它的具体 Route 解耦。
用概念贯通全线
老师主张:软件 = 概念 + 同步
问题是:传统 Web App 里还有一个很大的 Server / Express,它负责 HTTP、Route、Request/Response。那这个 Server 算什么?如果它是一个特殊的中心层,不就又形成了层级结构,破坏了前面强调的 扁平架构 吗?
老师的解决办法是:连请求本身也建模成一个 Concept。
这一抽象不是为了用 Concept 取代 HTTP,而是为了划清边界:HTTP 负责把外部输入送进系统,Requesting 记录请求及其响应状态,其他 Concepts 则继续封装各自的业务能力。这样,协议适配与业务因果关系可以分别演化。
请求概念化
Requesting 是对 Request/Response 周期的具象化(reification):每个请求成为可追踪的状态记录,包含方法、输入参数和最终输出。外部适配层通过 system action 发起请求,系统内部再通过普通 Sync 把请求连接到业务 Concepts。
这条边界让业务 Concepts 不必知道 Express、URL 或 HTTP Method,也让传输协议可以替换而不改变核心因果规则。反过来,Requesting 只负责表达外部请求的生命周期,不吸收认证、发帖或通知等业务职责。
API Server 的本质其实就是处理:
外部 Request → 系统处理 → Response因此可以把 Request/Response 抽象成一个普通的 Requesting 概念:
Concept Requesting

Purpose:
响应来自系统外部的请求

State:
Request
  - method
  - input parameters
  - output parameters

Actions:
system request(method, parameters) → request
respond(request, parameters)
这里最重要的是 system request:它表示这个 Action 由系统外部触发。
例如:
HTTP GET /users
        ↓
Requesting.request("getUser")
        ↓
其他 Concepts + Syncs
        ↓
Requesting.respond(...)
        ↓
HTTP Response
那 Express 去哪里了?
Express 仍然存在,但它不再承载业务逻辑,而只是系统与外部世界之间的适配层 / side effect。
app.get("/users", async (req, res) => {
    const response =
        await Requesting.request({
            method: "getUser"
        })
})
Route 只负责:
HTTP 请求 → 转换成 Requesting.request → 等待结果 → 返回 HTTP Response,真正的业务行为仍然由 Concepts + Syncs 完成。
我的理解
不仅业务功能被建模为 Concept,连 Request/Response 这样的基础系统行为也可以 Concept 化;Express 等框架退化为连接外部世界的适配层,使应用核心真正保持为 Concepts + Syncs,而不需要一个承载业务逻辑的中心 Server。
Sync 的本质
传统 Route 把业务写成一条条线性执行流程,但同一个行为可能从不同 Route 产生。例如 Post.new 既可能来自用户主动发帖,也可能来自上传图片后自动创建。如果把“通知关注者、更新算法”等后续逻辑直接写进 Route,就会造成重复,而且每增加一种触发方式,都需要修改多个地方。
Synchronization 的核心是把这种流程拆成独立的「因果规则」:
when A 发生
where B 条件成立
then C 发生也就是:Sync 描述 Cause → Effect,而不是描述一整条执行流程。
例如创建 Post 有不同原因:
sync UserPost
when Request.userPost(user, post)
where Session: user logged in
then Post.new(post, author: user)

sync ImagePost
when Request.newImage(image, user)
then Post.new(post: image, author: user)
但无论 Post 是怎么创建出来的,只要 Post.new 发生,后续规则都可以统一声明:
sync NotifyFollowers
when Post.new(post, author: user)
where Following: follower follows user
then Notifying.notify(follower, post)

sync AlgorithmUpdate
when Post.new(post, author: user)
then Algorithm.update(post, user)
这样新增一个后续效果时,只需要增加一个 Sync,不需要修改所有能够创建 Post 的 Route。
多个 when
一个 Sync 也可以要求多个 Action 属于同一次执行 Flow:
sync NotifyFollowers
when Request.userPost(user, post)
		 Post.new(post, author: user)
where Following: follower follows user
then Notifying.notify(user:follower, post)
这里不是简单说“这两个 Action 曾经发生过”,而是要求它们处于由 Sync 形成的**同一个因果执行图(DAG)**中。因此可以区分“用户主动发帖产生的 Post.new”和“上传图片产生的 Post.new”。
设计上的变化
过去:
Route / Sync
→ Action A
→ Action B
→ Action C
→ Action D
Sync 本质上仍像一份线性的 recipe。
现在:
Concepts + 独立 Syncs

A → B
B → C
B → D
C → E
应用因此变得更 flat:不再由一个巨大的 Route 控制整个流程,而是由独立 Concepts + 独立因果规则组合起来。
我的理解
核心:Concept 定义局部行为,Sync 定义行为之间的因果关系;每条因果关系只声明一次,并可以独立增加、修改和理解。
实现同步
Synchronization Engine 将声明式的 Sync:
sync NotifyWhenReach10

when
  Button.clicked(kind: "increment_counter", by: user)
  Counter.increment()

where
  Counter.count >= 10

then
  Notification.notify("Reached 10", to: user)
转化为实际执行过程:
when 匹配 Actions → where 查询/过滤状态 → then 触发 Actions
Frames:同步执行的上下文
Sync 使用 Frame 保存一次匹配中的变量绑定,例如:
{ user: "xavier", count: 10 }Frames 则是一组可能的绑定。三个阶段实际上都在围绕 Frames 工作:
when:匹配发生过的 Actions,建立变量绑定where:通过 query/filter 扩展或筛选 Framesthen:对最终每个 Frame 执行 Action
Frames 可以自然实现 Join
例如删除 Post 时,同时删除它的所有 Comments:
sync DeleteComments

when
  Post.delete(post)

where
  Comment: comment.target = post

then
  Comment.delete(comment)
Post.delete(p1) 首先产生:
{ post: p1 }where 查询 p1 的 Comments 后,将一个 Frame 扩展为多个:
{ post: p1, comment: c1 }
{ post: p1, comment: c2 }
{ post: p1, comment: c3 }
因此 then 自然执行:
Comment.delete(c1)
Comment.delete(c2)
Comment.delete(c3)
对应 TypeScript:
const DeleteComments = ({ post, comment }: Vars) => ({
  when: actions(
    [Post.delete, { post }, { post }],
  ),

  where: (frames: Frames) =>
    frames.query(
      Comment._getByTarget,
      { target: post },
      { comment }
    ),

  then: actions(
    [Comment.delete, { comment }]
  )
})
核心:Frame 是 Sync 中变量绑定的上下文。
when建立 Frames,where扩展/过滤 Frames,then消费 Frames 执行动作;因此跨 Concept 的查询和 Join 可以直接通过 Sync 表达。
Web 应用架构一直在变化。传统以 Server / Express Router 为中心的架构容易把认证、业务逻辑、通知等 concerns 耦合在 Route 中。Concept Design 的做法是把这些行为重新抽象出来:例如将 API 的本质提取为 Request Concept,再通过独立的 when / where / then Synchronizations 连接 Concepts,从而形成更扁平的架构。课程提供的轻量 TypeScript Synchronization Engine,就是这套模型的实现。
Concept 与 Sync 的本质
Concept 不只是设计模式或代码结构,而是试图描述“软件中真正发生的事情”,与具体实现方式无关。例如无论底层使用 Express、REST 还是其他技术,外部向系统提出请求这件事都可以抽象成 Request。
Synchronization 也不只是模块组合机制,而是在描述因果关系(cause → effect):
when  发生了什么行为
where 在什么状态/条件下
then  会导致什么行为
理解软件的两个维度
任何关于软件的问题,都可以沿两个轴分析:
| 结果 | 影响 | |
|---|---|---|
| 行为 | when:什么 Action 触发 | then:触发哪些 Actions |
| 信息 | where:什么 State/条件成立 | Concept Action:如何改变 State |
因此在 Concepts + Syncs = Software 的模型中,所有因果关系都有明确的位置:行为的原因来自 when,信息条件来自 where,对行为的影响写在 then,对信息状态的改变封装在 Concept Actions 内。
最终目标
这套架构追求三个基本原则:
- 增量性:Concept / Sync 可以逐个添加,每个只负责一件事。
- 完整性:加入新的 Concept / Sync 不应破坏已有功能。
- 透明性:能够直接阅读系统,追踪“什么导致了什么”。