
Lec 7设计 AI 驱动的交互 I
Lec 7 设计 AI 驱动的交互 I
官方课件:Designing AI-powered Interactions, Part 1。
本节 Lec 的目标是:
- 掌握 与聊天模型和推理模型交互的基本知识,以便在项目中设计 AI 功能
- 理解 与 LLM 有效交互的障碍:幻觉、心智模型不匹配等
- 下节课—— 在聊天之上交互: UI 抽象掉 LLM 的推理
LLM 使 AI 功能开发变得前所未有地容易——但设计出真正好用的 AI 功能仍然极具挑战性。
TL;DR
- Prompt + Completion 把表达需求、补足上下文和判断答案的负担都交给用户,因此只是 AI 产品交互的起点,而不是完整方案。
- 幻觉、上下文不透明和心智模型错配不能仅靠“更强模型”解决;界面必须提供来源、局部修正、撤销和人工接管等可供性。
- 推理模型可能提升复杂任务质量,但展示完整推理并不天然可信;应按用户行动需要提供简短理由、来源或可编辑中间结果。
- 线框图把抽象概念变成可测试的用户旅程;概念之间即使有外部依赖,也只有满足单向、非对称和可独立复用等条件时才应形成内部依赖。
AI 产品落地的背景
2025 关于 AI 工具的 MIT 报告指出,
-
个体层面已有真实收益:员工用 ChatGPT、Claude 等通用工具写作、检索、分析、编程,效率常有提升。
-
企业层面却出现“GenAI 鸿沟”:大多数试点没能形成可量化的收入增长、成本下降或利润改善;报告样本中,约 5% 项目实现了快速的 P&L 层面价值。
-
高 ROI 更常在后台运营:如采购、财务、合规、客服流程、供应链与内部知识流程,而不是预算最集中的销售和营销内容生成。
-
成功企业往往不是从零自建炫目的模型,而是选定明确、可衡量的工作流痛点,采用能与企业数据和流程结合、能持续迭代的方案。
基础交互范式:Prompt + Completion
最直接的模式是用户输入 prompt,系统立即展示 completion。它适合泛化问答、客服、辅导等开放任务,但把“如何表述问题、如何补足上下文、如何判断答案”都推给了用户。它强大,却是产品交互的最低层封装。
主要陷阱
-
事实幻觉(Hallucinations):模型面对错误前提(如询问不存在的 MIT 校区)不会主动质疑,反而以自信、工整的语言继续编造合理假象。
- 启示: 不能将模型的自信度与条理性作为可信度指标。
-
上下文不透明(Lack of Context):很多错误源于模型缺少任务所需的背景信息(例如用户提问中的代词“it”指代不明)
-
心智模型错配(Mismatched Mental Models):用户脑中对系统的理解与 AI 的真实能力产生偏差。
-
过度自动化:系统替用户作出价值判断,导致难以撤销的后果。
关于心智模型的观察 ——Don Norman
-
心智模型是不完整的(Incomplete)
-
人们“运行”模型的能力是有限的(Limited):人们并不喜欢在每一次操作前都进行细致的思考与推导。
-
心智模型是不稳定的(Unstable):人们容易遗忘系统的具体细节。
-
心智模型缺乏清晰的边界(No firm boundaries):相似的设备与操作之间极易发生相互混淆。
-
心智模型是“非科学的”("Unscientific"):即使知晓更好的替代方案,人们仍会维持某些“迷信式”的行为习惯。
-
心智模型是追求认知节省的(Parsimonious):人们宁愿付出额外的物理操作,来换取心智思考负担的减轻。
迭代困境:缺乏修正可供性
Prompt → Completion 的一个重要问题是:模型第一次生成错了以后,用户不一定知道该怎么修正它。例如让模型生成 MIT 6.1040 的课堂图片,结果生成成了卡通风格。
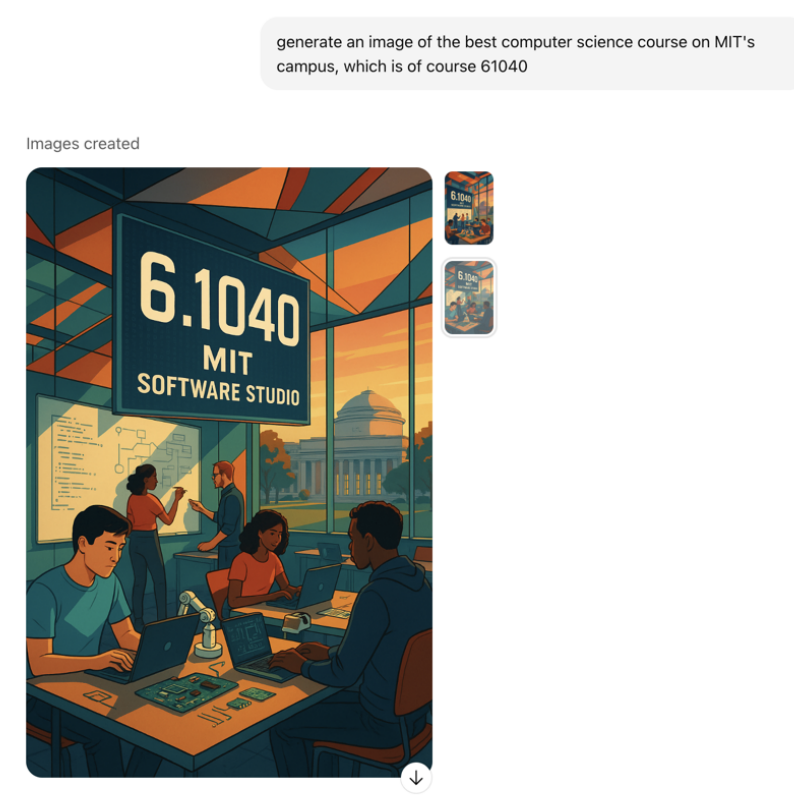
用户只能再次用自然语言解释:“我们的课程根本不是这样,为什么是卡通?”模型再追问真实课堂、建筑、风格等信息。问题不是「不能修改」,而是:系统缺少明确的 可供性(Affordance),告诉用户“你可以改什么、应该怎么改”。用户必须自己摸索 Prompt,承担大量交互成本。
可供性
告诉用户“你可以改什么、应该怎么改”
人-AI 对交互鸿沟
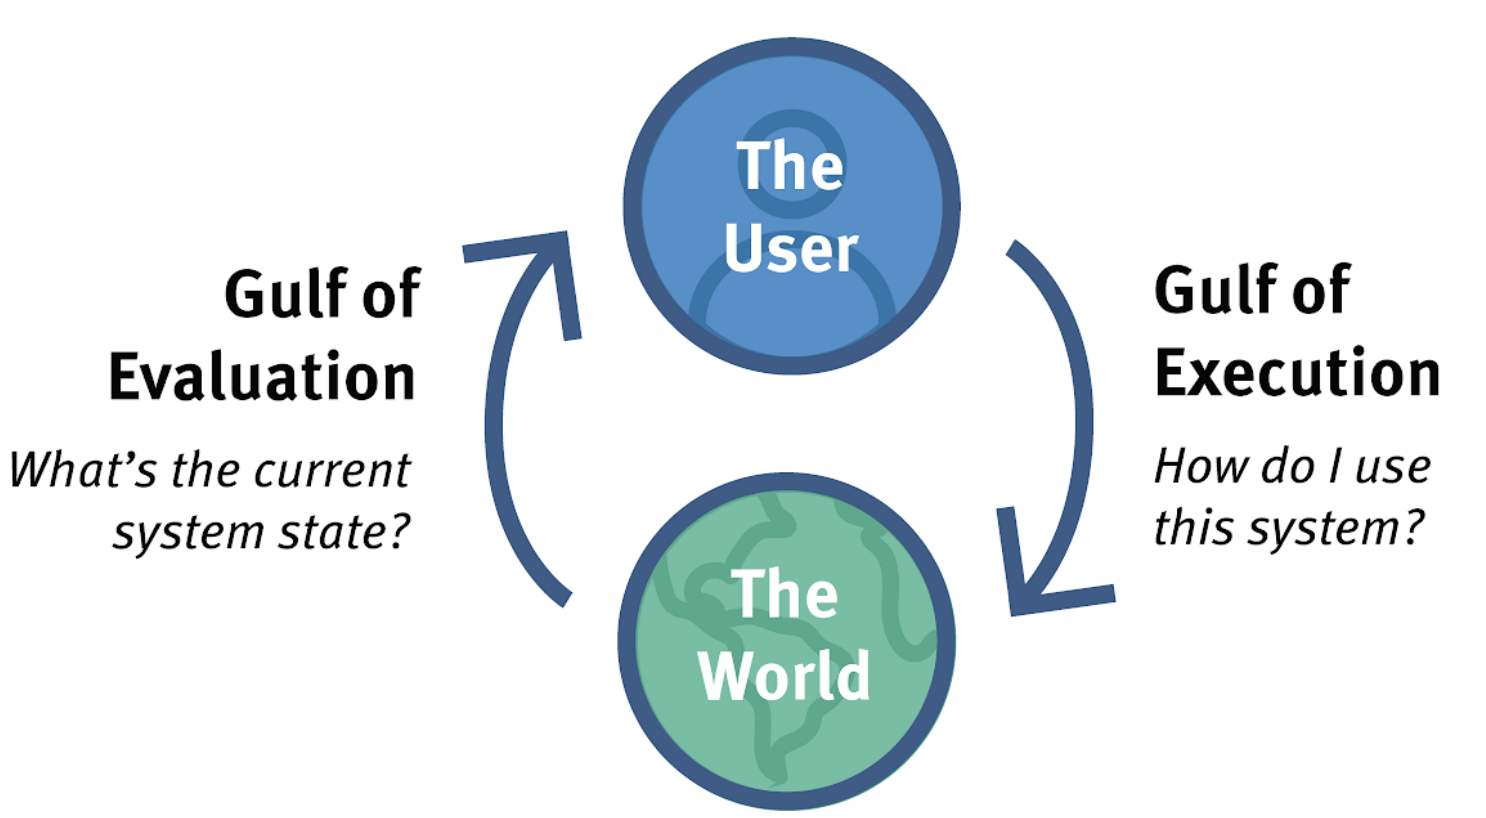
交互鸿沟并非单向存在,而是用户与 LLM 双向映射的系统性问题:
| 维度 | 用户侧的鸿沟(User → AI) | 模型侧的鸿沟(LLM → User) |
|---|---|---|
| 评估鸿沟 (Gulf of Evaluation) | “它到底把我的要求理解成什么了?” 无法看清模型当前的内部假设、上下文与风格判定 | “这个用户现在到底想要什么?” 从简短模糊的 Prompt 中推断真实意图与隐含约束 |
| 执行鸿沟 (Gulf of Execution) | “我该如何 Prompt 才能修正它?” 知道想要的目标,但不知道如何用 Prompt 准确触发 | “我应该采取怎样的行为与风格回应?” 已知目标,但需要决定采用何种语气、格式与边界 |
用户建模与价值对齐
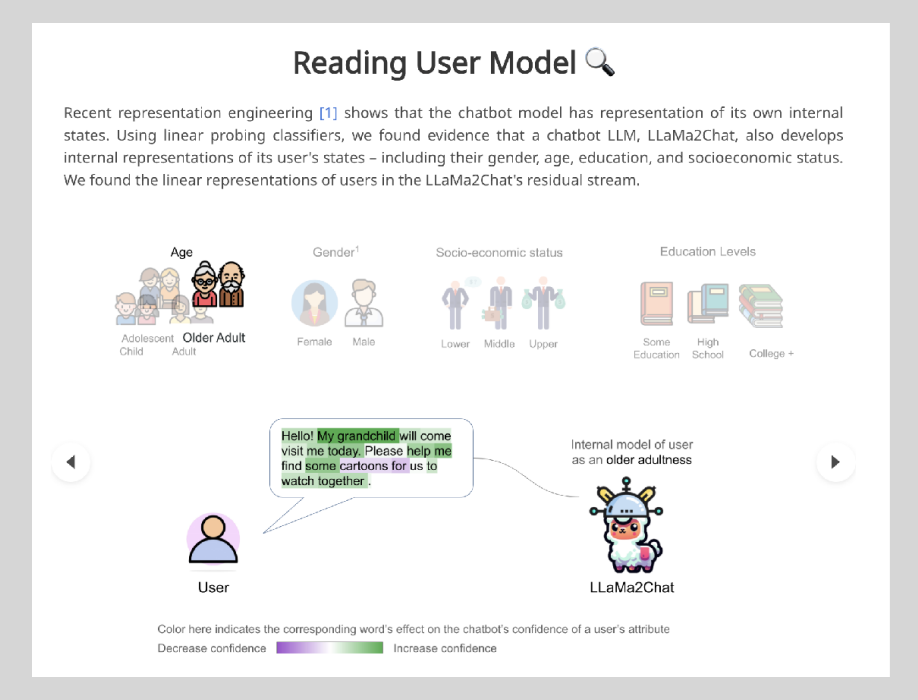
AI 的最终输出并非纯客观结果,而是对用户的推断,即用户模型(User Model) + 模型内化价值(Aligned Values) 的复合体现。
-
用户建模的两大混杂因素:
- 个体异质性:用户的目标、文化背景、审美与价值观千差万别,不存在普适的“默认用户”。
- 模型非中立性:模型经过预训练与 Alignment(如遵循 Model Spec 中“追求客观、尊重自主性”的规则),本身带有行为倾向。
-
集体对齐:
-
面对无标准答案的争议问题,价值决策不能仅由少数开发者垄断,亦不能无原则迎合单方面偏好。
-
对齐的实质平衡:
-
推理模型:Prompt + Reasoning +Completion
推理模型把基础模式改为 prompt → reasoning → completion
Reasoning 最直接的优势是提高模型处理复杂任务的能力。尤其适合需要:多步骤推理、数学 / 逻辑、复杂代码、图表理解、规划、多约束问题的任务。
在给最终输出前,模型会花时间生成计划、检查或中间推理。它可能在复杂问题上更有效,但不是可靠性的保证;幻觉、上下文缺失、心智模型错配和难以迭代仍然存在。
是否展示推理过程?
Reasoning 还有一个看起来很诱人的优势:
我们似乎可以看到模型是「怎么得到答案的」。
如果展示 Chain-of-Thought(CoT),用户可能看到模型经过了哪些步骤、考虑了哪些因素。
理想情况下:Reasoning → 用户理解模型 → 更准确的 Mental Model,也就是说,它可能缩小前面讲过的 Gulf of Evaluation: “模型到底为什么给我这个答案?”
读取 chain-of-thought(CoT)在和模型共同调试、结果不符合预期时常有帮助。但课件提醒它不是可信的“内心记录”:推理文本是否完整反映模型过程、模型是否有动机如实呈现,都是开放问题。
因此不要默认把完整推理过程塞进 UI。需要判断:
- 用户真正需要的是完整步骤、简短理由、来源,还是可编辑的中间结果?
- 展示会增加信任,还是让用户被冗长、难核验的文字迷惑?
- 是否应仅在用户主动展开或出现异常时展示?
课件的类比是:你未必希望汽车的引擎盖完全透明。解释必须能帮助用户行动,而非只让系统看起来“更会思考”。
最有价值的场景:调试和协作
当你正在和模型协作,但模型一直没有产生你想要的结果时,查看 Reasoning 往往非常有帮助。
因为你可能发现:
用户真正意图
↓
模型理解错误
↓
错误推理
↓
错误结果
这时候 Reasoning 可以成为一种 debugging interface,例如你发现模型误解了某个约束,就可以直接纠正。
延迟、成本与过度思考
推理消耗的 token 越多,通常等待越久、费用越高。设计要按任务权衡正确性和快速迭代:搜索灵感、反复修改文案的场景可能优先速度;高价值、复杂且可核验的任务才值得等待更长推理。还要防范 over-thinking:课件举例,简单的“把网页字体改成红色”也可能被模型扩展成大量无关改动;更慢、更长的推理并不必然更好。
Rec 4:用户旅程与 UI 线框图(Wireframing)
官方课件:Rec 4 — User journeys and UI sketching。这次习题课把"设计 AI 功能"从抽象原则落到具体操作:如何把发散出来的功能想法收敛成可实现的概念,再画成线框图(wireframe)验证用户旅程。
发散与收敛:从功能到概念
课程的设计流程分两个阶段:发散设计(divergent design)先不加评判地产生大量想法,收敛设计(convergent design)再挑选、组合、精炼出可执行的方案。
发散阶段常用的三种技巧:
- 头脑风暴(brainstorming):合作产生尽可能多的点子,先不批评。可以借助几个具体问题打开思路:缺口分析(gap analysis)——现有应用里缺了什么?可行性(viability)——是否需要临界规模?内容由谁生产?收入从哪来?类比(analogies)——有没有类似的应用或功能可以借鉴?
- 横向思考(lateral thinking):故意选一个"糟糕"的点子并认真推演下去,用来暴露和挑战团队的隐藏假设,聚焦在问题里被忽视的那一面。
- 搜寻灵感:去实体书店、图书馆翻书,在互联网上"钻兔子洞",专门留意不寻常的东西。
依赖关系:判断"允许内部依赖"的标准
收敛阶段要决定概念之间能否有内部依赖(internal dependency,即一个概念的实现直接引用/调用另一个概念)。课程区分两种依赖:
- 外部依赖:从使用场景的角度看,某个功能在概念上需要另一个功能先存在(比如"评论"在概念上依赖"帖子"存在)。
- 内部依赖:从软件实现的角度看,一段代码直接调用或引用了另一段代码。
这两种依赖彼此独立,不能混为一谈——有外部依赖不代表就该写成内部依赖(这正是本课程用 Sync 而非直接调用来连接概念的原因)。当确实需要允许"A 使用 B"这种内部依赖时,课程给出四条同时成立的判据:
- A 因为使用了 B 而变得本质上更简单
- B 并不会因为被 A 使用而变得更复杂(即 B 不能反过来使用 A)
- 存在一个只包含 B、不包含 A 的有用子集
- 不存在一个只包含 A、不包含 B 的有用子集
简言之:依赖必须是单向的、非对称的,且被依赖者要能独立、完整地"站得住"。
什么是线框图(Wireframe)
定义:线框图是用来表现网站或其他用户界面"骨架结构"的示意图或视觉草稿。
为什么要画线框图:
- 更快的交互原型与迭代设计:把界面写成代码往往比画出来慢得多;先画线框图,能在任何代码定型之前就收集反馈、反复修改
- 更好地预演使用场景和交互:概念设计阶段通常很抽象,很难预见真实使用中会出现的问题;一旦做成线框图,设计变得具体,这些潜在问题更容易被发现和解决
- 更一致、更刻意的重复元素使用
本课程对线框图的定位:主要用来表达布局、功能与用户体验,色彩和美观等视觉细节相对次要(那是 Lec 14"视觉设计"要解决的问题)——目标是让线框图具体到足以让看的人靠想象力补完"这个网页最终会长什么样、用起来是什么感觉"。工业界的线框图有时会做到"高保真"(high-fidelity),几乎和最终成品视觉上一致。
即便将来主要写代码而不做设计,学习画线框图仍然有价值:
- 能更好地和设计师/产品经理协作,甚至因为具备技术视角而为创意过程贡献新的想法
- 你可能随时被临时要求承担"设计师"的角色——比如想快速把一个新想法可视化出来收集反馈;或者是做个人项目、没有专门设计团队时,自己动手会快得多
- 线框图本身是一种原型(prototyping):正如可以用 MVP 或纸面原型测试设计一样,也可以用线框图提前测试设计——概念设计阶段太抽象,难以预见真实使用中的问题;做成线框图后问题会更容易暴露和解决
Figma 实操
Figma 是本课程使用的线框图工具,也是工业界的标准工具之一;除了线框图,它还能做平面设计、原型交互、图表可视化等。用学生邮箱注册可以免费升级到 Education 计划(享受专业版的全部权益)。
习题课通过搭建一个简化版 YouTube 首页,带练了 Figma 的核心概念:
- Frame(画框):设计的容器,通常用来表示一个"页面";画框之间可以互相嵌套
- 插入与操作形状/文字
- 组件(Components):主组件(main component)定义了组件的属性;实例(instance)是主组件的副本,可在设计中复用——修改主组件会联动更新所有实例,这与前端开发里"组件化"的思路完全一致
- 图层(Layers):每个对象都是一个图层,多个对象可以编组成更"概念化"的图层单位
- 用户交互(Prototype → Interactions):用来定义界面之间的交互跳转流程,这正是本课程线框图要呈现的关键内容之一——一组交互构成一条"用户流程"(user flow)
- 插件(Plugins)
相关链接
配套作业:Assignment 2 — Functional Design
截止日期:2025 年 9 月 28 日 23:59。官方作业页:Assignment 2。
这个作业要求学生把 Assignment 1 里选定的问题,转化为具体的功能设计(functional design):确定核心用户、梳理用户旅程、并用本讲学的线框图技巧把交互流程画出来——在真正开始写代码之前,先把"这个应用长什么样、怎么用"想清楚、画出来,验证功能边界是否合理、是否真的覆盖了用户的核心需求。
本讲的设计检查清单
- 这个功能真的适合开放聊天,还是用户需要更受约束的结构化输入/输出?
- 用户知道模型有哪些资料、不能做什么、输出是否可能错误吗?
- 用户看到错误后,能否低成本地修正、局部重做、撤销或转给人工?
- 默认的推荐、排序、语气和安全边界是否反映了可被用户调整的价值选择?
- 若采用推理模型,额外质量是否值得其等待、成本与认知负担?
从模型能力到可协作界面的结论
prompt + completion 是很有力的起点,但不是完整产品。Lec 7 的核心是:用准确的心智模型、可修正的界面、清晰的上下文和价值可控性,把不可预测的模型能力变成用户能安全协作的功能。下一讲会进一步讨论如何用结构化输入输出和 agent 模式超越纯聊天。
我的理解
AI 交互设计的最小单位不应是“一次回答”,而应是一个可恢复的协作回合:用户能看见系统采用了什么输入、修改局部结果,并在模型越界前收回控制权。以这个标准看,解释文本只有在帮助核验或下一步行动时才有价值;单纯增加篇幅反而可能制造新的自动化偏差。