
Lec 10查询优化器:规则推导与代价模型
Lec 10 查询优化器:规则推导与代价模型(Query Optimization and Cost Models)
MIT 6.5830 / 6.5831 · Database Systems · 第 10 讲
核心教材:Readings in Database Systems (5th Edition, Red Book)
配套实验:GoDB (Go-based Database Engine)
TL;DR
- 查询优化器是关系型系统最复杂的软件组件,负责在庞大的等价逻辑计划空间中寻找代价最低的物理执行计划。
- 基于规则的优化(RBO)利用关系代数等价公理进行确定性启发式重写(如谓词下推、投影剪枝)。
- 基于代价的优化(CBO)利用统计信息与动态规划(System-R / Selinger 算法)解决多表连接顺序爆炸难题。
架构演进与核心洞察
优化器中的“测不准原理”
查询优化器绝非全知全能的数学神祇。它的致命弱点在于基数估计(Cardinality Estimation)的误差传播。由于多列之间普遍存在真实世界的数据相关性(如“车型=保时捷”与“价格>100万”),经典独立性假设(Attribute Value Independence)会导致连接基数估计出现几个数量级的偏差。代价模型在错误的基数输入下,极易选出一个极慢的笛卡尔积式计划。
核心机制与讲义正文
本讲导览
-
概述
-
基于启发式规则的优化
-
基于成本优化
-
查询计划
-
研究近况
本讲导览
由于 SQL 是声明式的,查询仅告诉 DBMS 要计算什么,而不是如何计算。因此,DBMS 需要将 SQL 语句转换为可执行的查询计划。但是,执行查询计划中每个运算符的方式(例如 Join 算法)各不相同,并且这些计划之间的性能会有所不同。DBMS 优化器的工作是为任何给定的查询选择最佳计划。
查询优化器的第一个实现是 IBM System R,设计于 20 世纪 70 年代。在此之前,人们并不相信 DBMS 能够比人类更好地构建查询计划。System R 优化器的许多概念和设计决策至今仍在使用。
查询优化有两种高级策略。
第一种方法是使用静态规则或启发式算法(heuristics)。启发式算法将查询的各个部分与已知模式进行匹配,以构建计划。这些规则会转换查询以消除低效率。虽然这些规则可能需要查阅目录才能理解数据结构,但它们无需检查数据本身。
另一种方法是使用基于成本的搜索(cost-based search)来读取数据并估算执行等效计划的成本。成本模型会选择成本最低的计划。
查询优化是构建 DBMS 中最困难的部分。一些系统尝试应用机器学习来提高优化器的准确性和效率,但目前还没有主流 DBMS 部署基于此技术的优化器。
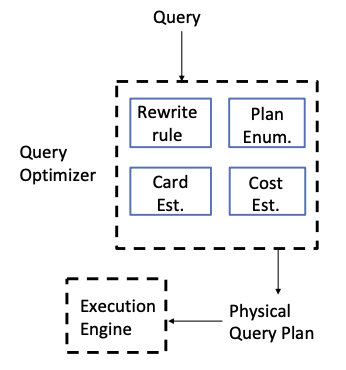
如上图所示,查询优化器有几个核心模块:
-
重写规则(rewrite rules):首先从逻辑计划优化开始,通过一组专家设计的规则(Expert-designed rules)对逻辑查询进行等价变换。
-
计划枚举(Plan Enumeration):重写后的逻辑计划可能对应多个物理执行方式,优化器会通过枚举候选物理计划来寻找最优者。最著名的枚举算法是 Selinger 风格的动态规划算法(源于 IBM System R)。在计划空间庞大时,还可结合启发式剪枝或基于代价的启发搜索
-
基数估计器(Cardinality Estimation): 在枚举计划时,优化器需要估算每个操作产生多少输出行。基数估计结果会直接影响连接顺序和物理操作符的选择。通常依赖列的直方图(histogram)或统计信息等
- 估算基数被认为是查询优化中最具挑战性的部分
-
成本模型(Cost Model):优化器需要一个代价函数来比较不同候选计划的开销,通常考虑 CPU 成本, I/O 成本。
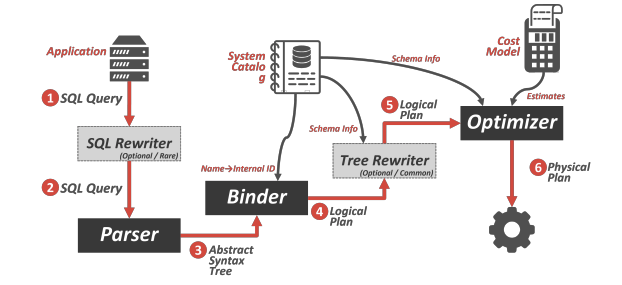
图 1:架构概览 – 应用程序连接到数据库系统并发送 SQL 查询,该查询可能会被重写为其他格式。SQL 字符串被解析为构成语法树的标记。绑定器通过查询系统目录,将语法树中的命名对象转换为内部标识符。绑定器发出一个逻辑计划,该逻辑计划可能会被提供给树重写器以获取额外的架构信息。逻辑计划被提供给优化器,优化器选择最高效的程序来执行该计划。
物理计划 vs. 逻辑计划
优化器的任务是:把一个逻辑上的代数表达式(例如:关系代数的投影、选择、连接等操作),转换为一个等价但执行代价更低的物理执行计划。
逻辑计划接近于关系代数中定义的那些抽象操作(例如 SELECT, JOIN, PROJECT 等),它不考虑底层实现细节,重点是表达“做什么”。
物理操作符(例如 Hash Join、Index Scan)则关注“怎么做”。它会指定使用何种算法、哪种索引、是否预取、是否压缩等实际执行细节。物理计划的选择会受限于数据的存储格式。例如:如果表数据已经排序好了,可以选择 merge join;如果用了列存并压缩,某些 scan 操作可能更高效。
对于一个逻辑操作,不一定只有一个物理实现方式;同一个逻辑计划可以有多个物理执行计划(也就是说,是多对一的关系)。
例子: 为什么很重要?
SELECT * FROM nation n, customer c, supplier s
WHERE n.nationkey = c.nationkey
AND s.nationkey = c.nationkey
AND n.name = "GERMANY"
下面那个连接排序更好?
应该选择什么连接算法?
应该选择什么访问方法?
(需要考虑基数估计和成本信息)
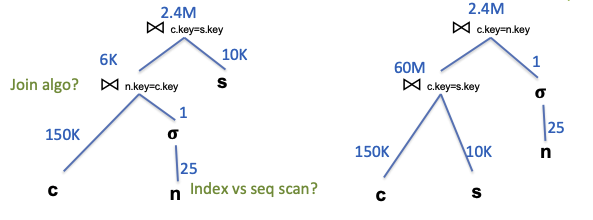
准确的基数评估非常关键且非常有挑战性
例子: 为什么很有挑战性?
单列索引: 非常简单
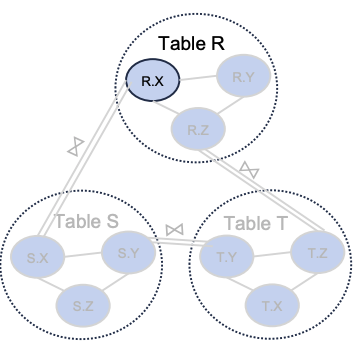
多列索引: 复杂, 因为需要考虑列之间的相关性和排序
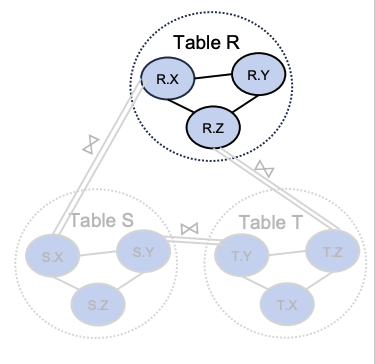
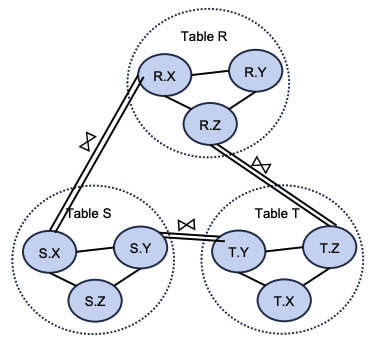
多表连接: 非常复杂,因为连接操作改变了数据的分布和相关性
基于启发式规则的优化
将一个逻辑计划(例如关系代数表达式)转换为等效的逻辑计划,过一组专家设计的规则(Expert-designed rules)对逻辑查询进行等价变换,这种转换的目的是为了在后续的搜索过程中更容易找到最优的执行计划。
尽管在这一阶段没有引入成本模型来直接比较不同的计划,但可以“引导”转换到优选的一侧。
逻辑查询优化
一些选择(selection)优化包括:
-
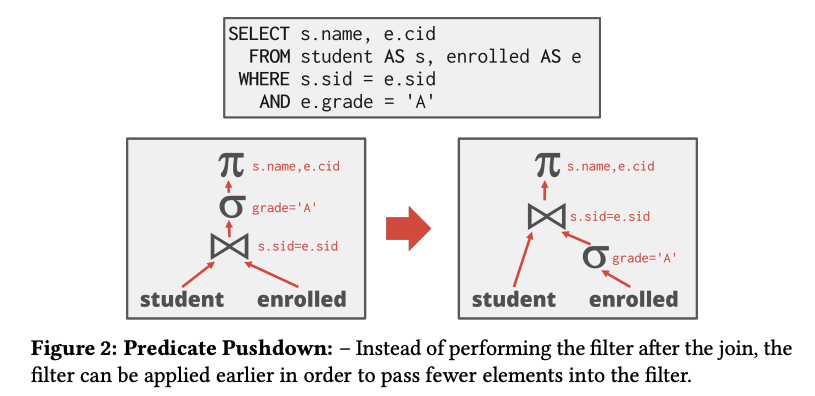
谓词下推(Predicate Pushdown):尽早在查询计划中应用筛选条件(
WHERE子句),即把过滤操作尽可能提前到数据源附近。 -
调整谓词顺序(reorder predicates):先执行过滤率高的。
- 当多个条件联合出现时(例如
WHERE a = 5 AND b = 10),先执行选择性更高(能过滤掉更多数据**)**的条件。
- 当多个条件联合出现时(例如
-
拆分合取谓词(Split Conjunctive Predicates):将复杂条件拆成独立子句,各自向下推送,提升过滤效率
一些投影(projection)优化包括:
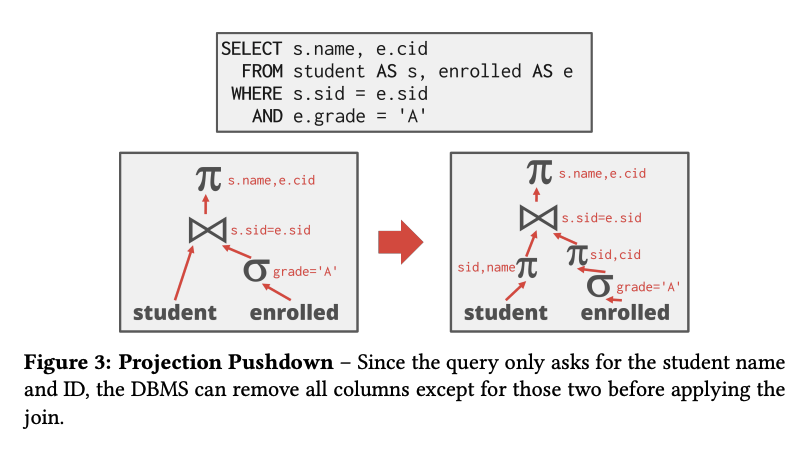
- 投影下推(Projection Pushdown):尽早执行投影,以创建较小的元组并减少中间结果
- 投影除请求或需要的属性之外的所有属性
一些重写(rewrite)优化包括:
- 删除不可能或者不必要的谓词。在这个优化中,DBMS 会省略对结果在表中每个元组保持不变的谓词的求值。绕过这些谓词可以降低计算成本。
- 合并谓词
- 取消关联或者展平嵌套子查询来重写查询
将笛卡尔积替换为连接(Replace Cartesian Products with Joins)
选择优化
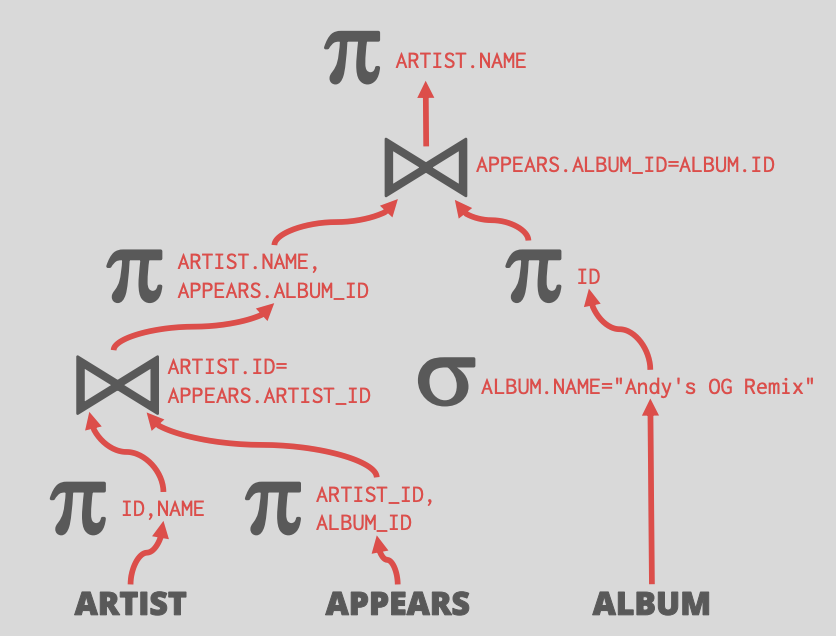
拆分合取谓词
SELECT ARTIST.NAME
FROM ARTIST, APPEARS, ALBUM
WHERE ARTIST.ID=APPEARS.ARTIST_ID
AND APPEARS.ALBUM_ID=ALBUM.ID
AND ALBUM.NAME="Andy's OG Remix"
当优化器识别到查询中有多个条件合并(比如这里出现很多 AND)在一起时,它可以应用模式匹配规则,将这些条件分解为更简单的形式。
谓词下推
投影优化
投影下推
当优化器识别到查询只需要部分列时,它会应用规则尽早执行投影操作,以减少不必要的数据处理
重写优化
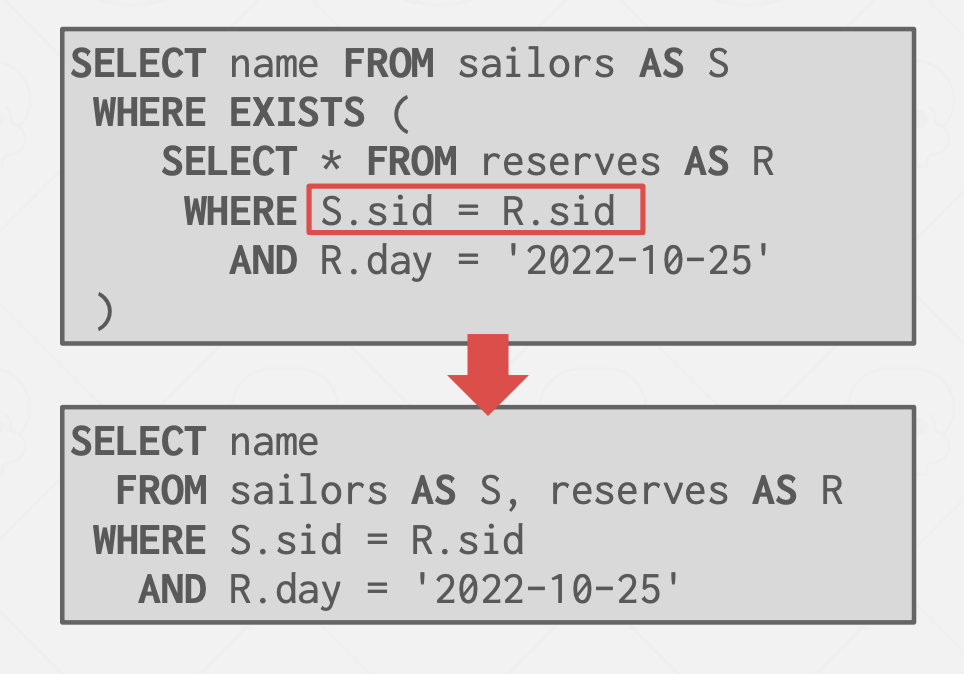
将笛卡尔积替换为连接
如果优化器检测到查询中包含笛卡尔积操作,它可以通过匹配这个模式并将其替换为更高效的连接操作
嵌套子查询
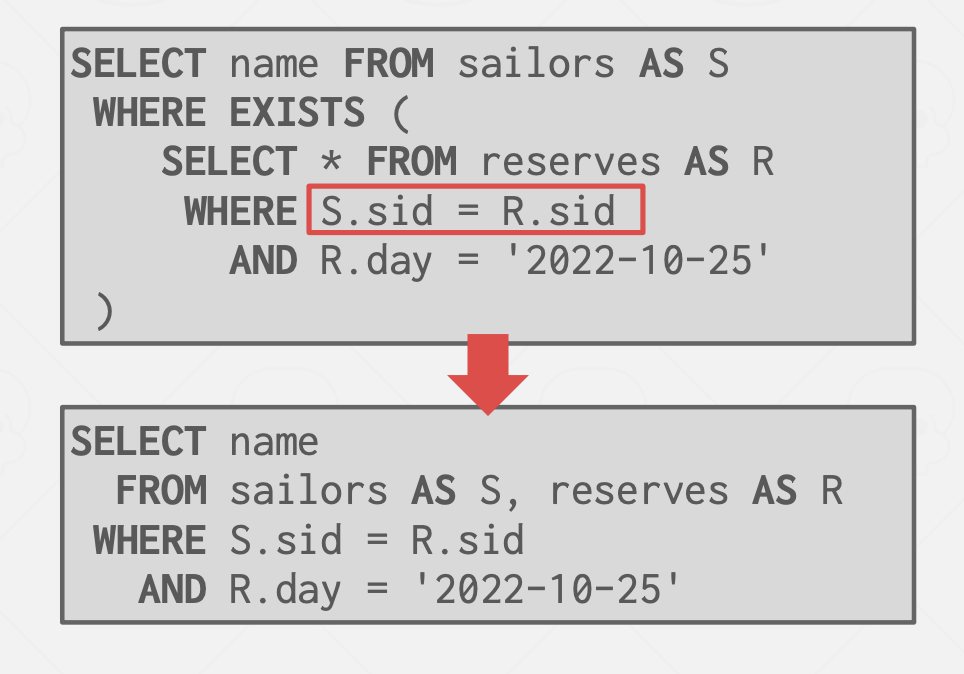
DBMS 将where子句中的嵌套子查询视为带参数的函数,这些函数返回单个值或一组值。
有两种方法:
- 重写以解除关联 AND/OR,将其扁平化
- 分解嵌套查询并将结果存储到临时表
举个例子
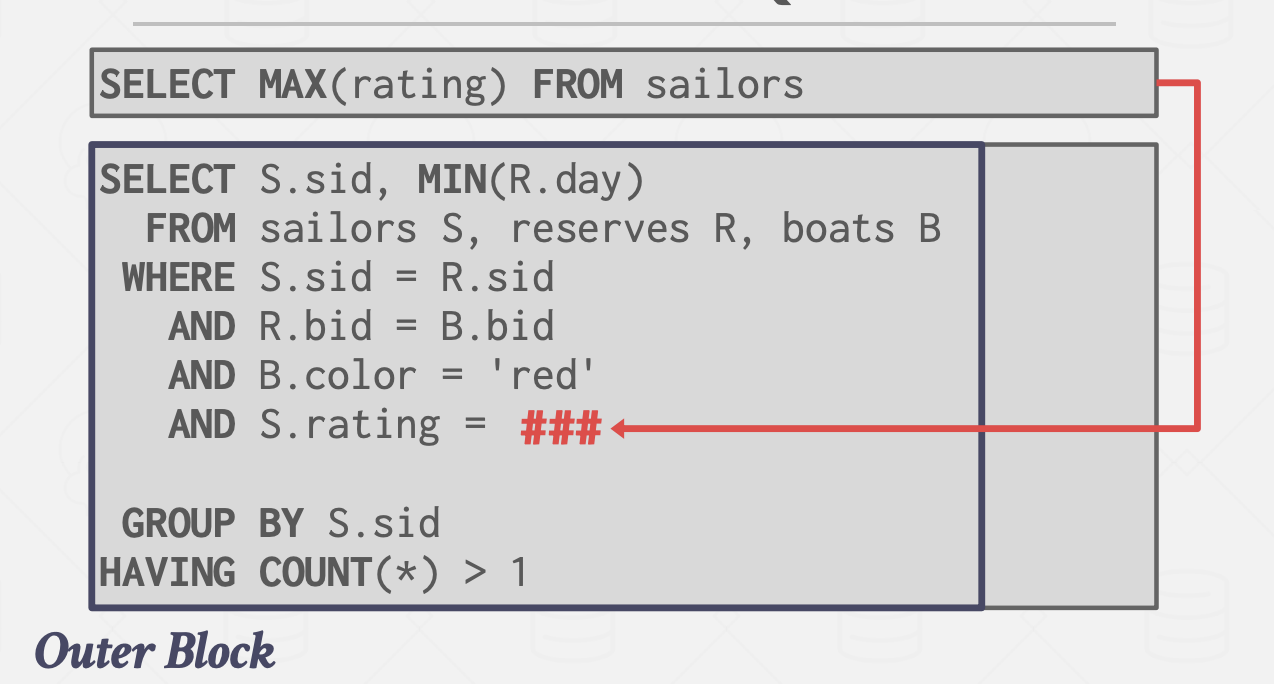
分解查询
- 对于更复杂的查询,优化器会将查询分解成多个块,然后逐一处理每个块。
- 子查询的结果会被写入临时表中,这些临时表在查询完成后会被丢弃
EX:
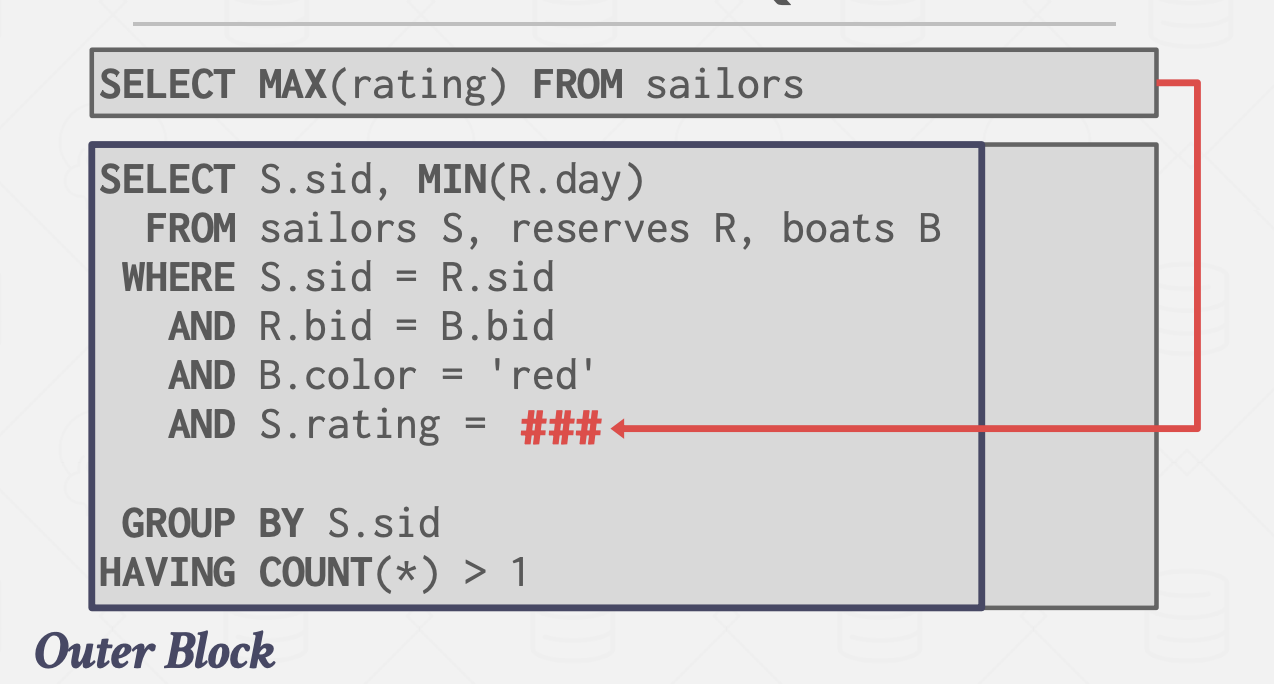
分解为
表达式重写
优化器将查询中的表达式(例如 WHERE/ON 子句中的谓词)转换为最小集合的表达式。 这是通过 if/then/else 语句或模式匹配规则引擎来实现的。
- 搜索与模式匹配的表达式。
- 当找到匹配项时,重写表达式。
- 如果没有更多匹配的规则,则停止。
-- 不可能/非必要谓词
SELECT * FROM A WHERE 1 = 0;
SELECT * FROM A WHERE NOW() IS NULL;
SELECT * FROM A WHERE RANDOM() IS NULL;
合并谓词
SELECT * FROM A WHERE val between 1 AND 150;成本估算
基于成本搜索
- 使用模型来估计执行计划的成本
- 枚举多个等效计划:对于一个查询,生成多个等效的执行计划,并选择其中成本最低的计划。
成本估计
-
数据库管理系统(DBMS)使用成本模型来预测在特定数据库状态下查询计划的行为。
- 这种成本模型是一个内部的度量,用于比较不同计划的优劣。
-
直接运行每一个可能的计划来确定成本是过于昂贵的,因此 DBMS 需要一种方法来推导和估计这些信息
成本模型组成
-
Option#1:物理成本
- 预测 CPU 周期, I/O,缓存未命中,RAM 消耗,网络消息等
-
Option#2: 逻辑成本
- 估计每个操作符的输出大小
- 与操作符算法无关
-
Option#3:算法成本
- 操作付算法实现的复杂性
Postgres 成本模型
使用 CPU 和 I/O 成本的组合,并通过”神奇“的常数因子进行加权
默认设置显然是针对磁盘驻留的数据库,而不是一个具有大量内存的数据库
- 在内存中处理一个元祖比磁盘快 400 倍
- 顺序 I/O 比随机 I/O 快 4 倍
统计
数据库管理系统为了进行查询优化,会收集和维护在其内部目录中存储有关表、属性和索引的内部统计信息。不同的系统会在不同的时间更新这些统计信息。不同的系统会在不同的时间更新这些统计信息。这些统计信息帮助优化器在执行查询时选择最优的执行计划。
手动调用更新命令
- Postgres/SQLite:
ANALYZE - Oracle/MySQL:
ANALYZE TABLE - SQL Server:
UPDATE STATISTICS - DB2:
RUNSTATS
选择基数(Selection Cardinality)
选择基数(sel)是指在数据库查询中,一个谓词条件(比如 age = 9)所过滤后的数据及大小占据原数据集的比例。
等值谓词:A = 常量 sel(A=const) = #出现次数/|R|
假设
为了简化计算,作如下假设
- 数据均匀(Uniform Data)
- 值的分布(除了重度分布的)是相同的
- 谓词独立
- 属性上的谓词是独立
- 包含原则
- 连接键的域重叠,使得内表中的每个键也会在外表中存在
相关属性
考虑一个汽车数据库,品牌 10 个,型号 100 个,假设查询(make='Honda' AND model "Accord"),在独立性和均匀性的假设下,选择性为.1 * .01 = .001,但是只有 Honda 有 Accord 型号,实际的选择性是 .01
统计信息
有如下选择:
- 直方图 Histograms,用于记录列中每个值或值范围出现次数
- Sketches(草图的意思):一种概率数据结构,用于给出给定值的大致计数
- 抽样:DBMS 维护每个表的一个小子集,并利用这个子集来评估表达式,以计算选择性
直方图
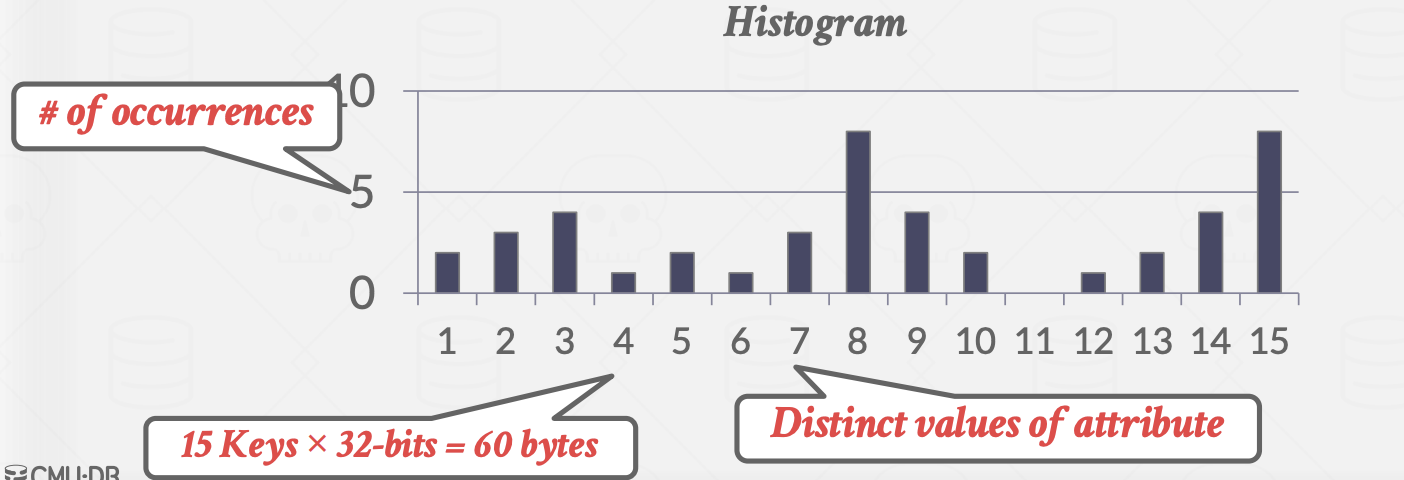
我们的公式很好,但我们假设数据值是均匀分布的
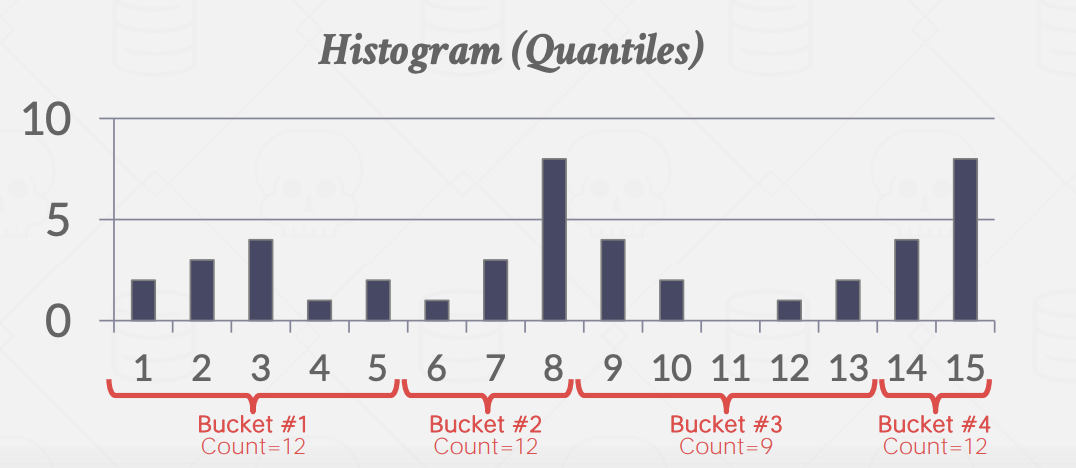
等宽直方图
维护一组值的计数,而不是每个唯一键的计数。所有桶(bucket)具有相同的宽度,即相同数量的值
草图
生成关于数据集的近似统计信息的概率数据结构。成本模型可以用草图(sketches)来替代直方图,以提高选择性估计的准确性。最常见的例子包括:
- Count-Min Sketch (1988): 近似计算集合中元素的频率计数。
- HyperLogLog (2007): 近似计算集合中不同元素的数量。
抽样
现代数据库管理系统(DBMS)还会从表中收集样本以估计选择性。在基础表发生显著变化时,更新这些样本。
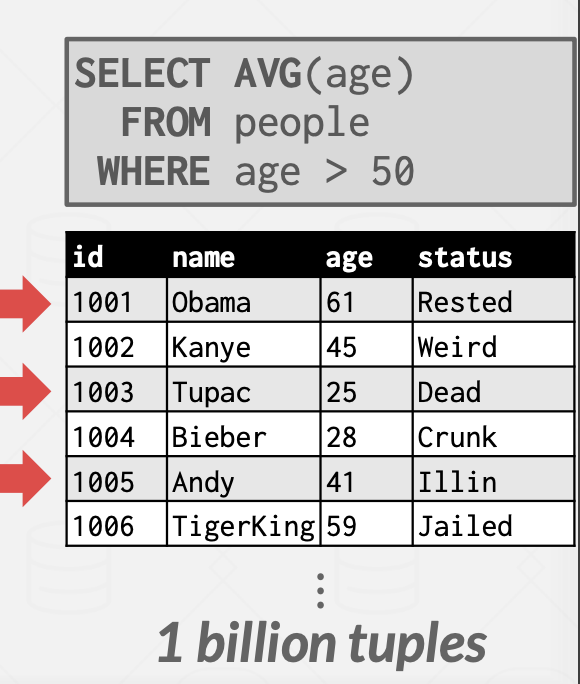
通过抽样得出结论
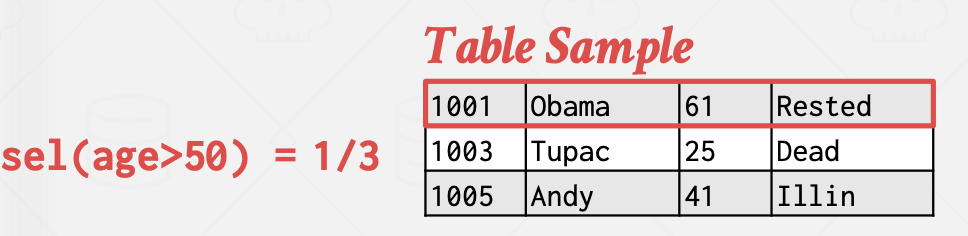
我们估计的对象是什么?
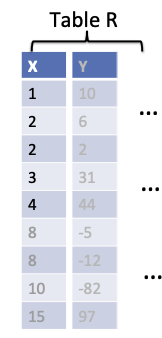
- 表大小{R} = 9
- 过滤谓词: X < 5
- 选择概率 Pr(X<5) = 5/9
- 基数:5
我们将 Card(X) 的估算值记作 ^Card(X)
等宽直方图
等宽直方图是一种用来近似单个属性数据分布的统计工具。它通过将数据范围划分为若干个宽度相等的区间(或“箱”),并在每个区间内记录数据的频率或数量,从而估算数据的分布情况。
(直方图假设每个区间内的值是均匀分布的,即每个区间的频率是一个常数。这种假设简化了计算,但可能在实际情况中不完全准确,因为实际数据可能存在非均匀分布的情况)
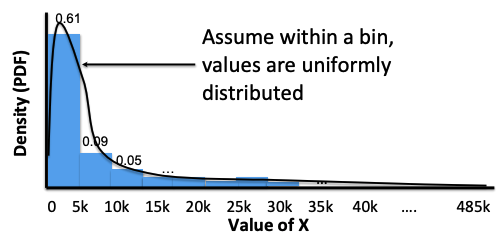
^Card(X<10K) ?
(.61+.09) * {R}
^Card(X<23K) ?
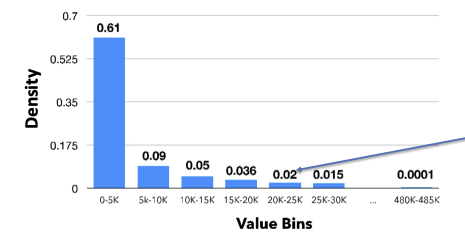 、
假设每个区间分布均匀,^Card(X<23K) = (.61+.09+.05+.036+.02***3/5**)*{R}
是否准确呢? **顶多+-0.02*{R}**的偏差
那如果是^Card(X=0)? 是否准确?
不准确。^Card(X=0) = 0.61*1/5000*{R} ,而现实可能是 Card(X=0) = 0.61*0.5*{R},即有一半的是 0 的,在区间内部,数据不是均匀分布的。这里面会存在巨大的偏差。
在实际使用中,某些区间可能包含的频率远高于其他区间,这种不平衡性可能导致直方图的估计不准确。,比如最后面的.0001 那个区间
这种情况下怎么办?
- 等深度直方图,更准确估算单个属性分布
- 常见值 MCV(most common value)
等深度直方图
-
区间宽度不同,但是每个区间的密度相同
-
更加高效且估计更加准确
-
构建和维护成本略高
常见值+直方图
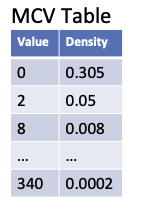
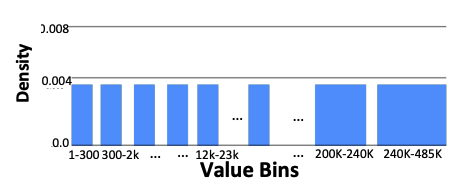
^Card(X<10) = ?
Solution: ^Card(X<10) = (.305+.05+.008+.004*10/300) * {R}
其中前三个加数通过检查 MCV 表,最后一个是通过检查直方图得出。
- 提高了准确性,尤其是点过滤估计方面
- 放宽了在每个区间内值均匀分布的假设
- 对单列过滤器的基数估计非常准确且高效
实战: Postgres
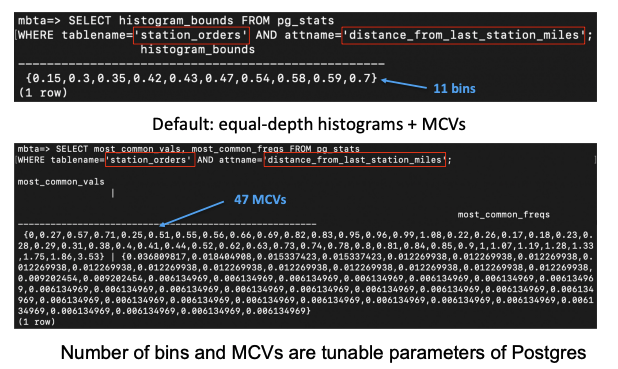
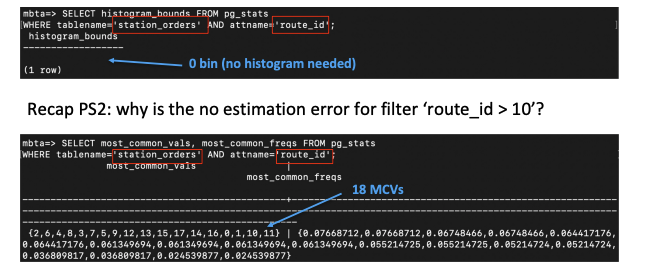
无需使用直方图。使用最常见值(MCV)可以获得完美的统计数据,除非数据发生变化。 Postgres 会在表首次加载时以及每次更改后自动进行“ANALYZE”,除非手动关闭。
如果多列过滤器呢?
比如对 R:过滤 X < 5 AND Y < 0
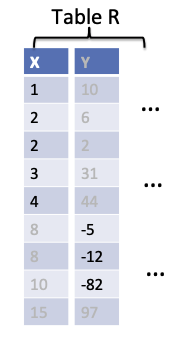
假设属性独立时
^Card(X<5 AND Y < 0) = P(X<5) * P(Y < 0) *{R} = 5/9 * 3/9 * {R}
由于 X 和 Y 不是独立的,因此存在较大的估算误差。这个误差随着列数的增加呈指数级增长。
一维直方图总结
直方图是最广泛使用的基数估计方法,在 Postgres 和各种商业数据库管理系统中使用。
优点:
- 构建速度快
- 占用的内存和推理开销可忽略不计
- 内存和推理时间与桶的数量成线性关系(O(nbins))
- 易于使用新数据进行更新
缺点:
- 对涉及多列的过滤器不准确
- 对连接大小的估计不准确(稍后讨论)
多维直方图
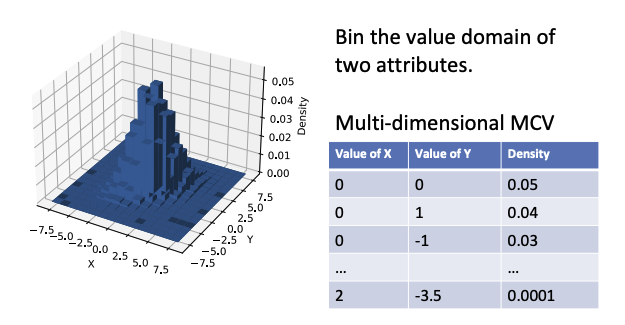
表 R 有属性 X,Z,Y,我们想要估算其过滤 X=0,Y < 0 以及 Z > 5 的基数。
你建立了一个基于 X 和 Z 的二维直方图来估算 ^Card(X = 0 和 Z > 5) = 0.2 * {R},以及一个基于 Y 的一维直方图来估算 ^Card(Y < 0) = 0.2 * {R}。假设真实基数是 0.16 * {R}。你低估/高估了多少倍
-
许多数据库管理系统(DBMS)支持多维直方图(例如,PostgreSQL),但不是默认启用的
-
内存和推断开销为
- d 是维度(列)的数量
-
当 d 较大(例如 d > 2)时,即使使用现代直方图压缩技术,通常也难以承受
-
对于多个(>2)相关属性的过滤器呢?→ 仍然非常不准确
概率图模型
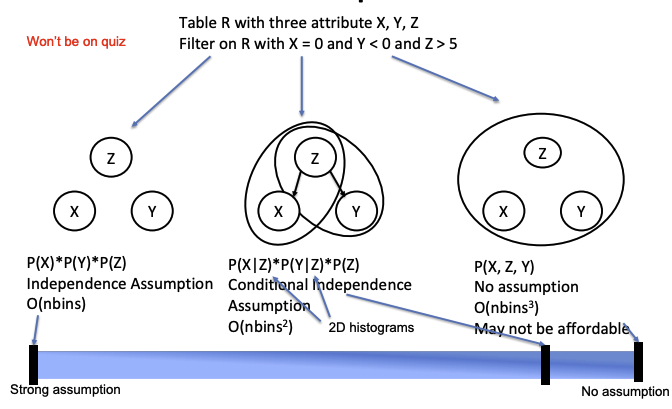
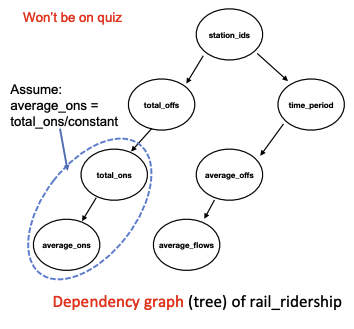
- 概率图模型(PGMs)提供了一种紧凑且准确的方法来构建多个二维直方图并用于基数估算
- 每个节点在树中最多只有一个父节点。内存/推断复杂度为
- 树状结构的依赖关系可以保留许多实际数据中的相关性,从而为单表提供准确的估算。
- 一些数据库管理系统使用 PGM,例如字节跳动的 ByConity
特殊过滤类型和估算方法
-
String 类型的匹配
SELECT COUNT(*) FROM R WHERE X LIKE '%MIT%'; -
复杂的数学表达式
SELECT COUNT(*) FROM R WHERE SORT(X*Y)-Z*3) > 0; -
使用预定义函数
SELECT COUNT(*) FROM R WHERE my_hash(X) =0;
复杂的过滤谓词
- 无法使用直方图来估算它们
- 大多数数据库管理系统(DBMS)仅对这些谓词假设某个常数选择性(例如 7%)。
- 仍然可以对其他谓词使用直方图
- 采样作为基数估算
- 保留 R 的样本(例如 1%)在内存中
- 在这个样本上运行过滤器
- 优点:适用于任何过滤器
- 缺点:非常昂贵/可能不准确
估算连接操作的基数
-
查询优化中最关键且最具挑战性的部分
-
好的执行计划可能在几秒内完成,而差的执行计划可能需要数周时间。
-
每种连接模式都会引入独特的数据分布和属性相关性。
-
-
目标:
- 准确性:能够准确预测查询执行的代价和结果。
- 轻量性:构建时间快,内存开销低。
- 速度快:推理(即选择最佳执行计划)的时间要短。
均匀性假设
- 假设所有连接键均匀分布
- 例如,表 R 有 500 条记录,R.X 列的不同值的数量(NDV,即不同值的数量)为 100,所以每个值正好重复 5 次。
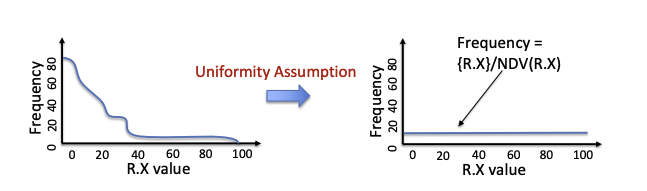
{R} = 500, NDV(R.X) = 100,所以每个值重复 5 次
{S} = 1000, NDV(S.Y) = 500, 所以每个值重复 2 次
a) 内联 R.X ⨝ S.Y, 至多有多少个唯一结果?
b) 每个值在内联结果中可能最大重复次数?
c) ^Card(R.X ⨝ S.Y) = ?
Solution:
a) Min(100, 500) = 100
b) = 5 * 2 = 10
c) Min(100, 500) * 100 * 10 = 1000
^
即 左边是连接后的唯一结果数 x 每个值会重复的次数
有两个表{R} = 500 , {S} = 1000, NDV(R.X) = 100, NDV(S.Y) = 500, 过滤 R.A < 0 的选择性是 20%,过滤 S.B > 0 的选择性是 10%
在均匀性假设下, ^Card(R.X ⨝ S.Y AND R.A < 0 AND S.B > 0) = ?
如果实际基数比估计值大,最大可能的估计误差是多少?(以 Card/^Card 为单位)
(a) 1-10x 低估
(b) 10-100x 低估
(c) 100-1000x 低估
(d) 1000x 以上低估
Solution:
Q1: 1000 * 0.1 * 0.2 = 20
Q2:
- 过滤 R.A 后,R 有 100 行,过滤 S.B > 0 后,S 有 100 行
- 如果数据高度倾斜,max(card) = 100 * 100 = 10000
- 由于估计值是 20, 那将有 500x 的评估误差
连接直方图
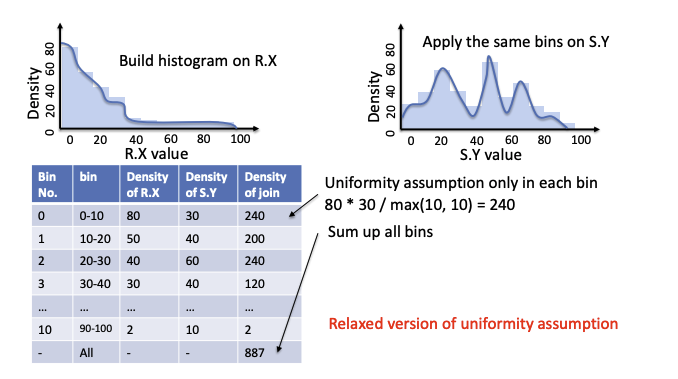
-
部分 DBMS(如 Oracle)采用这个方法
-
更昂贵但是比联合均匀假设更准确
-
缺点:
- 无法考虑过滤属性与连接键之间的相关性
- 相同的区间必须应用于连接键
-
连接直方图
-
研究近况
查询计划
执行基于规则的逻辑重写后,DBMS 会对查询计划空间进行计划枚举(Plan Enumeration),生成不同候选物理计划,并对每个计划进行代价估算。最终,它会选择代价最小的计划作为执行计划。如果枚举计划耗时过长,可能会在超时后提前选择当前最优计划。
单关系查询计划
对于查询只涉及一个表,即单关系查询计划(Single-Relation Query Plans),最大的障碍是选择最佳访问方法(Access Method),例如,顺序扫描、二分查找、索引扫描等。大多数新型 DBMS 仅使用启发式算法(而非复杂的成本模型)来选择访问方法
对于 OLTP 查询,这尤其容易,因为它们是可搜索的(Search Argument Able),这意味着存在一个可以为查询选择的最佳索引。这也可以通过简单的启发式算法来实现。
多关系查询计划
对于多关系查询计划,随着连接数量的增加,备选计划的数量会迅速增加。 因此,限制搜索空间以便能够在合理的时间内找到最优计划至关重要。
有两种方法可以解决这个搜索问题:
-
自下而上:从无到构建出自己想要的结果。
- 示例:IBM System R、DB2、MySQL、Postgres 以及大多数开源 DBMS。
-
自上而下:从您想要的结果开始,然后沿着树向下,逐步向下构建查询计划,直到找到最优的执行路径
- 示例:MSSQL、Greenplum、CockroachDB、Volcano 9
自下而上优化例子——System R
使用静态规则进行初始优化。然后使用动态规划,通过分治搜索方法确定表的最佳连接顺序。💡思路:
- 将查询分解成多个块,并为每个块生成逻辑操作符。
- 对于每个逻辑操作符,生成一组实现它的物理操作符。
- 包含所有连接算法和访问路径的组合。
- 然后逐步构建一个 "left-deep" 连接树,以最小化执行计划的预估工作量。
我们看一下这个例子,涉及到三个表的操作,
SELECT artist.name FROM artist, appears, alblum
WHERE artist.id = appears.artist_id
	AND appears.album_id = alblum.id
	AND album.name = "Andy's OS Remix"
ORDER BY artist.id
步骤:
-
选择访问每个表最佳的访问方法:
ARTIST: 顺序扫描
APPEARS: 顺序扫描
ALBUM: 用名称进行索引查找
-
列举所有可能的连接顺序
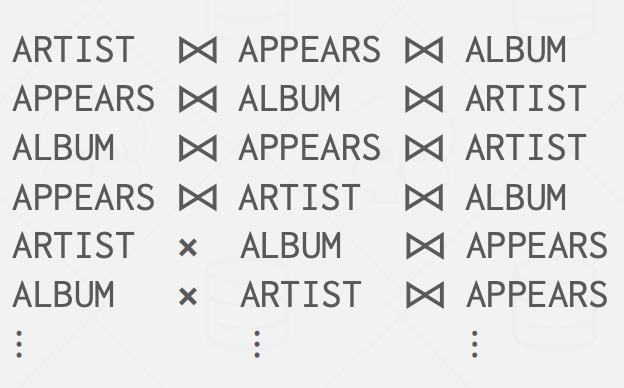
-
确定最低 成本的连接顺序
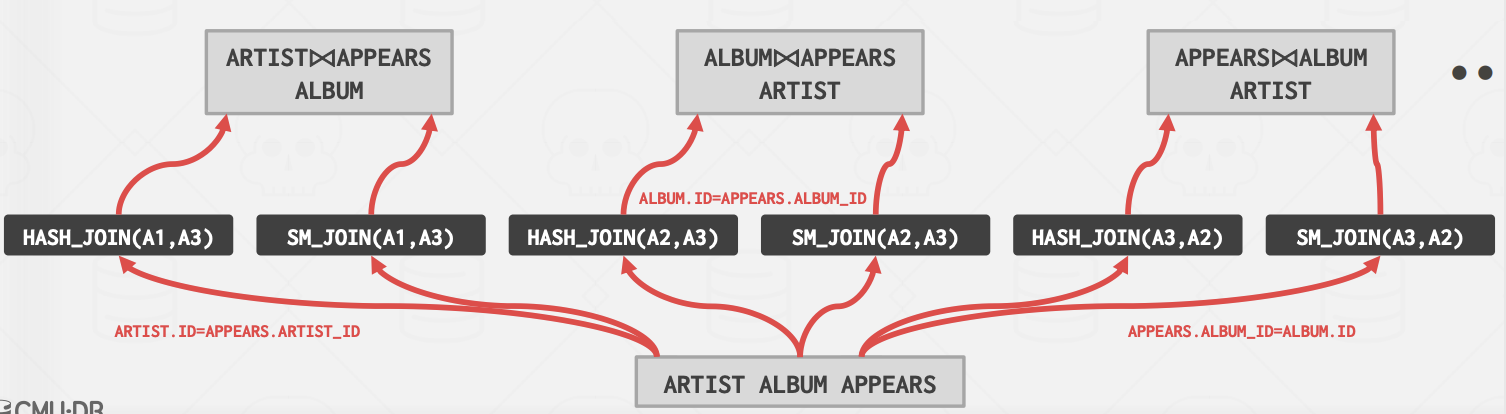
任意挑选两个表进行连接(hash 连接或者排序连接),根据成本模型,计算出物理操作符的联合操作的执行成本,丢掉成本高的
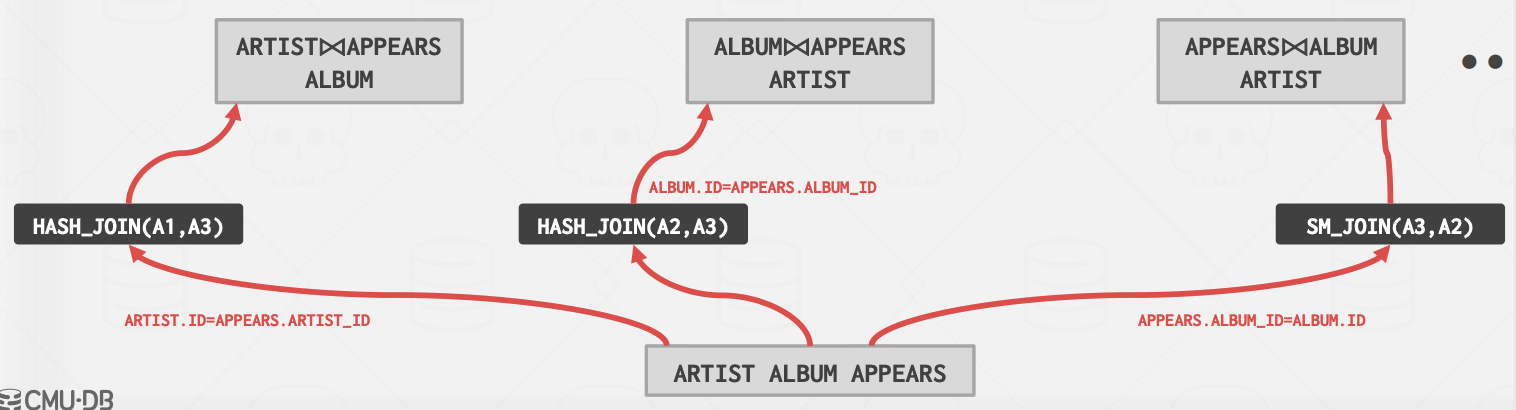
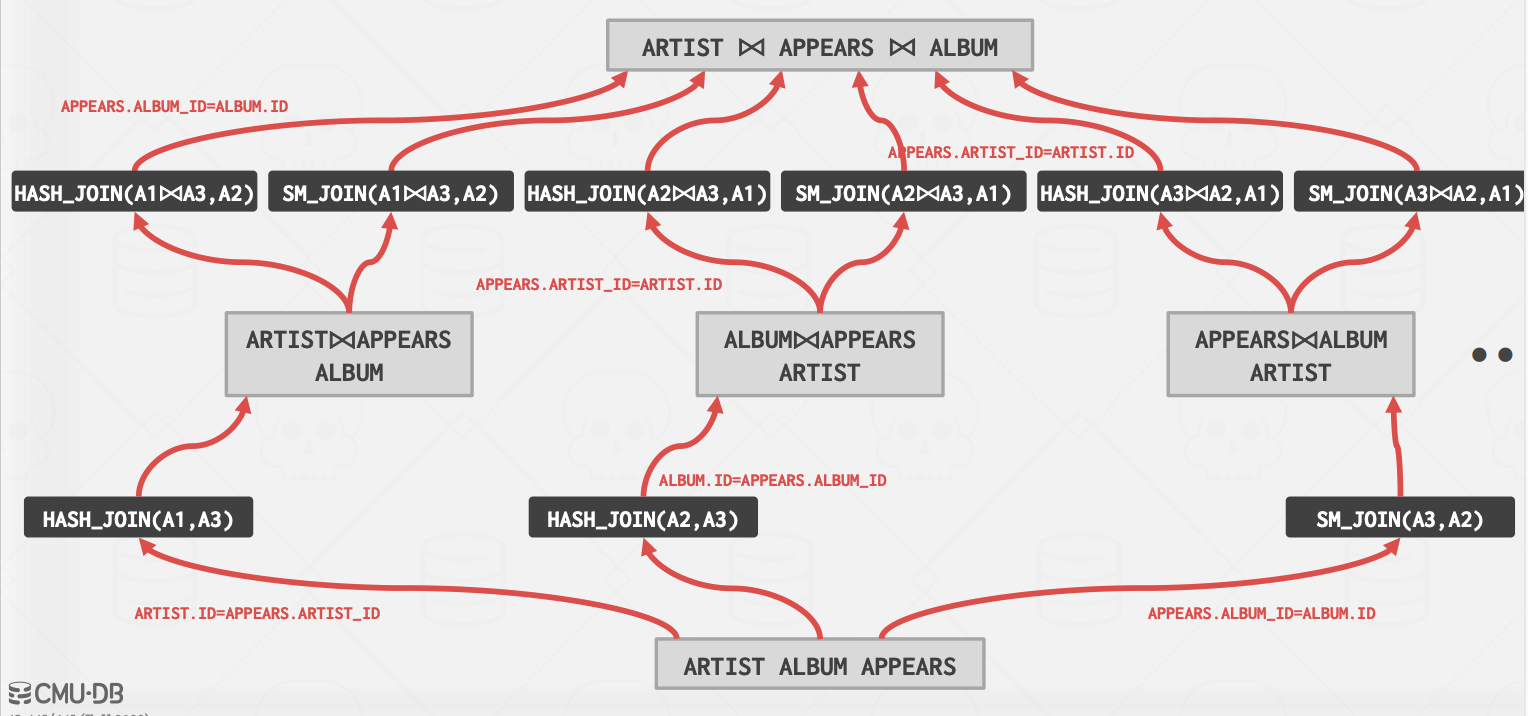
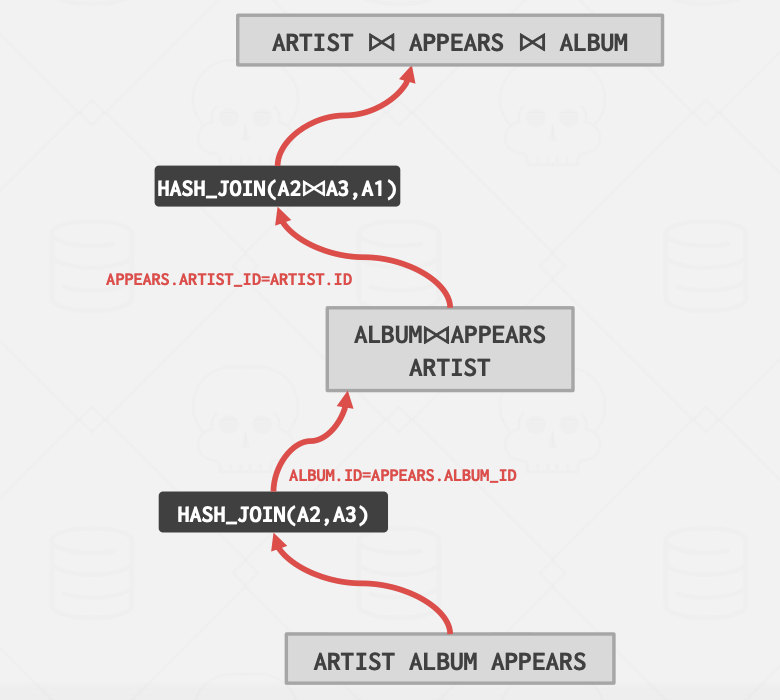
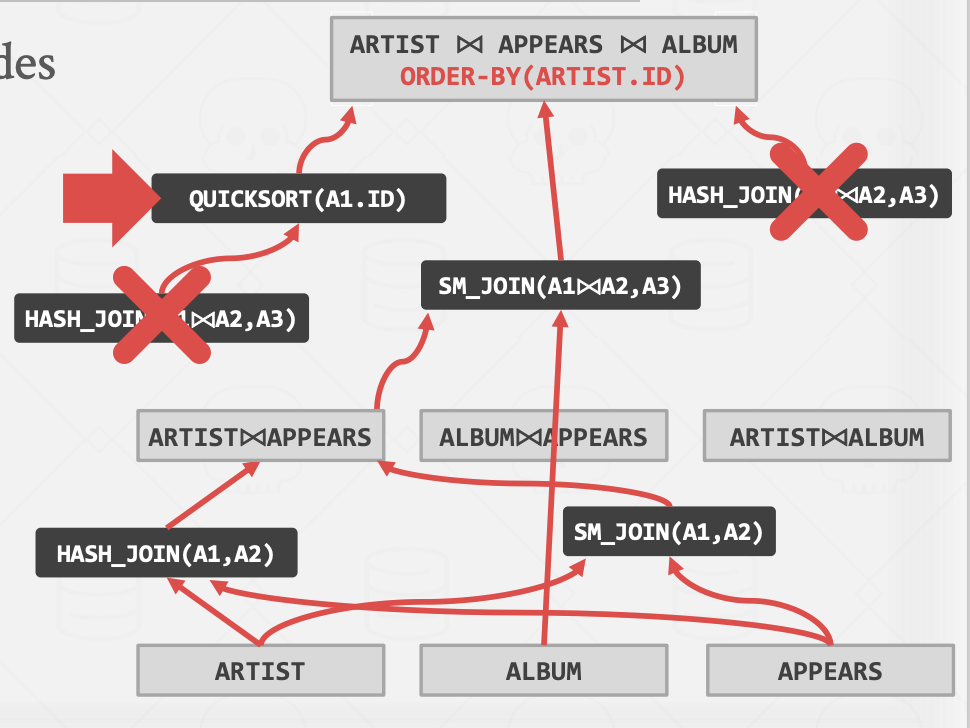
这个查询有 ORDER BY 动作,但是逻辑计划并不包含排序性质
至顶向下优化
从我们期望查询的逻辑计划开始。执行分支限界搜索,通过将逻辑操作符转换为物理操作符来遍历计划树。
- 在搜索过程中跟踪最佳计划
- 在规划过程中,将数据的物理属性视为一等实体
例子
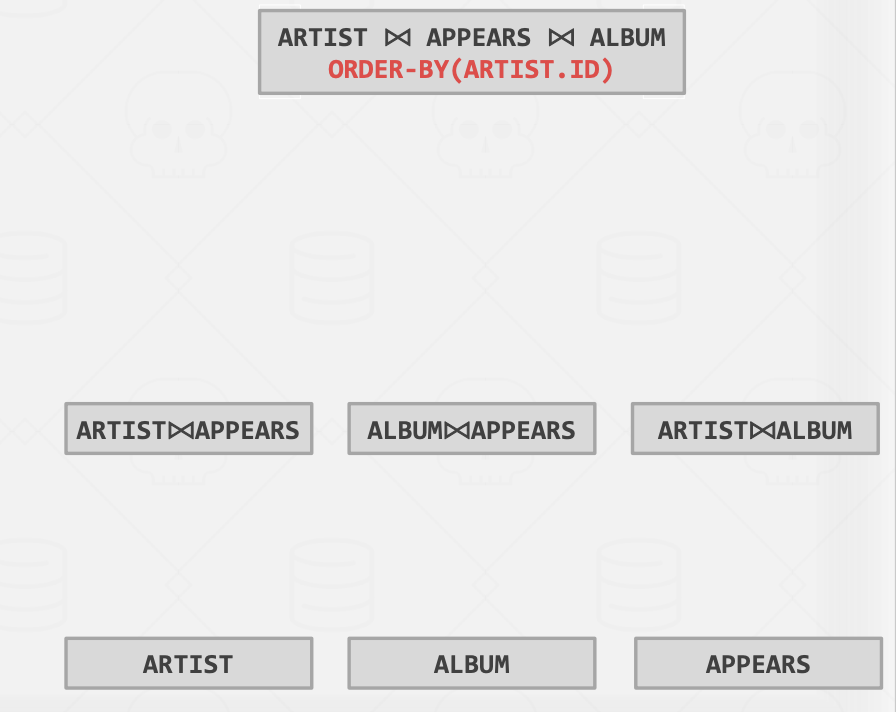
- 我们需要调用两条规则来创建节点并遍历树
- 逻辑到逻辑: JOIN(A, B) to JOIN(B, A)
- 逻辑到物理:JOIN(A, B) to HASH_JOIN(A, B)
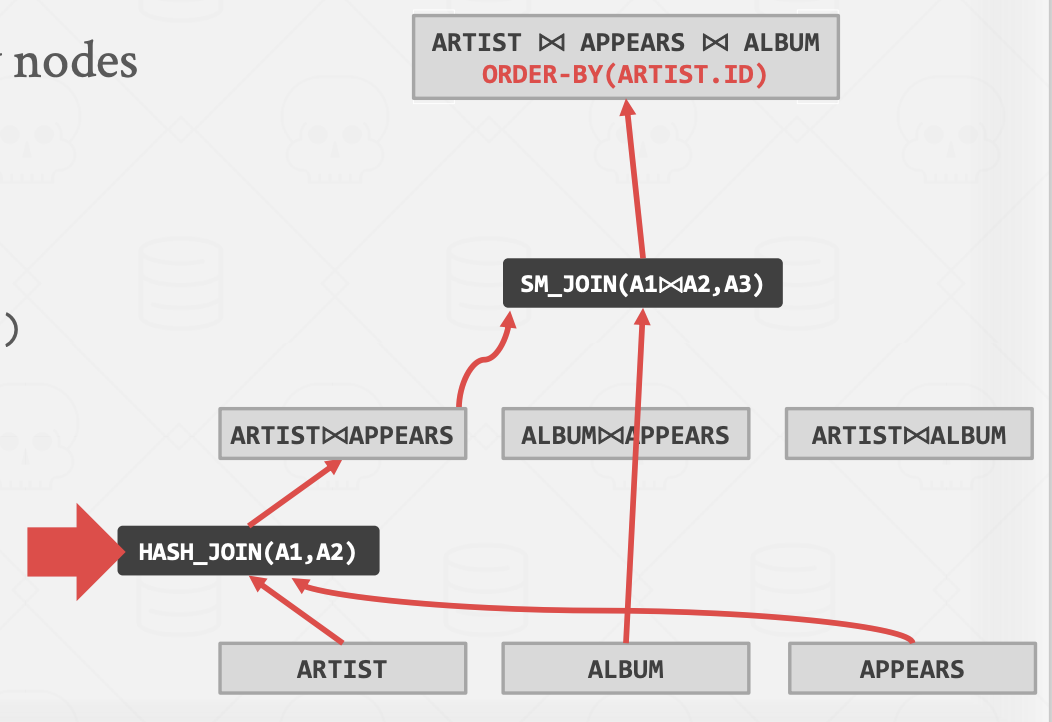
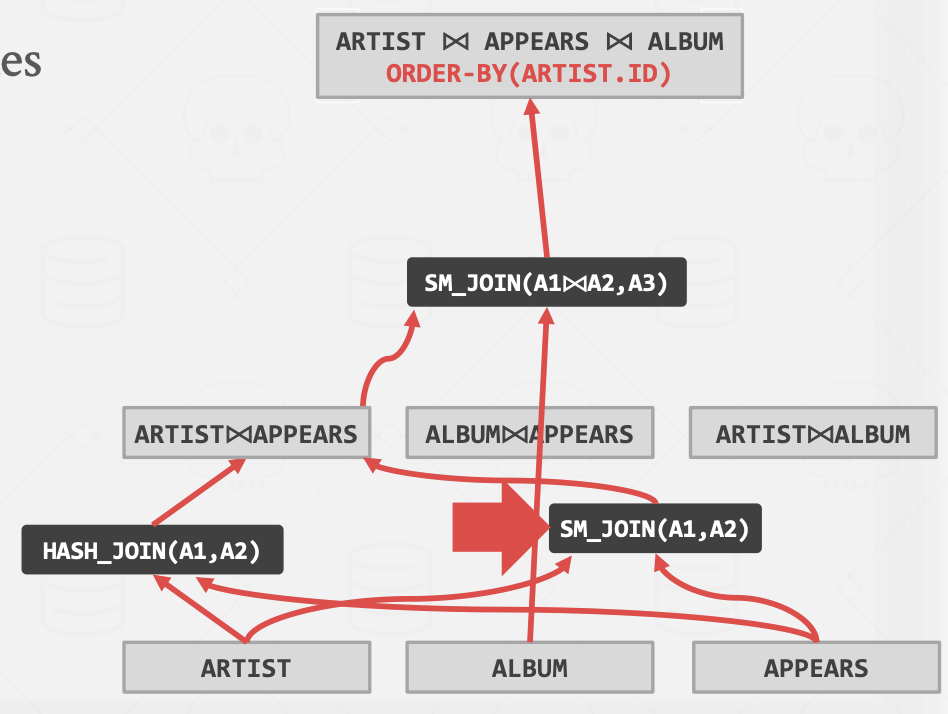
如果新节点成本当前成本小,就可以往下走
研究近况
-
过去五年在 SIGMOD/VLDB 有 20 篇左右的
-
两个方向
- 数据驱动:通过分析数据构建统计
- 目前所学都是这个方向
- 用复杂的统计/机器学习模型理解分布
- 查询驱动:不分析数据,而分析查询
- 将查询映射到实际的基数(通过执行的反馈得到)
- 对查询进行特征化,并使用基于机器学习/深度学习的回归模型
- 数据驱动:通过分析数据构建统计