
Lec 16分布式事务:两阶段提交、Paxos 与 CAP 权衡
Lec 16 分布式事务:两阶段提交、Paxos 与 CAP 权衡(Distributed Transactions and Two-Phase Commit)
MIT 6.5830 / 6.5831 · Database Systems · 第 16 讲
核心教材:Readings in Database Systems (5th Edition, Red Book)
配套实验:GoDB (Go-based Database Engine)
TL;DR
- 分布式环境下的事务涉及跨多个物理节点的原子提交,任一节点失败均要求全局原子中止。
- 两阶段提交协议(2PC)通过准备(Prepare)与提交(Commit)两轮消息达成一致,但存在协调者单点阻塞缺陷。
- 基于 Paxos / Raft 共识复制的现代分布式事务协议,实现了非阻塞的高可用原子广播与自动故障恢复。
架构演进与核心洞察
2PC 与 Paxos 的黄金组合
许多人容易混淆 2PC 与 Paxos 的职责。2PC 解决的是“原子提交(Atomic Commit)”——各节点管理不同的数据分区,只要有一处违背完整性就必须全滚;Paxos 解决的是“共识(Consensus)”——所有节点保存同一份数据的副本,只要多数派活着就能前进。现代分布式数据库(如 Google Spanner、TiDB)的最佳实践是:底层多副本用 Paxos 保障单组高可用,上层跨分片事务用 2PC 保证全局原子性。
核心机制与讲义正文
阅读材料(optional)
- The End of an Architectural Era (It’s Time for a Complete Rewrite), VLDB'07
- Calvin: fast distributed transactions for partitioned database systems. sigmod'12
- Epoch-based Commit and Replication in Distributed OLTP Databases, VLDB'21
首先,我们对比一下OLTP 和 OLAP 在处理场景下区别:
On-line Transaction Processing (OLTP)
- 短期读写事务
- 占用空间小
- 重复操作多
On-line Analytical Processing (OLAP)
- 长时间运行的只读查询
- 复杂的Join
- 探索性查询
1. 去中心化协调器配置
分布式数据库系统的基本场景是,我们有一个应用服务器和多个数据分区。其中一个分区被选举为主节点(Primary Node)。
- 应用服务器将事务的开始请求发送到主节点。如果没有集中式协调器,查询将直接发送到各个节点。
- 应用服务器将提交请求发送到主节点,主节点负责在所有参与节点中确定是否允许提交。如果所有参与节点都同意可以安全提交,那么我们就可以提交事务。
两阶段锁、MVCC、OCC 和其他策略用于确定事务是否可以在每个节点上安全提交。
我们假设分布式数据库管理系统 (DBMS) 中的所有节点都行为良好,并且位于同一个管理域内。 以下章节将讨论
- 如何确保所有节点同意提交事务,以及
- 如果某个节点发生故障/消息延迟/系统未等待所有节点同意会发生什么
如果不信任分布式数据库管理系统中的其他节点,则需要使用拜占庭容错协议(例如区块链)来处理事务。
2. 复制
**复制技术(Replication)**DBMS 可以跨冗余节点复制数据,以提高可用性。
设计决策包括:
- 副本配置
- 传播方案
- 传播时间
- 更新方法
副本配置
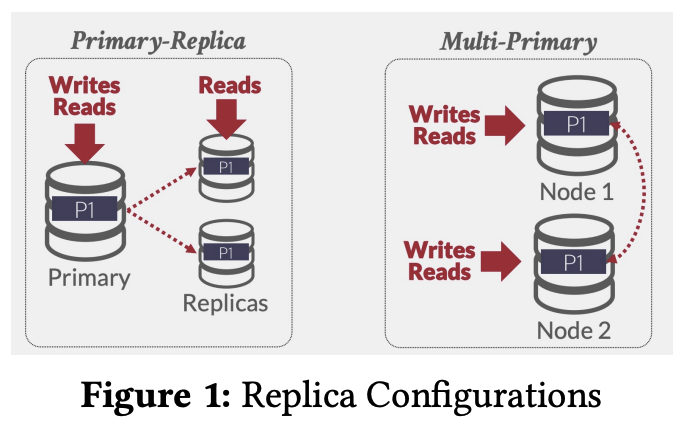
在主-副本模式(Primary-Replica)下,所有更新都会发送到主节点。更新事务到达主节点时,主节点先在本地执行并提交这个事务。它不会等副本节点的回复。事务提交后,主节点会把这个事务引起的数据变更(Mysql会将其记录在二进制日志,如Binlog) 放入一个发送队列,然后"尽力而为"地传播。若无需获取最新数据,只读事务可被允许访问副本节点。若主节点发生故障,系统将通过选举机制选出新的主节点。
在**多主模式(Multi-Primary)**中,事务可在任意副本节点上更新数据对象。副本节点之间必须通过原子提交协议实现相互同步。
**K-安全值(K-safety)**是衡量复制数据库容错能力的阈值指标,其数值K代表每个数据对象必须始终保持可用的副本数量。若可用副本数低于此阈值,数据库管理系统将停止执行并进入离线状态。更高的K值可降低数据丢失风险,该阈值决定了系统可用性的保障程度。
传播方案
当事务在复制数据库中提交时,DBMS 会决定是否必须等待该事务的更改传播到其他节点,然后才能向应用程序客户端发送确认。传播级别有两种:同步Synchronous(强一致性)和异步asynchronous(最终一致性)
在同步方案中,主服务器将更新发送到副本服务器,然后等待它们确认已完全应用(即记录)更改。然后,主服务器可以通知客户端更新已成功。这确保 DBMS 不会因强一致性而丢失任何数据。这在传统 DBMS 中更为常见。
在异步方案中,主服务器会立即向客户端返回确认,而无需等待副本服务器应用更改。在这种方法中可能会出现过时的读取,因为读取时更新可能尚未完全应用于副本服务器。如果可以容忍一些数据丢失,则此选项可以是一种可行的优化。这在 NoSQL 系统中很常见。
传播时序
对于**连续(continuous)**传播时序,DBMS 会在生成日志消息后立即发送。注意,提交和中止消息也需要发送。大多数系统都采用这种方法。
对于仅提交(on commit)传播时序,DBMS 仅在事务提交后才将事务的日志消息发送到副本。 这样就不会浪费时间发送已中止事务的日志记录。它假设事务的日志记录完全可以装入内存。
更新方法
将更新作用到副本的方法有很多种。对于active-active模式,事务在每个副本上独立执行。最终,DBMS 需要检查事务在每个副本上的结果是否相同,以确认副本是否已正确提交。这很困难,因为现在事务的顺序必须在所有节点之间同步,这使得这种情况不太常见。 对于active-passive模式,每个事务在单个位置执行,并将整体更改传播到副本。DBMS 可以发送更改的物理字节(这更常见),也可以发送逻辑 SQL 查询。大多数系统都是active-passive模式。
3. 原子提交协议
当多节点事务完成时,DBMS 需要询问所有相关节点是否可以安全提交。根据协议的不同,可能需要大多数节点或所有节点提交。示例包括:
- Two-Phase Commit (1970s)
- Three-Phase Commit (1983)
- Viewstamped Replication (1988)
- Paxos (1989)
- ZAB (2008? Zookeeper Atomic Broadcast protocol, Apache Zookeeper)
- Raft (2013)
所有这些原子提交协议都具有通用的结构。它们通常包含资源管理器 (RM) 的概念,用于管理不同节点上的资源数据库(或数据库的一部分)。这些 RM 需要相互协调,以决定每个事务的命运:提交或中止。使用 RM 的原子提交协议需要保证以下属性:
- 稳定性:事务的命运一旦确定,就无法更改。
- 一致性:即使发生故障,所有 RM 最终都处于相同的状态。
- 活跃性:协议始终有某种方式向前推进(例如,在协议执行期间,有足够多的节点处于活跃状态并保持连接)。
在以下章节中,我们将重点介绍两阶段提交 (2PC) 和 Paxos。如果协调器在发送准备消息后发生故障,两阶段提交 (2PC) 会阻塞,直到协调器恢复。另一方面,如果大多数参与者都处于活动状态,并且有足够长的时间段没有进一步的故障,则 Paxos 是非阻塞的。如果节点位于同一数据中心,故障频率不高,并且没有恶意行为,那么 2PC 通常比 Paxos 更受欢迎,因为 2PC 通常可以减少往返次数。
两阶段提交
客户端向协调者(coordinator)发送提交请求(Commit Request)。在该协议的第一阶段,协调者向参与者节点(participant nodes)发送准备消息(Prepare),实质上是询问参与者节点当前事务是否允许提交。如果某个参与者验证后确认给定事务是有效的,它会向协调者发送“同意”(OK)。如果协调者收到所有参与者的“同意”,系统即可进入协议的第二阶段。如果有任何参与者向协调者发送了“中止”(Abort),协调者则会向客户端发送“中止”。
如果所有参与者都发送了“同意”,协调者会向所有参与者发送“提交”(Commit),通知这些节点提交该事务。一旦参与者回复“同意”,协调者便可告知客户端事务已提交。如果事务在第一阶段被中止,参与者会收到来自协调者的“中止”命令,对此它们应回复“同意”。最终结果是,要么所有节点都提交,要么都不提交。协调者本身也可以是系统中的一个参与者。
此外,在发生故障的情况下,所有节点都会维护一份非易失性日志,记录每个阶段的结果。节点会阻塞(block),直到能确定下一步的行动方案。如果协调者崩溃,参与者必须决定如何操作。一个安全的选项是直接中止。或者,节点可以相互通信,以判断能否在没有协调者明确许可的情况下提交。如果参与者崩溃,且尚未发送确认消息,协调者会假定其回复了“中止”。
优化方案:
- 早期准备投票(Early Prepare Voting):如果DBMS向一个远程节点发送查询,并且确知这将是该节点执行的最后一个操作,那么该节点在返回查询结果时,可以一并返回其对准备阶段(prepare phase)的投票结果。
- 准备阶段后的早期确认(Early Acknowledgement after Prepare):如果所有节点都投票同意提交某个事务,协调者可以在提交阶段(commit phase)完成之前,就向客户端发送事务成功的确认消息。
Paxos
在现代系统中,Paxos(以及Raft)比 2PC 更为普遍。 2PC是Paxos的退化案例;Paxos 使用 2F + 1 个协调者,只要其中至少有 F + 1 个协调者正常工作,系统就能取得进展,而 2PC 设定了 F = 0
Paxos 是一种共识协议,其中一个协调者提出一个结果(例如,提交或中止),然后参与者对该结果是否应该成功进行投票。只要多数参与者可用,该协议就不会阻塞,并且在最佳情况下具有可证明的最小消息延迟。在 Paxos 中,协调者被称为提议者(Proposer),参与者被称为接受者(Acceptor)。
客户端会向提议者发送一个提交请求(Commit Request)。提议者会向系统中的其他节点(即接受者们)发送提议(Propose)。如果一个接受者尚未对更高的逻辑时间戳发送过同意(Agree),它就会回复一个同意(Agree)。否则,它会回复拒绝(Reject)。
一旦多数接受者发送了同意(Agree),提议者就会发送提交(Commit)。与 2PC 不同,提议者必须等待接收到来自多数接受者的接受(Accept)消息后,才能向客户端发送最终消息,告知事务已提交。
在提案失败后,应使用指数退避(exponential back off) 时间来尝试再次提案,以避免“提议者竞争(dueling proposers)”问题。
Multi-Paxos:如果系统选举出一个单一领导者(single leader),由它在一段时间内监督所有变更的提议,那么它就可以跳过提议阶段(propose phase)。系统会定期使用另一轮 Paxos 轮询来重新选举领导者。当发生故障时,DBMS 可以回退到完整的 Paxos 协议
4. CAP 理论
CAP 定理由 Eric Brewer 提出,并于 2002 年在麻省理工学院得到证明。该定理解释道,分布式系统不可能始终保持一致性、可用性和分区容忍性。这三个属性中只能选择两个。
**一致性(Consistency)**与所有节点操作的线性化同义。写入操作完成后,所有后续读取操作都应返回该写入操作或后续写入操作的值。此外,读取操作返回后,后续读取操作也应返回该值或后续写入操作的值。NoSQL 系统会为了后两者而牺牲此属性。
**可用性(Availability)**是指所有启动的节点都可以满足所有请求
分区容错性(Partition)意味着,即使节点之间在试图就值达成共识时出现一些消息丢失,系统仍能正常运行。如果系统同时选择了一致性和分区容错性,则只有在大多数节点重新连接后才允许更新,这通常在传统或 NewSQL DBMS 中完成。
有一个现代版本考虑了一致性与延迟之间的权衡:PACELC 定理。在分布式系统中,当出现网络分区(P)时,必须在可用性(A)和一致性(C)之间做出选择;否则(E, else),即当系统正常运行没有网络分区时,则必须在延迟(L)和一致性(C)之间做出选择。增加了正常情况下的权衡,要追求低延迟,就必须放松对一致性(C)的要求。