Lec 8连接算法与物理算子
Lec 8 连接算法与物理算子(Join Algorithms)
MIT 6.5830 / 6.5831 · Database Systems · 第 8 讲
核心教材:Readings in Database Systems (5th Edition, Red Book)
配套实验:GoDB (Go-based Database Engine)
TL;DR
- 连接操作(Join)是关系型系统中最耗时且最具算法挑战性的二元物理算子。
- 嵌套循环连接(Nested Loop)包含简单嵌套、基于块的优化(BNL)与利用内表索引的 INLJ。
- 散列连接(Grace Hash Join)通过分区与哈希探测处理超大表等值关联,排序合并连接(Sort-Merge)适用于预排序数据。
架构演进与核心洞察
连接算法选型的内存边界法则
在进行两表连接时,如果一侧表在过滤后尺寸极小能够完全装入内存缓冲池,单阶段 Hash Join 是最优选择,只需 I/O。但若两侧表均大幅超过可用内存,必须退化为分阶段外存 Hash Join(Grace Hash Join)或外部归并排序连接。优化器的最关键任务就是准确估计输入流的行数,避免将大表误判为驱动表导致内存溢出。
核心机制与讲义正文
本讲导览
-
嵌套循环连接(Nested Loops, NL)
-
块嵌套循环连接(Bolcked Nested Loops)
-
索引嵌套循环连接(Index nested loops(INL)
-
当表能够装入内存时
-
hash 连接(只需一个表装入内存)
- 使用哈希表来连接两个表,只需要其中一个表能装入内存即可,通常在没有合适的索引时使用
-
排序合并连接(Sort Merge Join, 两个表都需要装入内存)
-
-
当表不能装入内存时
- 块哈希连接
- 外部排序合并连接
- 简单哈希
- Grace 哈希
评估连接
假设 R 总是比较小的表
- {S}-S 表中的记录
- |S| - S 表的页树
- 内存大小为 M 页
嵌套循环连接
for s in S:
  for r in R:
    if pred(s, r):
output s join r当只有一个表能放入内存时,选择哪个表作为内表(Inner)和外表(Outer)会影响连接的效率
无论选择哪个表作为内表或外表,在最坏的情况下,仍需要进行 {S}(外表的记录数)乘以 {R}(内表的记录数)次比较
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
块嵌套循环连接
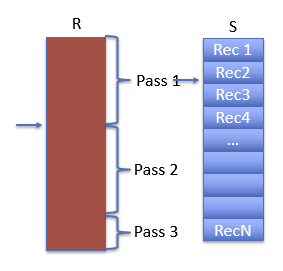
B = block size(< M)
while (not at end of R)
	R' = read B reocrds from R
	for s in S:
		for r in R':
			if pred(s, r):
output s join r- 选择内联或外联对性能有影响; {S} * {R}次比较
- 但是遍历 S 的次数是**{R}/B**
{R}/B 次数遍历 S
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
| BNI | {R} * {S} | $\lceil { | R} |
索引循环嵌套
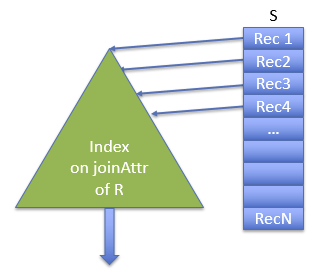
假设在关系 R 中的连接属性上有一个索引I
for s in S:
  for r in lookup s.joinAttr in I:
output s join r- 内表和外表的选择很重要
- 有 {S} 次查找
- 内表总是被索引的属性
- 注意,除非 S 按连接属性排序并且索引是按连接属性聚簇的,否则索引查找是随机的
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
| BNI | {R} * {S} | $\lceil { | R} |
| INL | {R} * D, D是树的深度, <~ 5 | ,如果外表S没有按照连接属性排序,且索引不是聚簇索引,查询过程会进行随机I/O,否则将是顺序I/O | 假设S上有索引 |
哈希连接(内存)
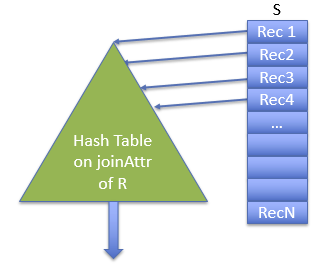
- 基本上与索引嵌套循环连接相同,但在运行时动态构建内存中的哈希“索引”
- 在连接操作中,首先会根据 R 表的连接属性(即用于连接的字段)构建一个哈希表 T
T = build hash table on joinAttr of R
for s in S:
	for r in lookup s.joinAttr in T:
output s join r- 内表与外表的选择很重要
- 需要进行 {S} 次查找
- 并且需要内存来存储 R 的哈希表
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
| BNI | {R} * {S} | $\lceil { | R} |
| INL | {R} * D, D是树的深度, <~ 5 | ,如果外表S没有按照连接属性排序,且索引不是聚簇索引,查询过程会进行随机I/O,否则将是顺序I/O | 假设S上有索引 |
| Hash Join | {R} + {S} | |R| + |S| | 两个表都需要能装入内存 |
分块哈希连接
- 类似与块循环嵌套
- 迭代的执行以下操作
- 构建一个在内存中可以容纳的 R 的部分哈希表
- 使用 S 中的所有记录进行探测(在哈希表中查找)
- 使用 R 的一下个部分重复上述过程
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
| BNI | {R} * {S} | $\lceil { | R} |
| INL | {R} * D, D是树的深度, <~ 5 | ,如果外表S没有按照连接属性排序,且索引不是聚簇索引,查询过程会进行随机I/O,否则将是顺序I/O | 假设S上有索引 |
| Hash Join | {R} + {S} | |R| + |S| | 两个表都需要能装入内存 |
| Blocked hash join | {R} + $\lceil { | R} | /M \rceil \times |
排序归并连接
特别适用于排序后的数据或可以按顺序遍历的数据。 将 S 和 R 进行排序(如果有合适的索引,可以直接利用索引进行排序后的遍历)
while (i < {R} and j < {S}):
  if (R[i].joinAttr == S[j].joinAttr):
    ouput R[i] join S[j]
  if (R[i].joinAttr < S[j].joinAttr):
    i = i + 1
  else:
    j = j + 1
[!NOTE]
输出是有序的
处理重复值
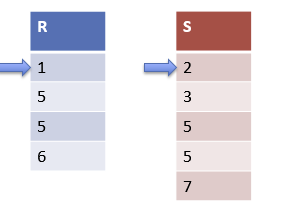
- 思路: 当连接键值相同时,就进入处理重复值逻辑。 计算 S 和 R 的运行长度(比如 m, n),生成
m x n的连接结果
while (i < {R} and j < {S}):
  if (R[i].joinAttr == S[j].joinAttr):
    rLen = getRunLen(R, i)
    sLen = getRunLen(S, j)
    emitRun(R, S, i, j, rLen, sLen)
    i = i + rLen
    j = j + sLen
  if (R[i].joinAttr < S[j].joinAttr):
    i = i + 1
  else:
    j = j + 1

def getRunLen(v, i):
	runLen = 1
	while (i < len(v)-1):
		i = i + 1
		if v[i] == v[i-1]:
			runLen = runLen + 1
		else:
			break
	return runLen

def emitRun(R, S, r, s, rLen, sLen):
	for i in range(r, r+rLen):
		for j i range(s, s+sLen):
			output R[i] join S[j]
| CPU复杂度 | I/O 复杂度 | 说明 | |
|---|---|---|---|
| NI | {R} * {S} | |S| + {S}|R| (R不能装入内存) |S| + |R|(R能够装入内存) | 当R能装入内存,而S不能时,内联和外联的选择会影响到效率 |
| BNI | {R} * {S} | $\lceil { | R} |
| INL | {R} * D, D是树的深度, <~ 5 | ,如果外表S没有按照连接属性排序,且索引不是聚簇索引,查询过程会进行随机I/O,否则将是顺序I/O | 假设S上有索引 |
| Hash Join | {R} + {S} | |R| + |S| | 两个表都需要能装入内存 |
| Blocked hash join | {R} + $\lceil { | R} | /M \rceil \times |
| Sort Merge join | Rlog{R} + {S}log{S} + {S} +{R} | |R| + |S| | 假设两个表都能放进内存,如果已经有序 |
什么情况下你会请倾向于 sort-merge 而不是 hash join?
什么情况下你会请倾向于索引嵌套循环而不是 hash join?
外部排序归并连接
等值连接两个表 S 和 R(假设连接键是相等的,即 Equi-Join)
- |S|: 表示表 S 中的页数
- {S}: 表示表 S 中的元组数
- M: 表示可用的内存页数;并且假设 M > sqrt(|S|),即内存大小大于表 S 页数的平方根
算法:
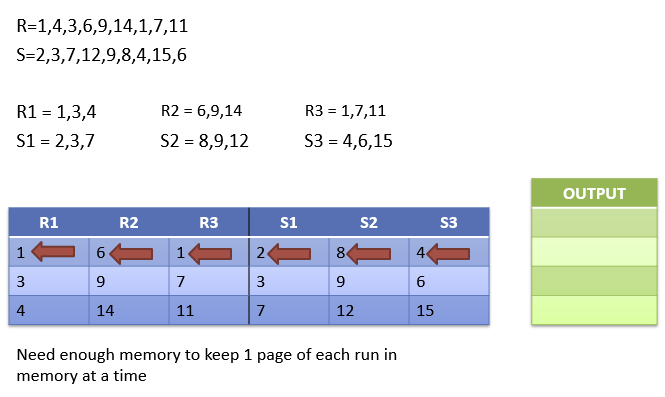
- 对 S 和 R 进行分区
- 将表 S 和表 R 分成大小为内存容量的有序分区(
sorted runs),然后将这些分区写回磁盘
- 将表 S 和表 R 分成大小为内存容量的有序分区(
- 合并所有分区:
- 同时对所有分区进行合并。这一步确保最终连接的结果是有序的,能够高效地进行等值连接。
分析:
- I/O 消耗: 需要读取|R| 和 |S|两边, 写一遍
- I/O
例子: