
Lec 9查询执行引擎与向量化处理
Lec 9 查询执行引擎与向量化处理(Query Execution and Vectorization)
MIT 6.5830 / 6.5831 · Database Systems · 第 9 讲
核心教材:Readings in Database Systems (5th Edition, Red Book)
配套实验:GoDB (Go-based Database Engine)
TL;DR
- 经典火山模型(Volcano Iterator)基于 Pull 模式与
next()接口解耦算子,但虚函数调用与解释开销巨大。 - 向量化执行(Block/Batch Processing)单次传递数据块(如 1024 行),极大发挥 CPU L1/L2 缓存与 SIMD 指令集优势。
- 代码生成引擎(JIT / LLVM)通过动态编译将整个查询树内联压平为紧凑循环,消除所有中间解释层。
架构演进与核心洞察
内存墙时代下算子执行模型的进化
在磁盘时代,I/O 是绝对瓶颈,火山模型每行一次虚拟调用的 CPU 开销无足轻重。但在全内存与高速 NVMe 时代,“内存墙(Memory Wall)”凸显,CPU 指令周期与分支预测失败率成为新瓶颈。向量化(Vectorwise 模式)和动态代码生成(Hyper 编译模式)是现代数据库执行引擎的两大主流巅峰,前者优化了指令级并行与跨平台灵活性,后者压榨了寄存器与内存局部性的极致性能。
核心机制与讲义正文
处理模型
DBMS 处理模型(process model)定义了系统如何执行查询计划的。它指定了查询计划的执行方向以及在执行过程中操作符之间传递的数据类型等信息。不同的处理模型针对不同的工作负载进行权衡。
这些模型也可以实现为从上到下或从下到上调用操作符。虽然从上到下的方法更为常见,但从下到上的方法可以更严格地控制流水线中的缓存/寄存器。
我们考虑的三种执行模型是:
- 迭代模型
- 物化模型
- 矢量化/批处理模型
迭代模型
迭代器模型,也称为 Volcano 模型或 Pipeline 模型,是最常见的处理模型,几乎所有(基于行的)DBMS 都使用它。
迭代器模型的工作原理是为数据库中的每个操作符实现一个 Next 函数。查询计划中的每个节点都会在其子节点上调用 Next,直到到达叶节点,叶节点开始向上游节点发送元组进行处理。每个元组在计划中尽可能向上游处理,然后再获取下一个元组。这对于基于磁盘的系统非常有用,因为它允许我们在内存中充分利用每个元组.
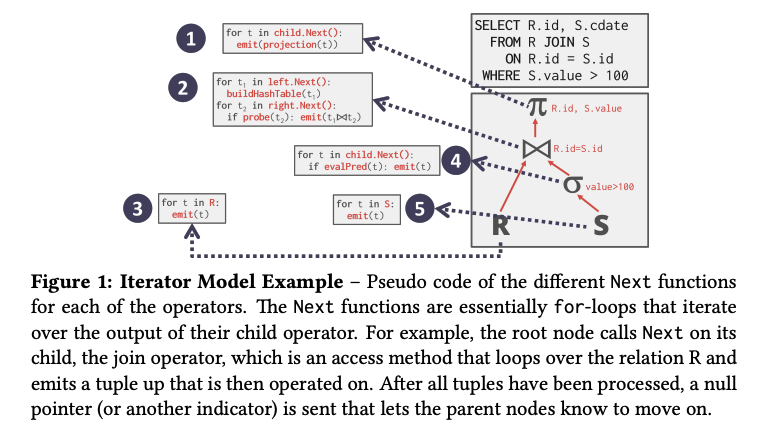
- 图一迭代器模型示例 - 每个操作符的不同 Next 函数的伪代码。Next 函数本质上是遍历其子操作符输出的 for 循环。例如,根节点在其子节点(连接操作符)上调用 Next,连接操作符是一种访问方法,它循环遍历关系 R 并发送一个元组向上,然后对其进行操作。处理完所有元组后,发送空指针(或其他指示器),让父节点知道继续前进。
迭代器模型中的查询计划操作符具有高度可组合性且易于推理,因为只要实现了如下Next函数,每个操作符都可以独立于查询计划树中的父或子操作符实现:
- 每次调用 Next 时,操作符返回单个元组,如果没有更多元组要发送,则返回空标记。
- 操作符实现一个循环,在其子节点上调用 Next 以检索它们的元组然后处理它们。这样,在父节点上调用 Next 就会在其子节点上调用 Next。作为响应,子节点将返回父节点必须处理的下一个元组。
迭代器模型允许流水线操作,DBMS 可以在必须检索下一个元组之前,通过尽可能多的操作符处理一个元组。查询计划中为给定元组执行的一系列任务称为流水线。
这种方法很容易实现输出的控制,因为操作符一旦获得所需的所有元组,就可以停止在其子操作符上调用 Next。
物化模型
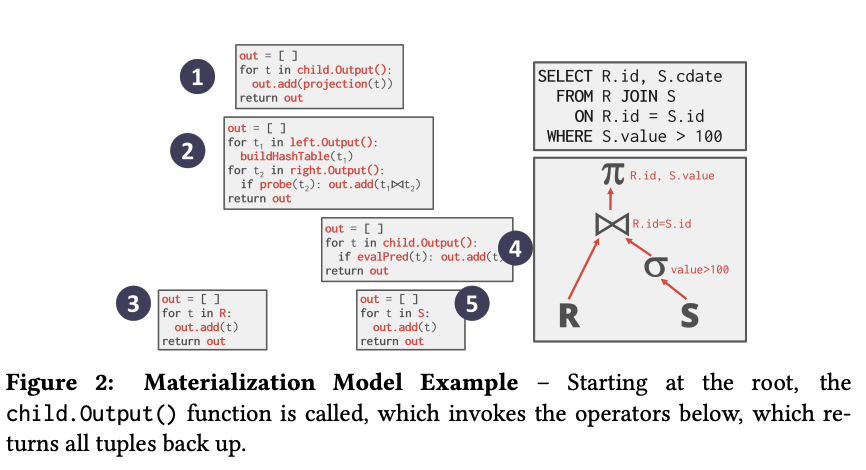
物化模型(Materialization Model) 是对迭代器模型的一种特化形式。在这种模型中,每个操作符会一次性处理完所有输入数据,然后一次性输出所有结果数据。与迭代器模型中使用 Next() 函数每次返回一个元组不同,在物化模型中,每次访问操作符时,它会直接返回它的全部元组。为了避免扫描过多元组,DBMS 可以将所需元组数量的信息(例如 LIMIT 限制)向下传递给后续操作符,每个操作符会将其输出“物化”为一个整体结果(即缓存起来的所有元组)。输出可以是完整的元组(即 NSM:Row/tuple-based 存储格式),也可以是列的一部分(即 DSM:Column/column-group-based 存储格式)
每个操作符实现一个 Output() 函数:
- 操作符会一次性处理它所有子节点输出的元组。
- 这个函数的返回值就是操作符会输出的全部元组;执行完一次后,DBMS 就不再访问这个操作符。
这种方法更适合 OLTP 类型的负载,因为这类查询通常一次只访问很少的元组。因此,函数调用次数更少(不像迭代器模型需要不断地调用 Next() 获取元组)。
向量化模型
像迭代器模型一样,向量化模型中的每个操作符也实现了一个 Next() 函数。但与之不同的是,向量化模型的每个操作符会一次返回一批(即一个向量)数据,而不是单个元组。操作符内部的循环实现被优化为按批处理数据,而不是一次处理一个元组。批次的大小可以根据硬件特性或查询属性而变化。
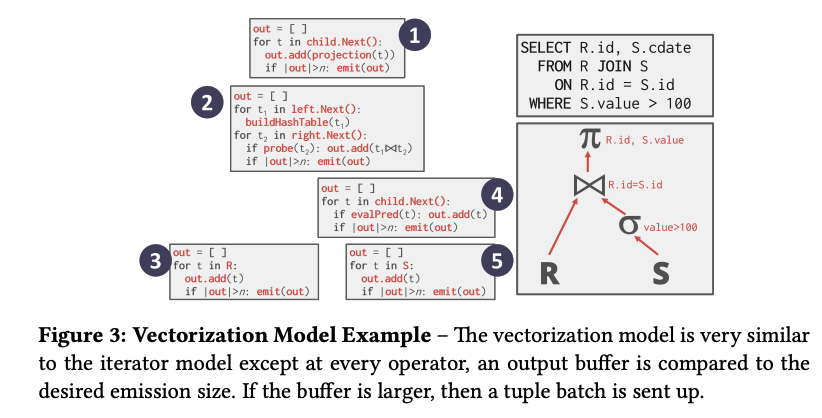
向量化模型特别适合需要扫描大量元组的 OLAP 查询,因为它减少了对 Next() 函数的调用次数。向量化模型还使操作符更容易利用向量化(SIMD)指令来批量处理元组,提高处理效率。
两种处理方向
- 方法 1:自顶向下。从根节点开始,自上而下地“拉取”数据(即父节点通过调用
Next()来请求子节点返回数据),元组的传递总是通过函数调用来进行。 - 方法 2:自底向上。 从叶子节点开始,自下而上地“推送”数据给父节点,这种方式能更紧密地控制管道中操作符对缓存 / 寄存器的使用(更容易优化硬件利用)
访问方法
访问方法指的是 DBMS 如何访问表中存储的数据。一般来说,访问模型有两种方式:要么从表中顺序读取数据,要么通过索引读取。
顺序扫描
顺序扫描操作符会遍历表中的每个页面,并从缓冲池中检索它们。当扫描遍历每个页面上的所有元组时,它会评估谓词以决定是否将元组传递给下一个操作符。
DBMS 维护一个内部游标,用于跟踪上次检查的页面/槽位。
顺序表扫描几乎总是 DBMS 执行查询效率最低的方法。有许多优化技术可以使顺序扫描更快:
-
预取:预先获取接下来的几个页面,使得 DBMS 在访问每个页面时不必因存储 I/O 而阻塞。
-
缓冲池旁路:扫描操作符将从磁盘获取的页面存储在其本地内存中,而不是缓冲池中,以避免顺序洪泛。
-
并行化:使用多个线程/进程并行执行扫描。
-
延迟物化:DSM DBMS 可以延迟将元组拼接在一起,直到查询计划的上层部分。这使得每个操作符可以仅向下一个操作符传递最少量的必需信息(如记录 ID、列中记录的偏移量)。这仅在列存储系统中有用。
-
堆聚簇:使用聚簇索引指定的顺序将元组存储在堆页面中。
-
近似查询(有损数据跳过):在整个表的采样子集上执行查询以产生近似结果。这通常用于在允许小误差的情况下计算聚合,以产生接近准确的答案。
-
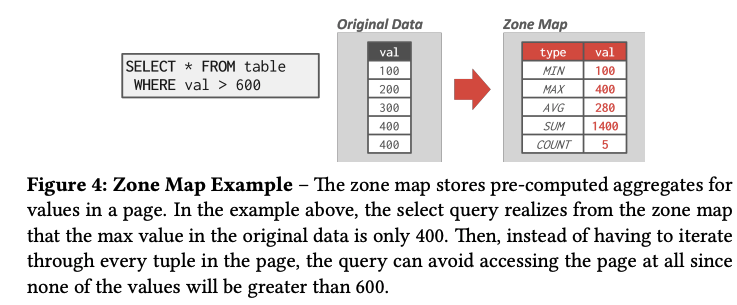
区域映射(无损数据跳过):预计算页面中每个元组属性的聚合。然后,DBMS 可以通过首先检查其区域映射来决定是否需要访问页面。每个页面的区域映射存储在单独的页面中,通常每个区域映射页面中有多个条目。因此,可以减少顺序扫描中检查的页面总数。区域映射在云数据库系统中特别有价值,因为通过网络传输数据会产生更大的成本。区域映射的示例见图 4。
-
近似查询(有损数据跳过):在整个表的采样子集上执行查询以产生近似结果。这通常用于在允许小误差的情况下计算聚合,以产生接近准确的答案。
-
区域映射(无损数据跳过):预计算页面中每个元组属性的聚合。然后,DBMS 可以通过首先检查其区域映射来决定是否需要访问页面。每个页面的区域映射存储在单独的页面中,通常每个区域映射页面中有多个条目。因此,可以减少顺序扫描中检查的页面总数。区域映射在云数据库系统中特别有价值,因为通过网络传输数据会产生更大的成本。区域映射的示例见图 4。
索引扫描
在索引扫描中,DBMS 会选择某个索引来定位查询所需的元组。DBMS 的索引选择过程涉及多个因素,包括:
- 索引包含哪些属性
- 查询引用了哪些属性
- 属性的值域范围
- 谓词组合方式
- 索引键是唯一(unique)还是非唯一(non-unique)
更先进的 DBMS 支持多索引扫描(multi-index scan)。当查询使用多个索引时,DBMS 会执行以下操作:
- 使用每个匹配的索引计算符合条件的记录 ID 集合
- 根据查询谓词(如 AND、OR)合并这些集合
- 检索记录并应用剩余的谓词条件
DBMS 可以使用位图(bitmaps)、哈希表(hash tables)或布隆过滤器(Bloom filters)来通过集合交集(set intersection)计算记录 ID。图 6 展示了一个利用多索引扫描的示例。
修改查询
修改数据库操作符 INSERT、UPDATE、DELETE 负责检查约束和更新索引。
- 对于 UPDATE / DELETE,子操作符会传递目标元组的记录 ID,并且必须跟踪之前访问过的元组。
- INSERT 操作符有两种实现方案:
- 方案 1, 在操作符内部实现元组。
- 方案 2,操作符插入从子操作符传入的任何元组
万圣节问题
万圣节问题是一种异常现象,即更新操作会改变元组的物理位置,导致扫描运算符多次访问该元组。这种情况可能发生在聚簇表或索引扫描中。 这种现象最初是由 IBM 研究人员在 1976 年万圣节构建 System R 时发现的。
解决这个问题的方法是跟踪每个查询修改后的记录 ID。
表达式求值
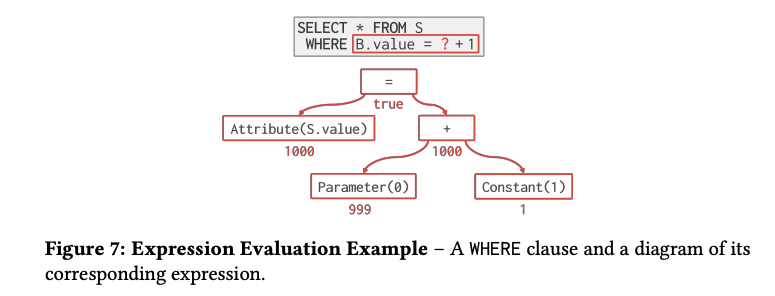
DBMS 将 WHERE 子句表示为表达式树(expression tree),参见图 7 的示例。树中的节点代表不同的表达式类型。
以下是一些可以存储在树节点中的表达式类型示例:
- 比较 (=, <, >, !=)
- 连接 (AND), 析取 (OR)
- 算术运算符 (+, -, *, /, %)
- 常量和参数值
- 元组属性引用
为了在运行时求值表达式树,DBMS 会维护一个上下文句柄,其中包含执行所需的元数据,例如当前元组、参数和表 scheme。然后,DBMS 遍历树来对其运算符求值并生成结果。
以这种方式求值谓词的速度很慢,因为 DBMS 必须遍历整个树并确定每个运算符应采取的正确操作。更好的方法是直接求值表达式(例如 JIT 编译)。根据内部成本模型,DBMS 将决定是否采用代码生成来加速查询。
调度器
上述查询处理模型清晰地描述了数据流,而控制流则较为隐式。调度器将数据流和控制流清晰地分离。它在批处理模式下运行良好,尤其是在矢量化模型下。调度器创建调度组件(工作指令),它不是从上到下调用操作符树,而是遍历树并将调度工作放入调度队列。然后,工作线程从队列中获取请求并执行。
图 8:调度器与传统查询处理模型的比较
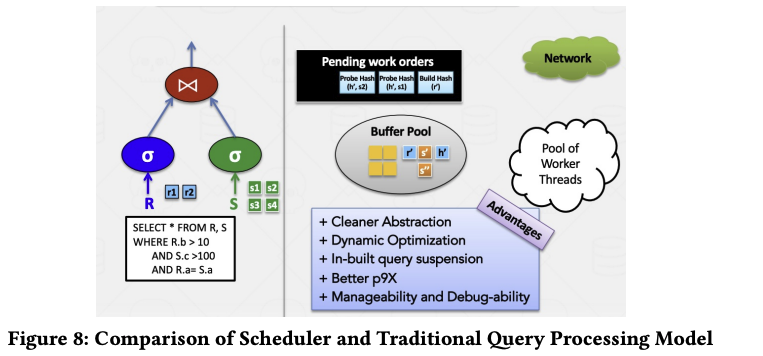
总体而言,它具有更清晰的抽象、动态优化、内置查询暂停、更佳的 p9x 性能以及更佳的可管理性和可调试性。