
B-Tree 存储引擎与外存访问模型
B-Tree 存储引擎与外存访问模型(B-Tree Storage Engines)
MIT 6.5830 · 核心存储结构专题 · 概念解析
核心参考:Alex Petrov Database Internals 第 2 章
TL;DR
- 二叉搜索树由于分支因子仅为 2,外存树高过大且缺乏空间局部性,不适合作为磁盘驻留数据结构。
- 旋转机械硬盘(HDD)的高寻道成本决定了按块连续顺序 I/O 的绝对优势。
- 固态硬盘(SSD)以页为单位读写、以块为单位擦除,闪存转换层(FTL)负责垃圾回收与地址重映射。
- B-Tree 通过匹配磁盘块大小的高分支因子(100
200)将树高压缩至 34 层,实现对数级极少磁盘访问。
架构演进与核心洞察
为什么现代外存依然由 B-Tree 统领
尽管 LSM-Tree 在高频写入场景声势浩大,但在绝大多数读多写少、严苛点查与范围查询的通用关系数据库中,B+ Tree 依然是王者。B+ Tree 的叶子节点双向链表和对页缓存的天然亲和性,使得它无论在机械磁盘时代还是在超高速 NVMe SSD 时代,都能以极小的内部碎片提供稳定、可预测且极低的 P99 读延迟。
核心机制与技术实现
我们将存储结构分为两类:可变的和不可变的,大多数可变存储结构使用原地更新机制。存储引擎通常允许数据库中存在相同数据记录的多个版本,例如(MVCC,或者是插槽页),为了简单起见,目前我们假设每个键只关联一个数据记录,并且该记录具有唯一的位置。其中一种流行的存储结构是B树。在我们深入了解B树之前,首先要讨论一下为什么我们应该考虑传统搜索树的替代方案,例如二叉搜索树、2-3树和AVL树 。
二叉搜索树
BST是在内存中有序的数据结构,用于高效的key-value查询。
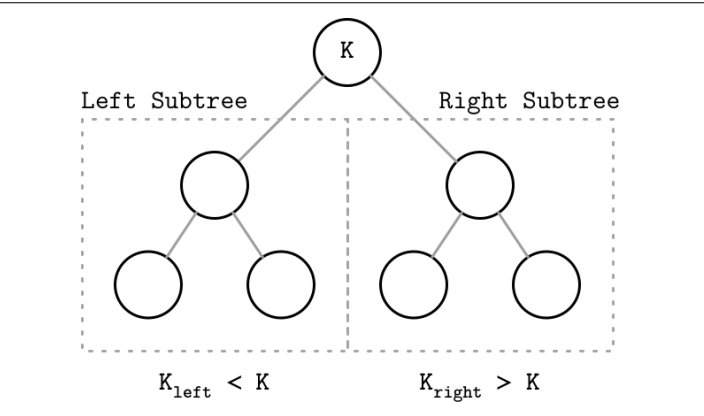
树平衡
元素的插入可能导致树的不平衡, 最坏的情况,得到一个病态树,看起来跟链表一样。平衡树被定义为具有对数高度,并且两个子树之间的高度差不超过1。如果没有平衡,将失去BST的优势。允许插入和删除的顺序决定树的形状。保持树平衡的一种方法是添加和删除节点后执行旋转步骤。如果插入操作使某个分支不平衡,可以围绕中间节点进行旋转。
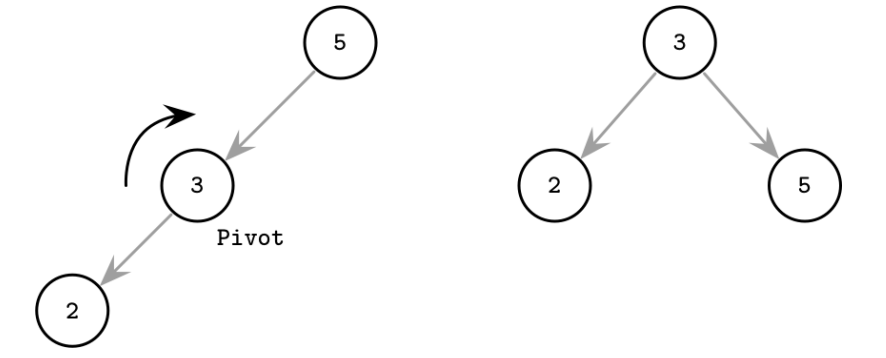
用于磁盘存储的树
由于低分支因子(分支因子是每个节点允许的最大子节点数),我们必须频繁地进行平衡,重新定位节点和更新指针。如果我们想在磁盘上维护一个 BST,将面临几个问题。
- 一个问题是局部性:由于元素是以随机顺序添加的,无法保证新创建的节点会靠近其父节点写入,这意味着节点的子指针可能跨越多个磁盘页面。通过修改树的布局并使用分页二叉树(参见“分页二叉树”第33页),我们可以在一定程度上改善这种情况
- 另一个问题是树的高度,这与追踪子指针的成本密切相关。由于二叉树的分支因子只有两个,高度是lg N,我们必须执行 O(lg N) 次寻道来定位被搜索的元素,并随后执行相同数量的磁盘传输。
2-3-树和其他低分支因子的树也有类似的限制:尽管它们在内存数据结构中很有用,但较小的节点大小使得它们在外部存储中不切实际
适合磁盘实现的树版本必须具有以下特性:
- 高分支因子以改善相邻键的局部性。
- 低高度以减少遍历过程中需要的寻道次数。
基于磁盘的数据结构
当数据量大到无法在内存中保持整个数据集时,通常会使用基于磁盘的数据结构。任何时候只能将数据的一部分缓存到内存中,其余的数据则需要以一种允许高效访问的方式存储在磁盘上。
磁盘驱动器
大多数传统算法是在旋转磁盘是最广泛使用的持久存储介质时开发的,这显著地影响了它们的设计。在旋转磁盘上,寻道增加了随机读取的成本,因为它们需要磁盘旋转和机械磁头移动来将读写头定位到所需位置。然而,一旦昂贵的部分完成,从磁盘中读取或写入连续字节(即顺序操作)相对便宜。磁盘驱动器的最小传输单元是扇区,因此在执行某些操作时,至少可以读取或写入整个扇区。扇区大小通常范围从 512 B到 4 KB。磁头定位是硬盘驱动器操作中最昂贵的部分。这也是我们经常听到顺序 I/O(sequential I/O) 原因之一:从磁盘中读取和写入连续的存储段。
固态硬盘
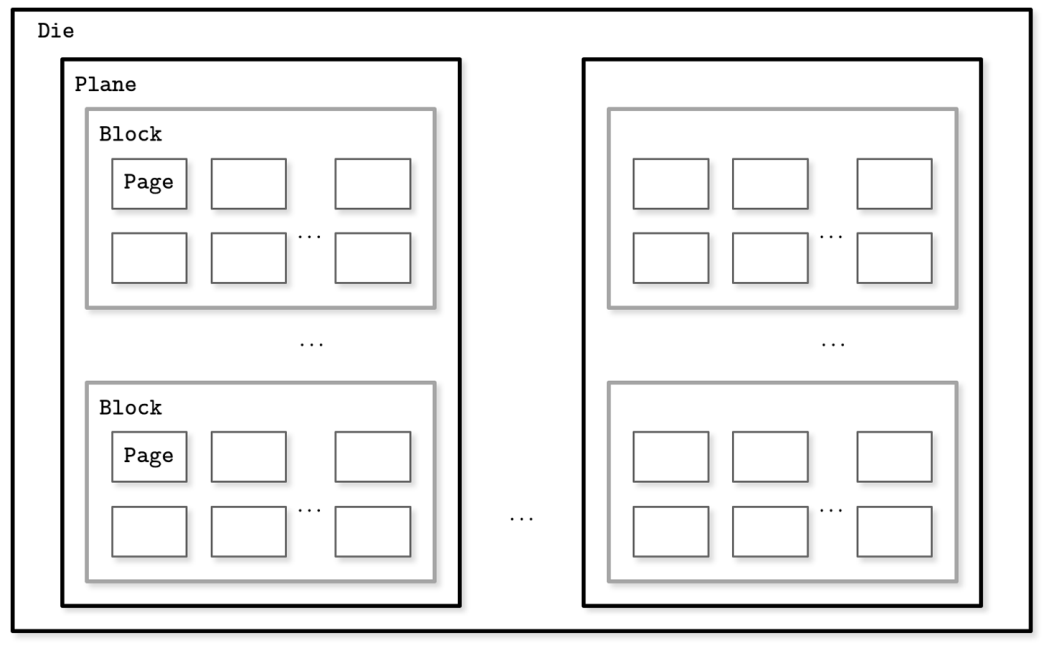
固态驱动器(SSD)没有移动部件:没有旋转的磁盘,也没有需要定位的读写头。典型的 SSD 是由内存单元(memory cells)组成的,这些单元连接成串(string)(通常每串 32 到 64 个单元),串组合成阵列(arrays),阵列组合成页(page),页组合成块(block) [LARRIVEE15]。
一个单元可以存储一个或多个比特的数据, 页在设备之间的大小有所不同,但通常范围在 2 到 16 KB 之间。块通常包含 64 到 512 页。块组织成平面(plane),最终平面被放置在一个芯片(die)上。SSD 可以有一个或多个芯片。可以写入(编程)或读取的最小单位是页面。然而,我们只能对空的内存单元(即在写入之前已经被擦除的单元)进行更改。最小的擦除单位不是页面,而是一个包含多个页面的块,因此它通常被称为擦除块(erase block)。空块中的页面必须按顺序写入.
负责将页面 ID 映射到其物理位置、跟踪空的、已写入的和已丢弃的页面的部分称为闪存转换层(FTL)。它还负责垃圾回收,在此过程中,FTL 找到可以安全擦除的块。一些块可能仍包含活动页面。在这种情况下,它会将这些块中的活动页面移动到新位置,并重新映射页面 ID 以指向这些位置。之后,它擦除现在未使用的块,使其可用于写入。
由于在 HDD 和 SSD 两种设备中,我们都是以块为单位而不是单个字节来寻址(即,按块读取数据),大多数操作系统具有块设备抽象 [CESATI05]。它隐藏了内部磁盘结构并在内部缓冲 I/O 操作,因此当我们从块设备中读取单个字时,整个包含它的块会被读取。这是我们无法忽视的约束,在处理磁盘驻留的数据结构时应始终考虑到这一点。
在 SSD 中,我们不如在 HDD 中那样强调随机与顺序 I/O,因为随机读取与顺序读取之间的延迟差异没有那么大。尽管垃圾回收通常是后台操作,但其效果可能会对写入性能产生负面影响,特别是在随机和未对齐写入负载的情况下。仅写入完整块,并将后续写入合并到同一块中,可以帮助减少所需的 I/O 操作数量
磁盘上的结构
除了磁盘访问本身的成本外,构建高效的磁盘结构的主要限制和设计条件是磁盘操作的最小单位是块。为了跟踪块内的特定位置,我们必须获取整个块。既然我们已经必须这么做,我们可以更改数据结构的布局以利用这一点。
我们已经多次提到指针,但这个词在磁盘上的结构中有稍微不同的语义。在磁盘上,大多数时候我们手动管理数据布局(除非我们使用memory mapped files)。这与常规的指针操作相似,但我们必须计算目标指针地址并明确地跟踪这些指针。
大多数时候,磁盘上的偏移量是预计算的(在指针在磁盘上写入之前的情况下)或缓存到内存中,直到它们被刷新到磁盘上。在磁盘结构中创建长依赖链会大大增加代码和结构的复杂性,因此通常希望将指针及其跨度的数量保持在最低限度。
总之,磁盘结构的设计考虑了其目标存储的具体情况,通常优化以减少磁盘访问次数。我们可以通过提高局部性、优化结构的内部表示以及减少跨页指针的数量来实现这一点。
分页二叉树
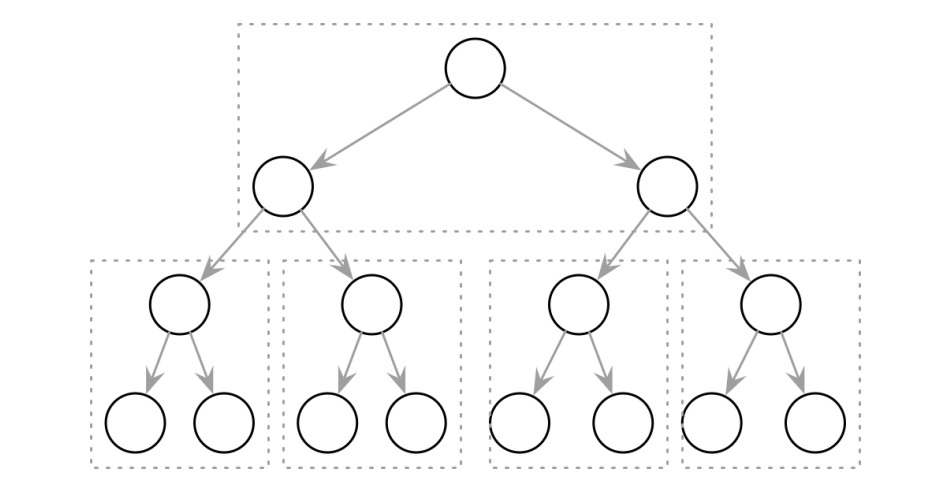
将二叉树布局为按页分组的节点,可以改善局部性问题。要找到下一个节点,只需跟随已经获取的页面中的指针即可。然而,节点和它们之间的指针仍然会带来一定的开销。在磁盘上布局结构以及后续的维护工作并非易事,尤其是当键和值未排序且以随机顺序添加时。平衡操作需要重新组织页面,这反过来又会导致指针更新
无处不在的B树
B 树可以被看作是图书馆中的一个庞大目录室:你首先要挑选正确的柜子,然后是柜子中的正确架子,再然后是架子上的正确抽屉,最后在抽屉中的卡片上查找你要找的那张。类似地,B 树构建了一个层次结构,帮助快速导航并定位所搜索的项。
B 树是有序的: B 树节点内部的键是按顺序存储的。因此,为了定位搜索的键,我们可以使用类似二分搜索的算法。这也意味着在 B 树中的查找具有对数复杂度。例如,在 40 亿(4 × 10^9)个项中找到一个搜索的键大约需要 32 次比较,如果我们每进行一次比较都需要一次磁盘寻道,那会显著降低速度,但由于 B 树节点存储了几十甚至几百个项,我们每层只需要一次磁盘寻道。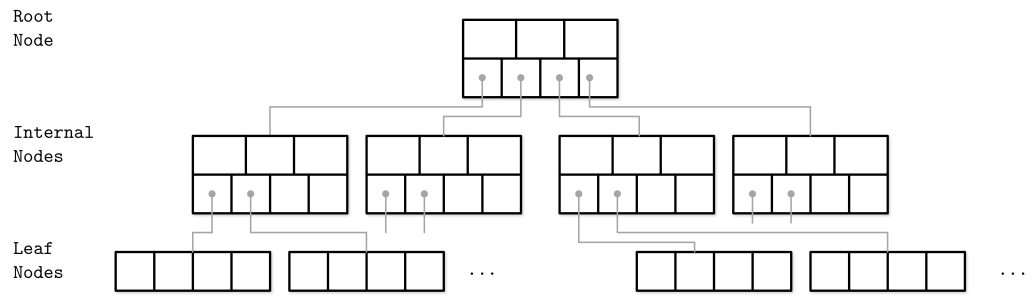
使用 B 树,我们可以高效地执行点查询和范围查询。点查询在大多数查询语言中由等于(=)谓词表示,用于定位单个项。另一方面,范围查询由比较(<,>,≤ 和 ≥)谓词表示,用于按顺序查询多个数据项。
由于 B 树是一种页面组织技术(即,用于组织和导航固定大小的页面),我们通常互换使用节点和页面这两个术语。 节点容量与其实际持有的键的数量之间的关系称为占用率。 B 树的特征在于其分支因子:每个节点中存储的键的数量。较高的分支因子有助于摊销保持树平衡所需的结构变化的成本,并通过将键和指向子节点的指针存储在一个块或多个连续块中来减少寻道次数。当节点已满或几乎为空时,会触发平衡操作(即分裂和合并)。
[!IMPORTANT]
B+ 树
我们使用术语 B 树作为共享所有或大多数上述属性的数据结构家族的总称。更精确地描述这种数据结构的名称是 B+ 树。[KNUTH98] 将高扇出的树称为多路树。
B 树允许在任何级别存储值:在根节点、内部节点和叶子节点中。而 B+ 树仅在叶子节点存储值。内部节点仅存储用于指导搜索算法找到存储在叶子级别的关联值的分隔键。
由于 B+ 树中的值仅存储在叶子级别,所有操作(插入、更新、删除和检索数据记录)仅影响叶子节点,并且仅在分裂和合并期间传播到更高层级。
B+ 树变得广泛应用,并且我们将它们称为 B 树,类似于其他关于该主题的文献。例如,在 [GRAEFE11] 中,B+ 树被作为默认设计提及,而 MySQL InnoDB 将其 B+ 树实现称为 B 树。
分离的键
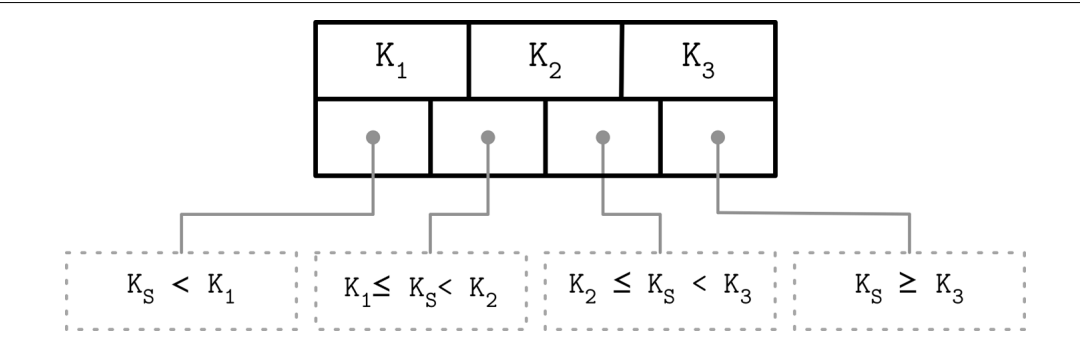
B 树节点中存储的键称为索引项、分隔键或分隔单元。它们将树分割成子树(也称为分支或子范围),每个子树包含相应的键范围。键按排序顺序存储,以允许二分搜索。通过定位一个键并从较高级别跟随相应的指针到较低级别,可以找到子树。
节点中的第一个指针指向包含小于第一个键的项的子树,最后一个指针指向包含大于或等于最后一个键的项的子树。其他指针则引用位于两个键之间的子树:,其中 K 是一组键, 是属于子树的键
一些 B 树变种在叶子级别还具有兄弟节点指针,以简化范围扫描。这些指针有助于避免回到父节点以找到下一个兄弟节点。一些实现中,指针在两个方向上都有,在叶子级别形成双向链表,使得反向迭代成为可能。
B 树的独特之处在于,它们不是从上到下构建的(如二分搜索树),而是从下到上构建的。叶子节点的数量增加,这增加了内部节点的数量和树的高度。
由于 B 树在节点内部为将来的插入和更新预留了额外空间,树的存储利用率可能低至 50%,但通常要高得多。较高的占用率不会对 B 树的性能产生负面影响。
查找复杂度
可以从两个角度看: 块传输次数和查找过程过程中的比较次数。从传输次数看,对数底数是N(每个节点的键的数量)。每深入一层,节点数量增加K倍,跟随子指针将搜索空间减少N倍。所以最多会寻址个页面才能找到查找的键。从根到叶子的过程中需要跟随的子指针数量也等于树的高度h。
从比较次数看,因为每个节点内部查找键是使用二分搜索完成的。每次比较将搜索空间减半,因此复杂度是.
在教科书和文章中,B 树查找复杂度通常视为,复杂度分析通常不使用对数底数,因为改变底数只是增加常数因子。
B树节点的插入
分裂
为了将值插入 B-树中,我们首先需要定位目标叶节点并找到插入点。为此,我们使用前面描述的算法。当找到叶节点后,键和值会被附加到该节点。如果目标节点没有足够的空间,我们称该节点已经“溢出”(overflow),并需要将其分裂为两个节点以适应新数据。更具体地说,当满足以下条件时,节点会被拆分:
- 对于叶节点:如果节点可以容纳最多 N 个键值对,并且插入一个键值对后会超出最大容量 N
- 对于非叶节点:如果节点可以容纳最多 N + 1 个指针,并且插入一个指针后会超出最大容量 N + 1
一般来说,B树的阶数为奇数,实际中N的取值通常在200
300之间,因此十亿条记录只需要45层。
拆分操作是通过分配新节点,将拆分节点的一半元素转移到新节点中,并将新节点的第一个键和指针添加到父节点中来完成的。在这种情况下,我们称键为“提升”(promoted)。拆分执行的索引被称为“拆分点”(split point),也称为“中点”(midpoint)。拆分点之后的所有元素(在非叶节点拆分的情况下包括拆分点)被转移到新创建的兄弟节点中,其余元素保留在拆分节点中。
如果父节点已满,没有足够的空间容纳提升的键和指针,则父节点也必须进行拆分。这一操作可能会递归传播到根节点。
一旦树达到其容量(即拆分传播到根节点),我们必须拆分根节点。当根节点被拆分时,会分配一个新的根节点,持有一个拆分点键。旧根节点(现在只包含一半条目)被降级到下一层,并与其新创建的兄弟节点一起存在,树的高度增加了一层。树的高度变化发生在根节点拆分并分配新根节点时,或者当两个节点合并形成新根节点时。在叶节点和内部节点层次上,树仅在水平方向上增长。
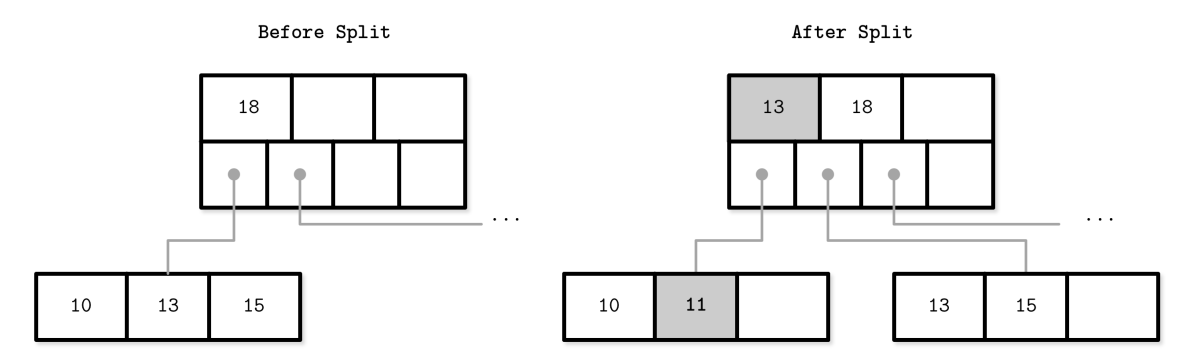
图 2-11 显示了在插入新元素 11 时完全占满的叶节点。我们在满节点的中间画一条线,将一半的元素留在节点中,其余的元素移动到新的节点中。拆分点值被放置到父节点中,作为分隔键
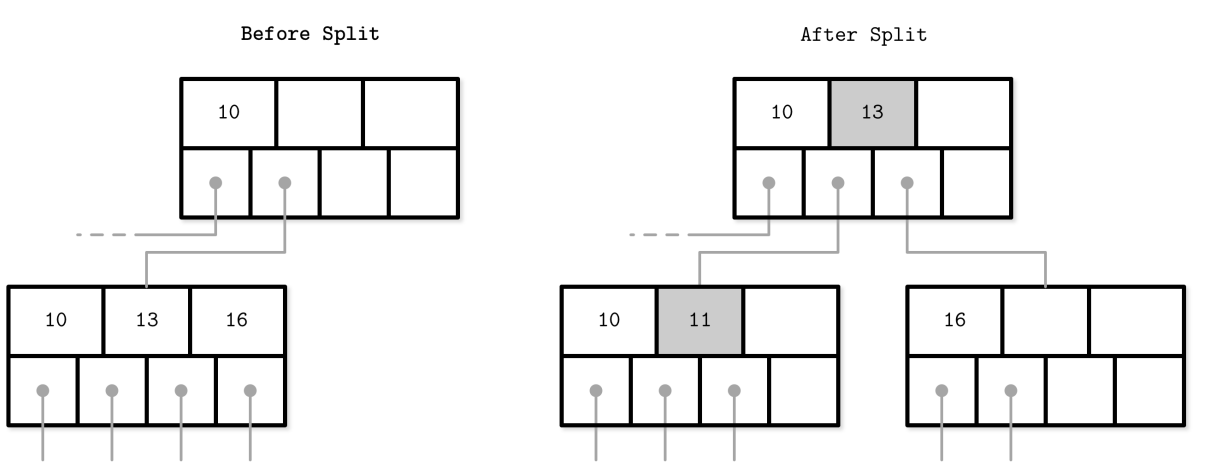
图 2-12 显示了在插入新元素 11 时完全占满的非叶节点(即根节点或内部节点)的拆分过程。为了执行拆分,我们首先创建一个新节点,并将从索引 N/2 + 1 开始的元素移动到新节点中。拆分点键被提升到父节点。
由于非叶节点拆分始终是从下层传播的拆分的表现,我们有一个额外的指针(指向新创建的节点的下一级)。如果父节点没有足够的空间,也必须进行拆分。
无论是叶节点还是非叶节点的拆分(即节点是否包含键和值或仅包含键),拆分过程的处理方式都是相同的。在叶节点拆分的情况下,键与其相关的值一起移动。
完成拆分后,我们得到两个节点,需要选择正确的节点来完成插入操作。为此,我们可以使用分隔键不变性。如果插入的键小于提升的键,我们通过在拆分节点中插入来完成操作。否则,我们在新创建的节点中插入。
- 分配一个新节点。
- 将拆分节点的一半元素复制到新节点中。
- 将新元素放入相应的节点。
- 在拆分节点的父节点中,添加一个分隔键和一个指向新节点的指针。
B树节点的合并
删除操作首先通过定位目标叶节点来进行。当找到叶节点后,将其键和值删除。如果相邻节点的值过少(即它们的占用率低于阈值),则需要将兄弟节点合并。这种情况被称为“欠载”(underflow),[BAYER72] 描述了两种欠载场景:如果两个相邻的节点有一个共同的父节点,并且它们的内容可以容纳在一个节点中,则它们的内容应合并(连接);如果它们的内容不能容纳在一个节点中,则需要在它们之间重新分配键以恢复平衡(参见第70页的“重新平衡”)。更准确地说,当以下条件满足时,两个节点会合并:
- 对于叶节点:如果一个节点可以容纳最多 N 个键值对,并且两个相邻节点的键值对总数小于或等于 N。
- 对于非叶节点:如果一个节点可以容纳最多 N + 1 个指针,并且两个相邻节点的指针总数小于或等于 N + 1。
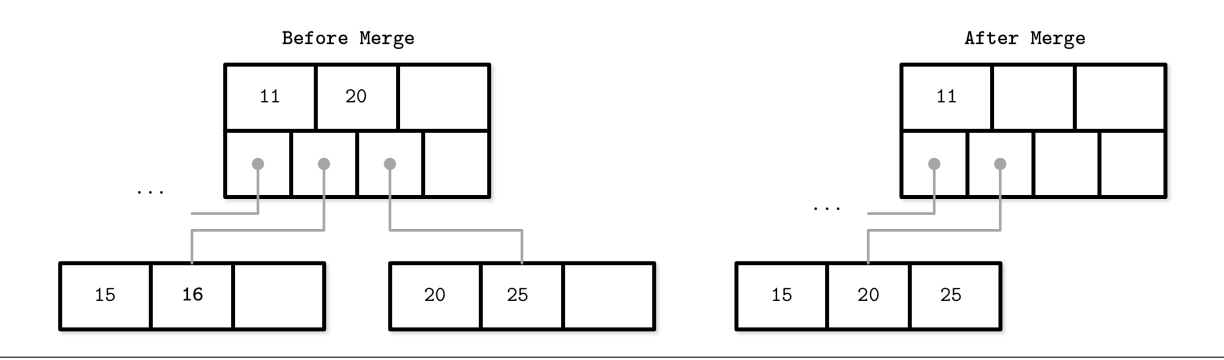
图 2-13 显示了删除元素 16 时的合并过程。为此,我们将一个兄弟节点的元素移动到另一个兄弟节点。通常,元素从右侧兄弟节点移动到左侧节点,但也可以反过来,只要保持键的顺序不变即可。
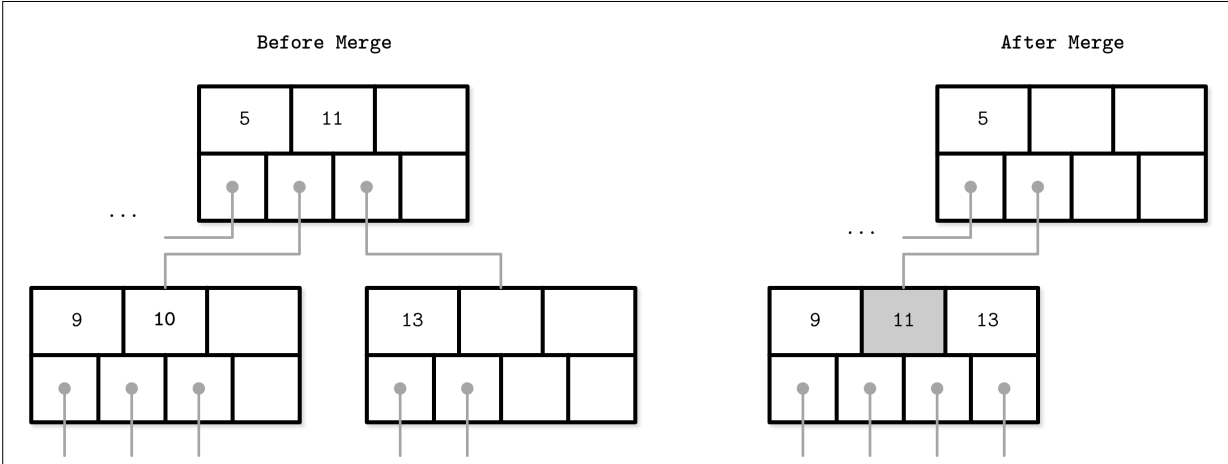
图 2-14 显示了在删除元素 10 时需要合并的两个兄弟非叶节点。如果我们将它们的元素合并,它们适合一个节点,因此我们可以用一个节点代替两个节点。在合并非叶节点时,我们需要从父节点中提取相应的分隔键(即降级它)。指针的数量减少一个,因为合并是由下层页面删除的指针传播导致的。与拆分类似,合并也可能传播到根节点。
总结一下,节点合并的过程分为三个步骤,假设元素已经被删除:
- 将右侧节点的所有元素复制到左侧节点。
- 从父节点中移除右侧节点指针(或在非叶节点合并时降级它)。
- 移除右侧节点。
满的节点y有(m-1个关键字)按其中间节点y.key[[m/2](向上取整,如果从1开始索引)]。 一般来说,阶数是奇树, 比如9阶B树,有叶子节点有9个关键字,需分出中间关键字y[ [m/2] (向上取整) ] ,两边就有相同的分裂节点。将中间关键字提升到y的父节点,如果也是满树、则,必沿着树向上传播。