
Lec 5线性时间排序
Lec 5 线性时间排序
资料依据:课程视频与 transcript · Lecture notes
TL;DR
- 比较排序的 下界只适用于算法仅通过比较区分元素的模型。
- 计数排序利用有限整数键域,在 时间内完成稳定排序,其成本依赖键域大小 。
- 基数排序将键拆成多个数位,从低位到高位反复调用稳定排序,在合适的数位基数下可达线性时间。
回顾
-
任意含有 n 个节点的决策树,其高度至少为,这也是比较查找的下界。 也就是说搜索操作需要的时间复杂度
-
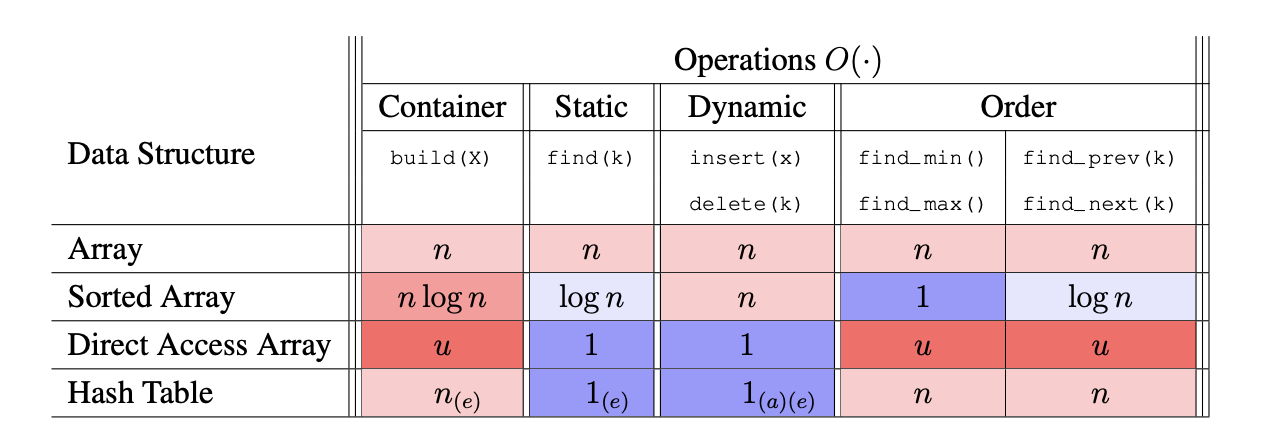
通过 RAM(随机访问)和直接访问数组(Direct Access Array),可以加快搜索速度。特点是索引查找很快,但是需要大量的空间 。直接访问数组本质上与数组没什么区别,只是对其 slot 提供了外部语义。 (u > n)
-
解决空间问题可以通过映射(哈希)将键空间 u 下降到 。 哈希表在期望情况下可以实现 O(1) 时间复杂度的操作,如果是动态哈希表,则是均摊的 O(1)
- 期望情况是,当哈希表的 slot 满足输入规模,且你的输入是独一无二的,那么你不需要检查冲突(不需要遍历链表的检查),此时最坏的情况就是线性时间
-
期望输入无关:可以通过从通用(universal)哈希函数族中随机选择哈希函数。
上一次我们实现了更快的查找,我们能否实现更快的排序呢?
比较排序下界
- 比较模型意味着算法决策树是二叉的(即固定的分支系数)。
- 叶节点的数量 L 至少等于可能输出结果的数量
- 决策树的高度下界:, 因此最坏情况下的运行时间是
- 排序 n 个元素的数组时,输出的排列总数为
- 因此决策树的下界为,根据斯特林共识推导
- 因此归并排序是比较模型中的最优的
能否通过直接访问数组(Direct Access Array)实现更快的排序?
直接访问数组排序
示例:数组 [5, 2, 7, 0, 4]
假设: 所有键的范围为内唯一的非负整数,因此有 ;将每个元素插入大小为 u 的直接访问数组,时间复杂为,以直接访问数组中的顺序返回元素,时间复杂度为, 总的时间复杂度为。当 u = 时,则时间复杂度为
def direct_access_sort(A):
    "Sort A assuming items have distinct non-negative keys"
    u = 1 + max([x.key for x in A]) # O(n) 查找最大键
    D = [None] * u # O(u) 创建直接访问数组
    for x in A: # O(n) 插入元素
        D[x.key] = x
    i = 0
    for key in range(u): # O(u) 按顺序读取元素
        if D[key] is not None:
            A[i] = D[key]
            i += 1
若键域更大,例如 ,直接计数排序不再是线性时间,该怎么办?
想法: 将每个键 k 表示为,其中 且 ,具体而言, 且 b = k % n = k mod n
- python 中
divmod(k, n)进行拆分可得到元组(a, b) - 对于
[17, 3, 24, 22, 12],则 n = 5 我们得到[(3,2), (0,3), (4,4), (4,2), (2,2)],即按 n=5 得出[32, 03, 44, 42, 22]
如何对元组进行排序呢?
元组排序
元组排序
假设我们想要对包含多个不同键的元组进行排序(例如,每个元组有键 x.k1, x.k2, x.k3, ...),要求排序是按这些键的某种优先顺序进行的字典序排序(例如,键 k1 的优先级高于键 k2,键 k2 高于键 k3,以此类推)。因此,元组排序使用一个稳定的排序算法作为子程序,从最不重要的键到最重要的键进行排序,最终实现字典序的排序。
元组排序的过程类似于在电子表格上按多列对多行数据进行排序。然而,为了确保元组排序的正确性,先前排序的结果必须在随后的排序轮次中得到保留。因此,元组排序要求使用的子程序排序算法必须是稳定的。
问题!许多整数可能具有相同的 a 或 b 值,即使输入键各不相同。我们需要允许重复键并保留输入顺序的排序方法。我们希望排序是稳定的:在输出中,重复的键按照输入的顺序出现。直接访问数组排序无法对包含重复键的数组进行排序!
我们是否可以修改直接访问数组排序,使其能够稳定地处理多个键?
在每个数组索引处存储的不只是一个元素,而是一个链表,就像哈希表一样!(计数排序)
计数排序
我们只需将一个链表链接到每个直接访问数组索引上,就像在哈希中那样。当多个元素具有相同的键时,我们将它们都存储在与其键关联的链表中。之后,这个算法的稳定性将非常重要:具有相同键的元素应在输出中按照输入中的顺序出现。因此,我们选择支持序列队列接口的链表来保持元素的顺序,将元素插入到队列末尾,然后按插入顺序返回元素
def counting_sort(A):
    "Sort A assuming items have non-negative keys"
    u = 1 + max([x.key for x in A])  # 查找最大键
    D = [[] for i in range(u)]       # 直接访问数组的链表
    for x in A:
        D[x.key].append(x)           # 在键为 x.key 的链表中插入元素
    i = 0
    for chain in D:                  # 按顺序读取每个链表中的元素
        for x in chain:
            A[i] = x
            i += 1
在初始化直接访问数组的链表时,计数排序需要 时间,插入所有元素时需要 时间,然后在扫描直接访问数组并返回元素时需要 时间。因此,算法的运行时间为 。同样,当 时,计数排序在允许重复键的情况下也可以在线性时间内运行。
计数排序的另一种实现是仅记录每个键在每个索引的计数,然后只移动每个元素一次,而不是像上面那样将每个元素移动到链表中,然后再放回。下面的实现通过累积求和计算每个元素的最终索引位置。
def counting_sort(A):
    "Sort A assuming items have non-negative keys"
    u = 1 + max([x.key for x in A])  # 查找最大键
    D = [0] * u                      # 直接访问数组
    for x in A:
        D[x.key] += 1                # 统计每个键的数量
    for k in range(1, u):
        D[k] += D[k - 1]             # 计算累积和
    for x in list(reversed(A)):
        A[D[x.key] - 1] = x          # 将元素放置到最终位置
        D[x.key] -= 1
现在,如果我们希望对更大整数范围的键进行排序,我们的策略将是将整数键拆分为多个部分,然后对每个部分进行排序!为此,我们需要一种对元组(即多个部分)进行排序的策略。
基数排序
基数排序(Radix Sort)思想:
为了扩大可以在线性时间内排序的整数集合的范围,我们将每个整数拆分为以 n 为底的幂的倍数,表示每个项的键为其在基数 n 下的数字序列。如果这些整数都是非负的,并且集合中的最大整数为 u,则该基数为 n 的数将有 位数字。我们可以将这些数字表示视为元组,然后用元组排序(tuple sort)来对这些数字按从最低有效位到最高有效位的顺序逐位使用计数排序进行排序。将元组排序与计数排序结合起来的这种方法称为基数排序(radix sort)。如果集合中的最大整数 ,则基数排序的运行时间为 。因此,如果 c 是常数,那么基数排序的运行时间也就是线性的!
def radix_sort(A):
    "Sort A assuming items have non-negative keys"
    n = len(A)
    u = 1 + max([x.key for x in A])  # O(n) 找到最大键
    c = 1 + (u.bit_length() // n.bit_length())
    class Obj: pass
    D = [Obj() for a in A]
    for i in range(n):  # O(nc) 构造数字元组
        D[i].digits = []
        D[i].item = A[i]
        high = A[i].key
        for j in range(c):  # O(c) 生成数字元组
            high, low = divmod(high, n)
            D[i].digits.append(low)
    for i in range(c):  # O(nc) 对每一位数字排序
        for j in range(n):  # O(n) 将第 i 位作为键分配给元组
            D[j].key = D[j].digits[i]
        counting_sort(D)  # O(n) 对第 i 位数字排序
    for i in range(n):  # O(n) 输出到 A
        A[i] = D[i].item
我的理解
我的理解
所谓“突破排序下界”其实是更换了模型:算法用了键是机器字、可分解或可寻址的信息。因此分析中必须把 和字长写清楚。