
Lec 6代码生成
Lec 6 代码生成
配套复习课:R5 SSA(第 9 节)、R6 控制流图、R7 x86 汇编——后两者内容已大量融入本讲正文 参考:Cooper et al., Ch.6 过程抽象 / 实现过程;Ch.7 代码形态(Code Shape)
TL;DR
- 代码生成把结构化 IR 降级为基本块和 CFG,再线性化为符合 x86-64 ABI 的汇编。
- 短路条件、过程调用、栈帧、数组边界检查等都应通过小而可验证的降级模式实现,先保证正确性再优化。
- SSA 通过单次定义和 φ 节点显式化 def-use 关系,为后续优化与寄存器分配提供更直接的表示。
1. 本节学习目标
结构化 IR → 控制流图 (control flow graph,CFG) → 生成的汇编代码
本讲强调未优化 代码生成:现在只做最简单的事,把优化作为独立主题留到后面。代码生成器要保持简单,宁可生成 0 + 1*x + 0*y 这样的丑代码,也让优化器后续去清理。
2. 控制流图
定义
Definition:控制流图
它是这样一种图:
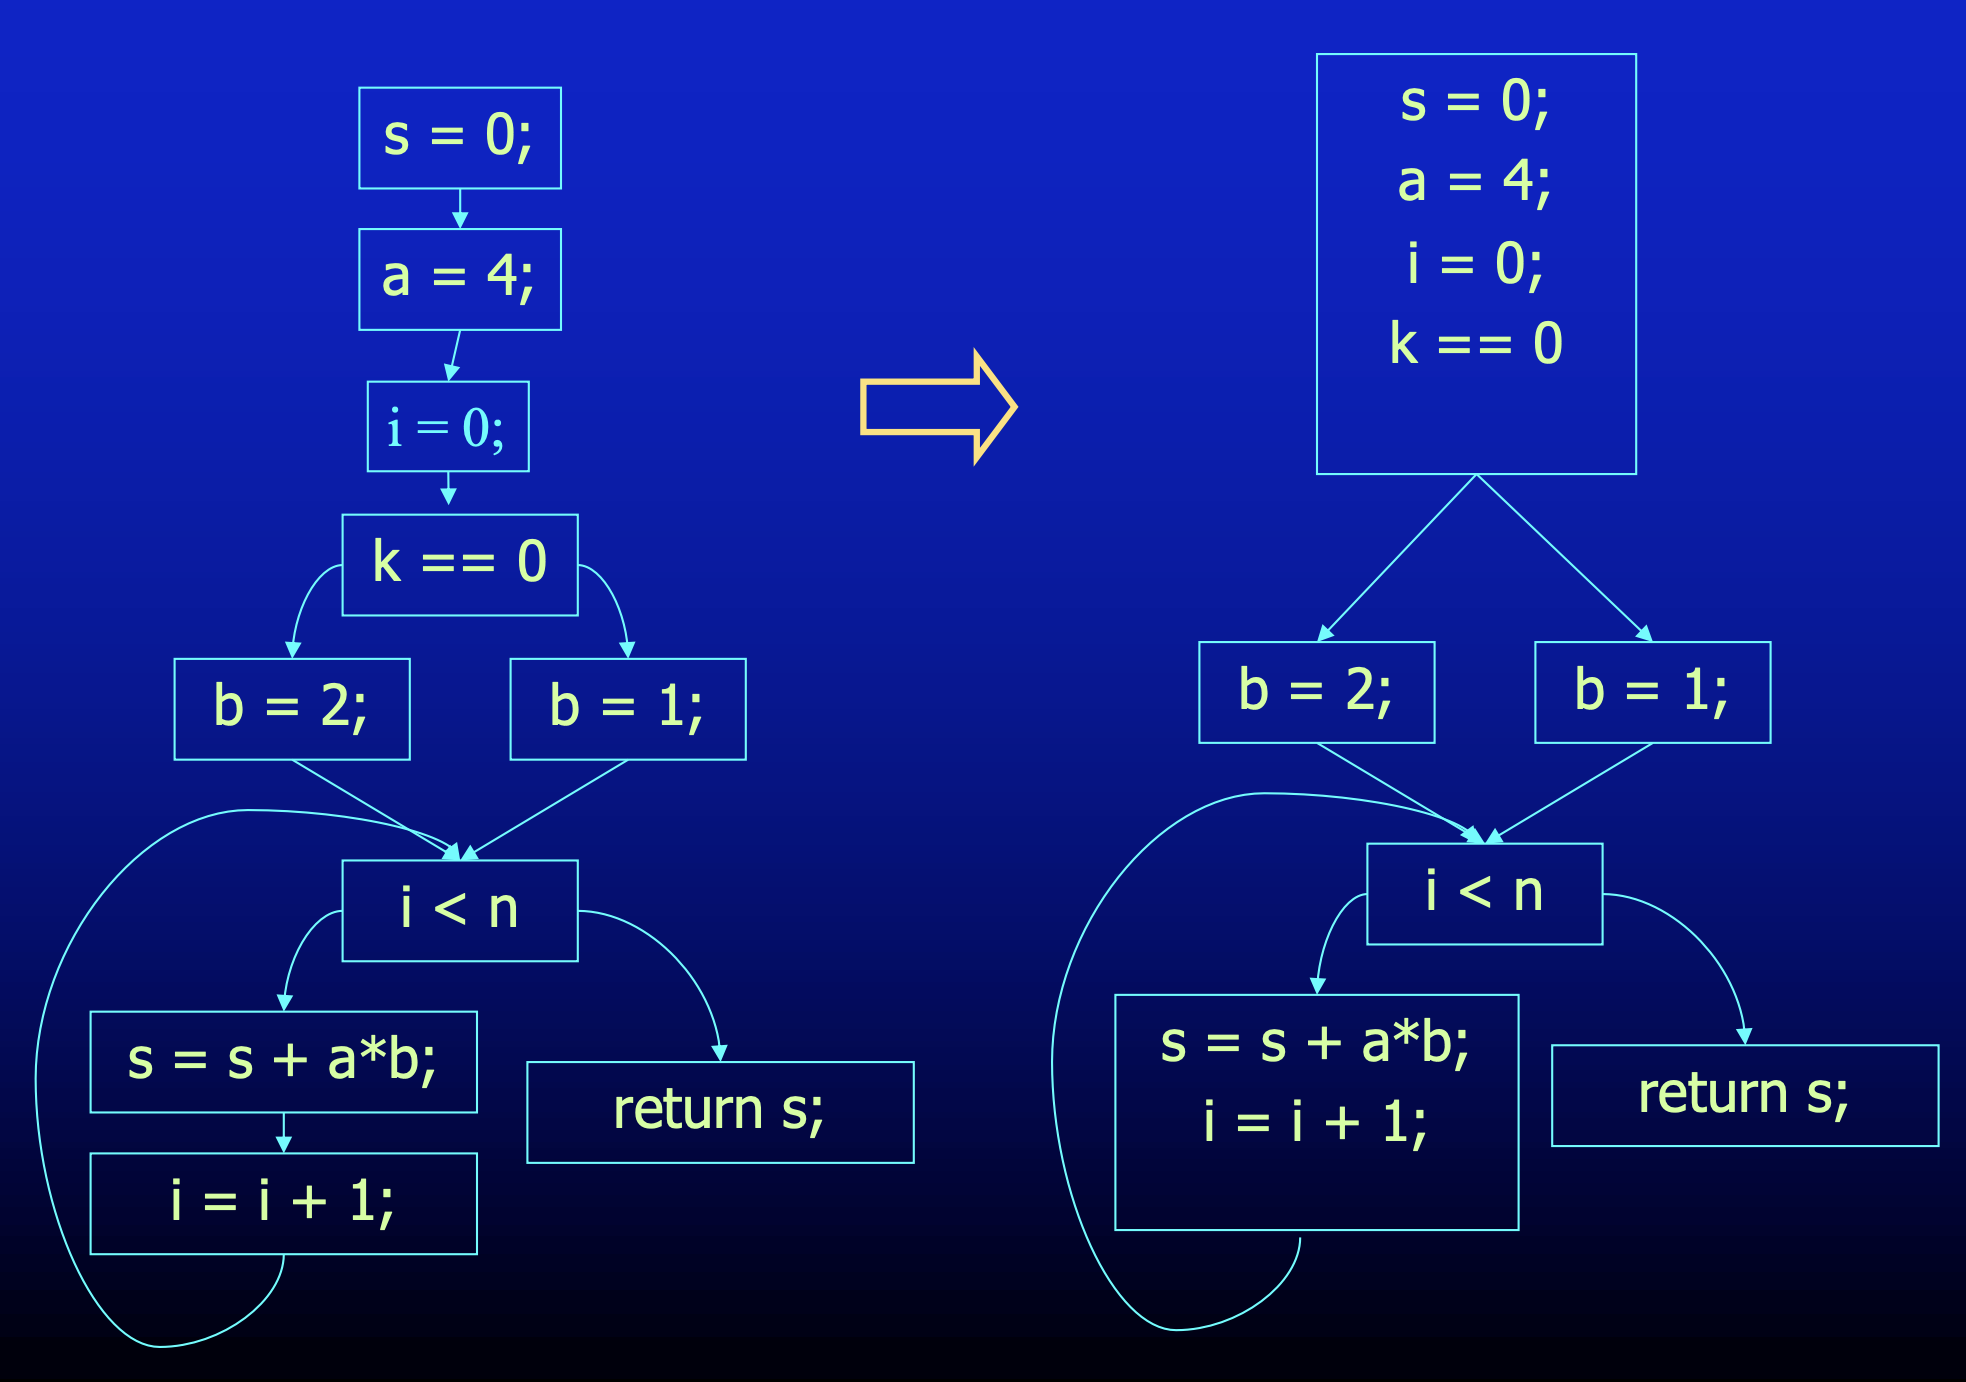
- 节点表示计算
- 每个节点是一个基本块 。
- 基本块是一段指令序列,满足:
- 中间没有分支跳出
- 中间没有分支跳入;
- 基本块应当极大化;
- 执行从首指令开始
- 包含块内全部指令;
- 边表示控制流。
2.1 结构化 IR → CFG 的模式
if-then-else:if 节点(无操作 nop)下挂 condition、then、else 的 CFG,汇合于一个 nop。
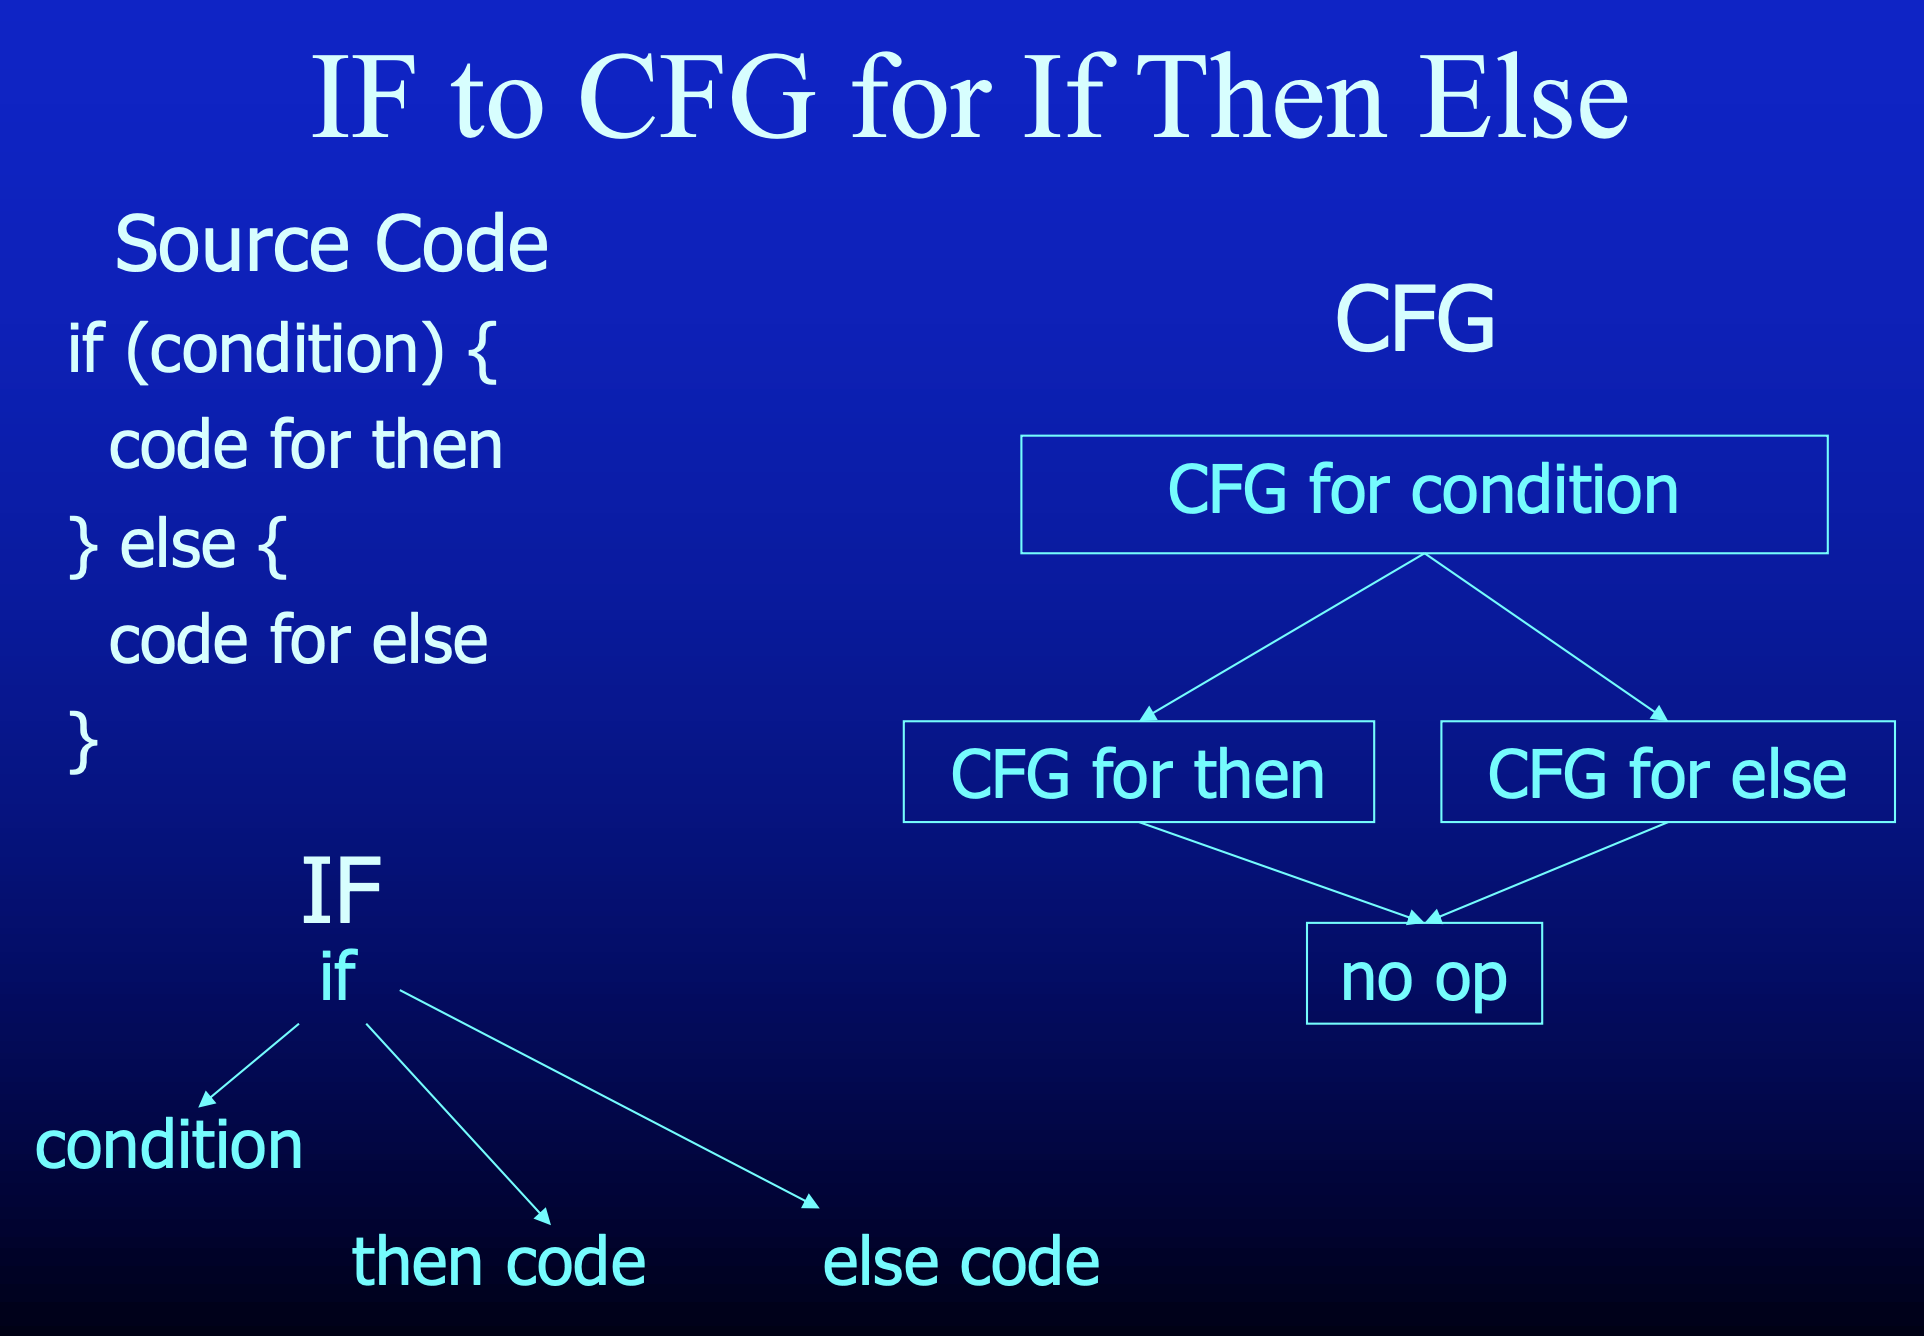
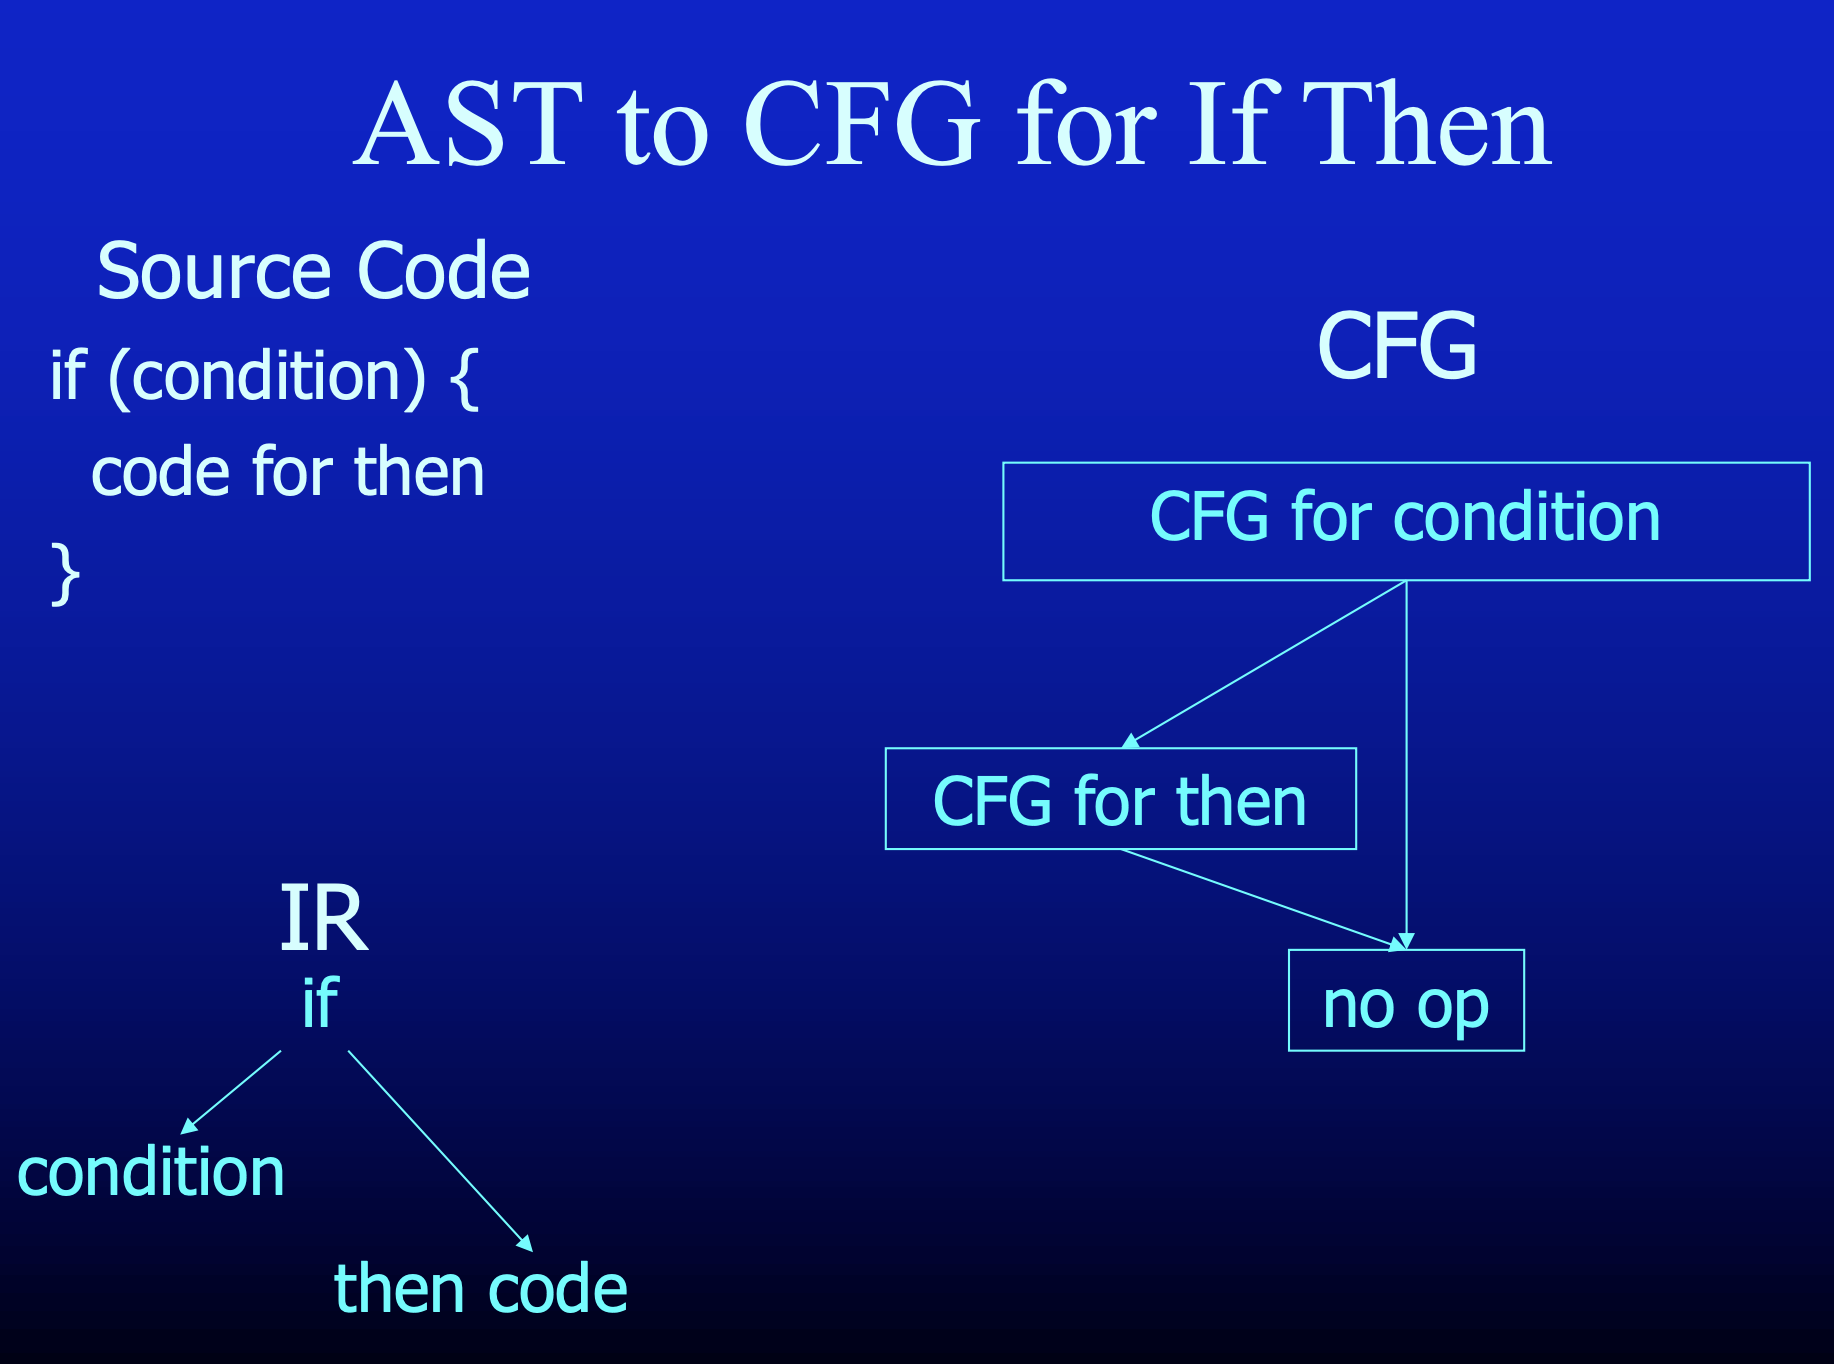
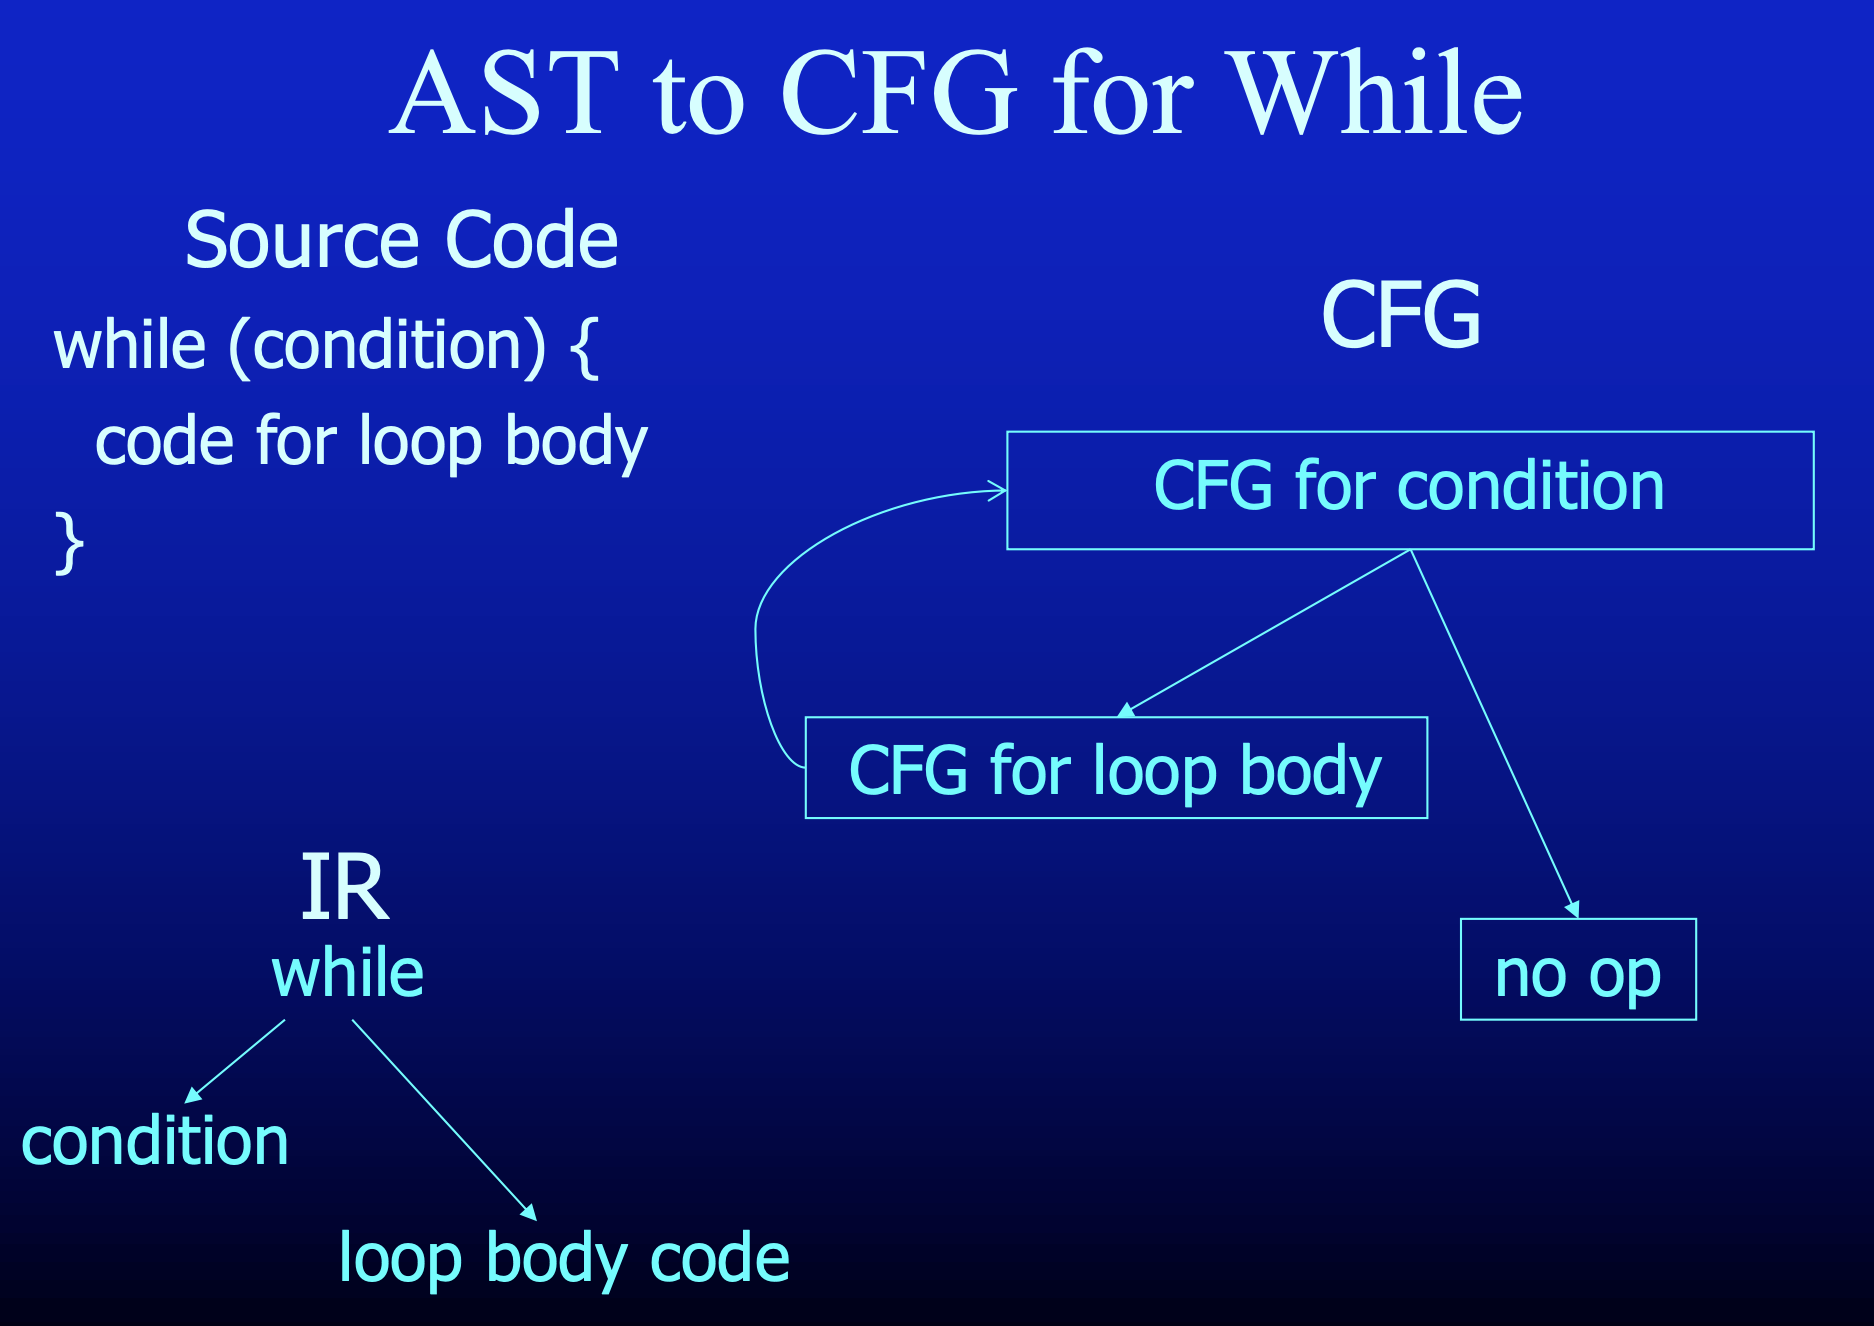
if-then、while、语句序列 seq 各有对应模式。
2.2 基本块构造
定义
Definition:基本块合并算法
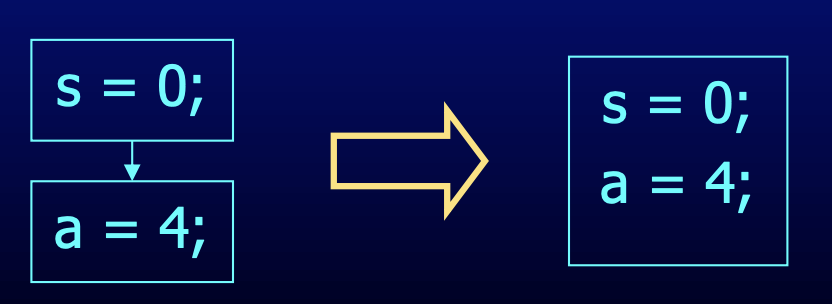
从逐个指令的控制流图出发,遍历所有边,当且仅当:第一个节点只有一条出边,且第二个节点只有一条入边 时,合并相邻两节点
2.3 程序点、分裂点与汇合点
- 每条语句前后各有一个程序点 (program point)。
- 分裂点 (split point):有多个后继——只有条件分支语句是分裂点。
- 汇合点 (merge point):有多个前驱。
- 每个基本块:要么以汇合点开始、要么其前驱以分裂点结束;要么以分裂点结束、要么其后继以汇合点开始。
3. 短路条件与"解构"
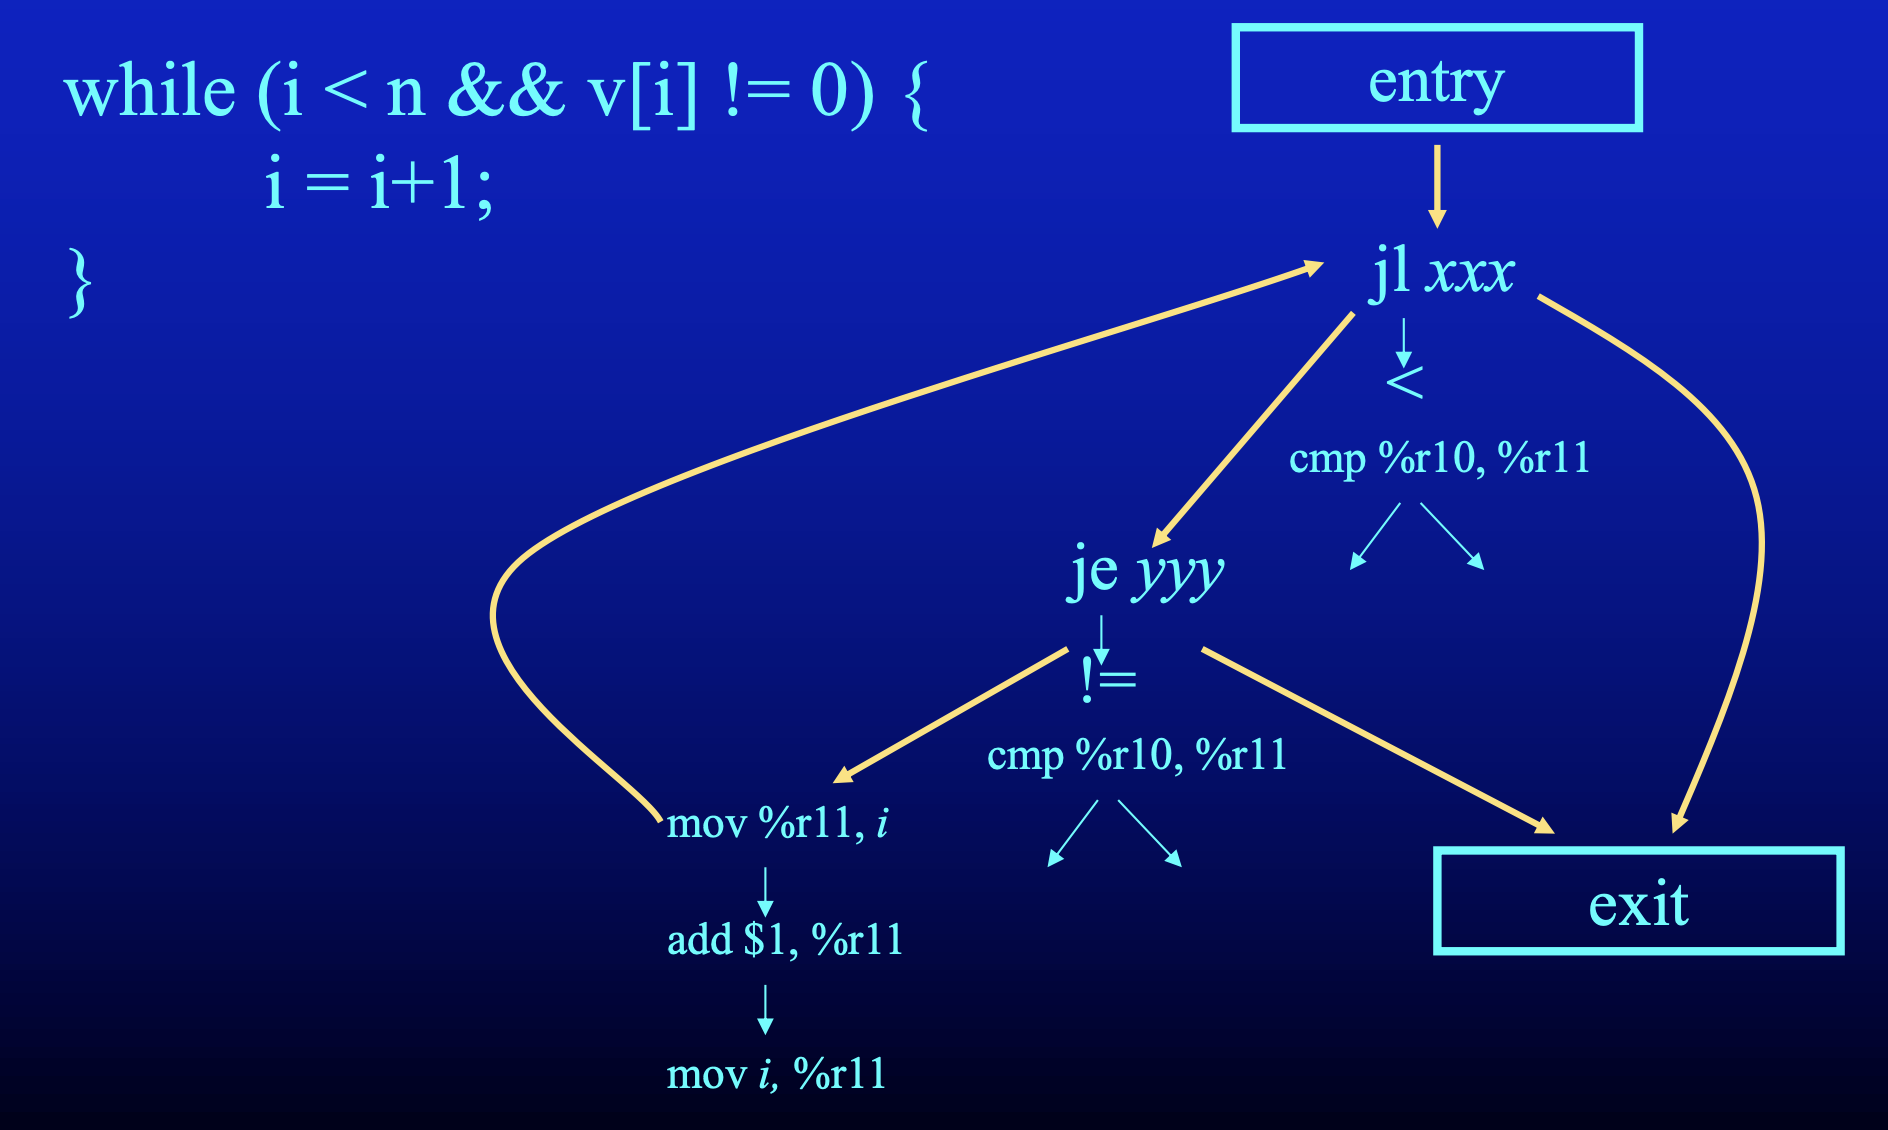
布尔条件需短路求值:((i<n) && (v[i]!=0)) || i>k 中,只在 (i<n) 为真时才求 (v[i]!=0)。
用 CFG 表示这种短路:
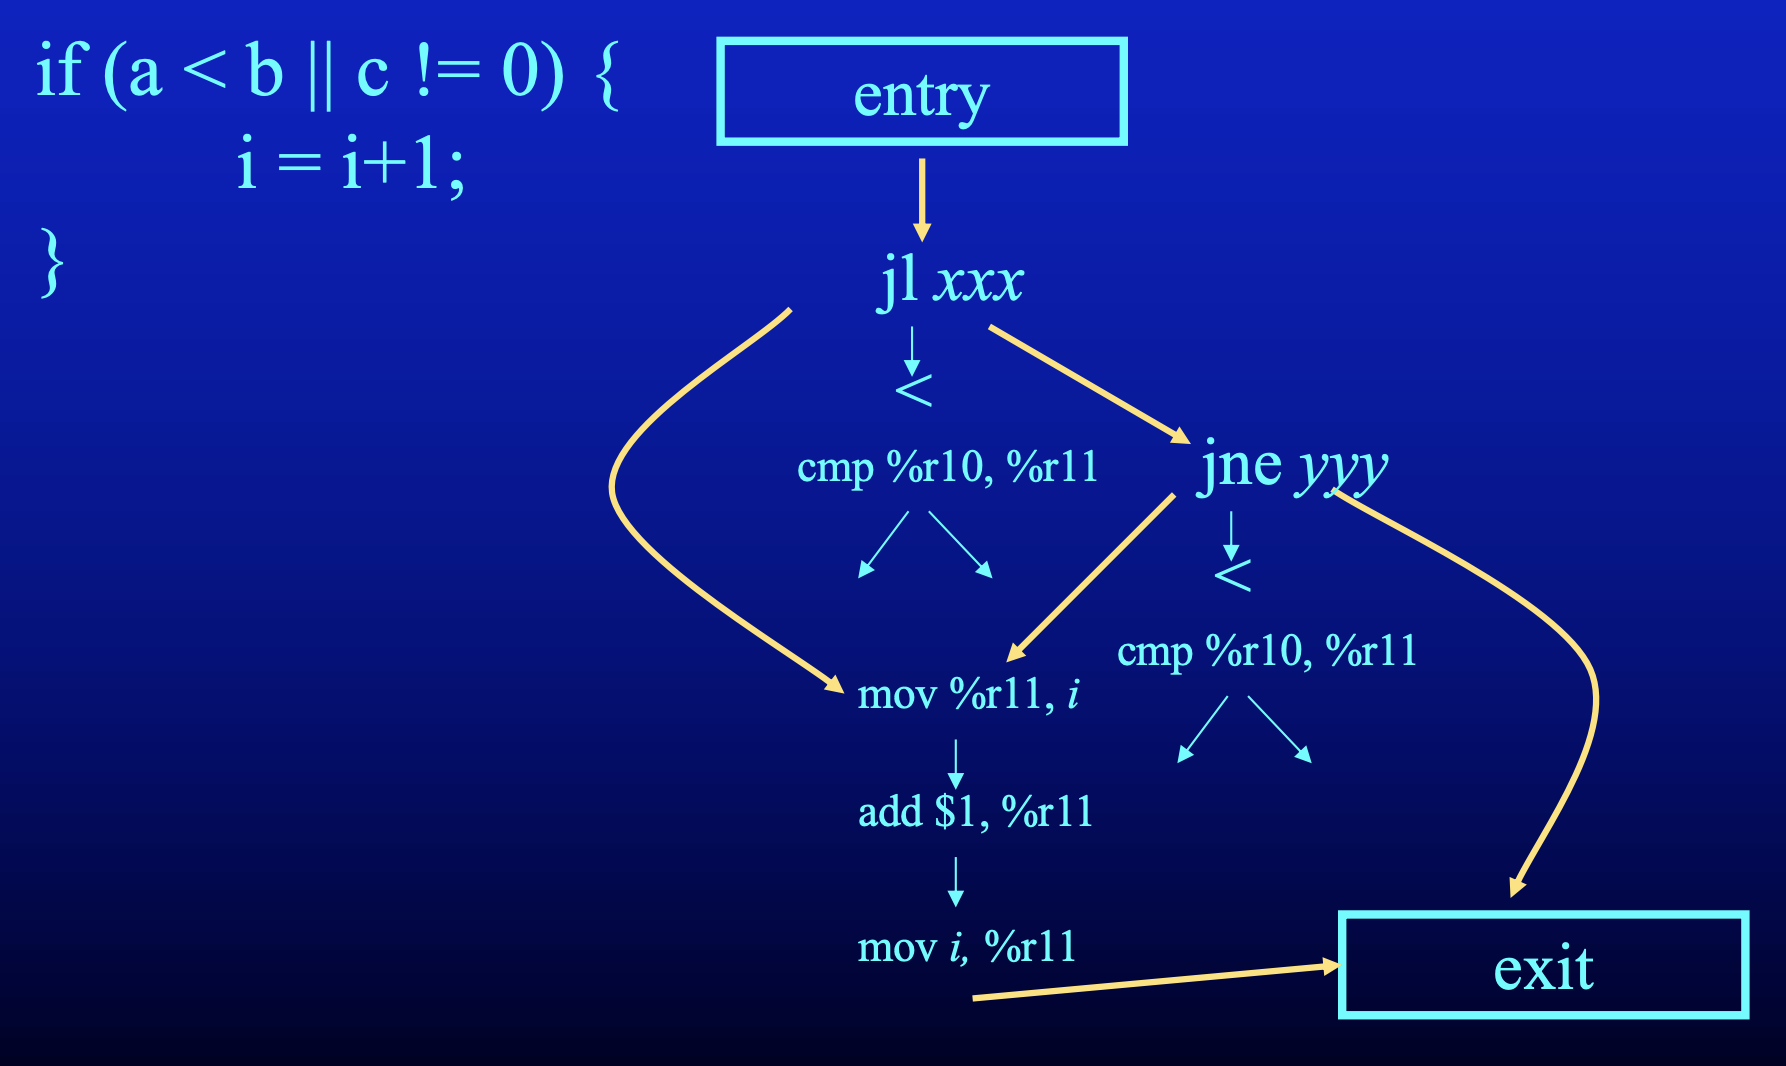
另外一个例子:
3.1 两个解构例程
定义
Define 解构与短路
destruct(n):生成结构化节点 n 的降级形式,返回 (b, e)——b 是起始节点, e 是结束节点
shortcircuit(c, t, f):生成条件 c 的短路形式;
- c 为真则流向 t,
- c 为假则流向 f;
- 返回起始节点 b —— b 是条件求值的开始点
- 引入新节点类型 nop。
destruct 各情形(关键边连接):
seq x y:   (bx,ex)=destruct(x); (by,ey)=destruct(y); next(ex)=by; return (bx,ey)
if c x y:  (bx,ex)=destruct(x); (by,ey)=destruct(y); e=new nop;
           next(ex)=e; next(ey)=e; bc=shortcircuit(c,bx,by); return (bc,e)
while c x: e=new nop; (bx,ex)=destruct(x);
           bc=shortcircuit(c,bx,e); next(ex)=bc; return (bc,e)
shortcircuit 各情形(递归结构归纳):
c1 && c2:  b2=shortcircuit(c2,t,f); b1=shortcircuit(c1,b2,f); return b1
c1 || c2:  b2=shortcircuit(c2,t,f); b1=shortcircuit(c1,t,b2); return b1
! c1:      b=shortcircuit(c1,f,t); return b           // 交换 t/f
e1 < e2:   b=new cbr(e1<e2, t, f); return b           // 计算型条件,发出 cmp/jl
注意
&&把f同时传给两支(任一假即假);||把t同时传给两支(任一真即真);!交换真假目标。
3.2 nop 的消除
解构会留下 nop 节点,最后用窥孔优化 (peephole optimization) 消除(如 jmp .L0; .L0: 中的多余 jmp)。
4. 线性化 CFG 为汇编(Linearizing)
- 在分支处为边目标生成标签 (labels)——对应跳转目标。
- 发出过程入口代码 → 各基本块代码(语句/条件表达式,适当线性化,用 jmp/条件 jmp 连接)→ 过程出口代码。
5. 现代 ISA 与内存布局
ISA 四要素:内存、寄存器、ALU、控制。计算模型:从内存 load 到寄存器 → 在寄存器上计算 → store 回内存;控制流决定执行什么。编译器的角色:编排寄存器使用、生成与机器交互的低层代码。
5.1 典型内存布局
高地址  ┌─────────────┐
        │  Stack      │ 局部变量 / 临时值 / 部分参数(向下增长)
        ├─────────────┤
        │  (Unmapped) │
        ├─────────────┤
        │  Heap       │ 动态分配(向上增长,sbrk 扩展)
        ├─────────────┤
        │  Data       │ 全局变量
        │  RO Data    │ 只读常量
        │  Text       │ 程序代码
低地址  └─────────────┘
5.2 x86-64 寄存器与调用约定
定义(System V x86-64 调用约定)
-
16 个 64 位寄存器:
%rax,%rbx,%rcx,%rdx,%rdi,%rsi,%rbp,%rsp,%r8–%r15。 -
前 6 个整型/指针参数依次在
%rdi,%rsi,%rdx,%rcx,%r8,%r9,其余压栈。 -
返回值(≤64 位)在
%rax,更长的经栈返回。 -
%rbp标记当前帧起点,%rsp标记栈顶。 -
被调用者保存 (callee-save):
%rsp,%rbx,%rbp,%r12–%r15(过程前后须一致);调用者保存 (caller-save):%rax,%rcx,%rdx,%rsi,%rdi,%r8–%r11。 :::
5.3 调用栈帧
        ┌────────────────────┐  ← 高地址
        │ argument n …7       │  16(%rbp), 24(%rbp)…
        │ return address      │  8(%rbp)
%rbp →  │ previous %rbp       │  0(%rbp)
        │ local 1 … local m   │  -8(%rbp)…
%rsp →  │ (栈顶)              │  ← 低地址
        └────────────────────┘
5.4 过程联接(Procedure Linkage)
::: definition 定义(标准过程联接四段)
-
Pre-call(调用方):保存 caller-save 寄存器;设置参数(1–6 进寄存器,7–N 压栈)。
-
Prolog(被调方入口):压旧帧指针;保存 callee-save;为参数/临时/局部腾空间。
enter $size, $0一次完成压 %rbp、复制 %rsp→%rbp、下移 %rsp。 -
Epilog(被调方出口):恢复 callee-save;弹旧帧指针;存返回值。
leave; ret。 -
Post-return(调用方):恢复 caller-save;弹出参数。 :::
6. 生成过程体代码(Generate Procedure Body)
6.1 表达式扁平化(Flatten Expressions)
把表达式化为三地址形式:所有运算形如 temp1 = temp2 op temp3、temp1 = temp2[temp3]、if (temp1 op temp2)、while (temp1 op temp2)。
求值表达式树的两种模型:
- 栈模型 (Stack Model):求左子树压栈、求右子树压栈、取栈顶两值运算再压栈——非常低效。
- 平铺列表模型 (Flat List Model):左到右深度优先遍历表达式树,为每个中间结点分配临时变量(暂存栈上),每个表达式是单条三地址运算
x = y op z:把y载入%rax、op z, %rax、%rax存回x。
降级表达式的问题:寄存器有限,树大时不够 ⇒ 临时值放栈上;代价是拷贝过多——但别担心,优化趟会处理;保持代码生成器极简。
6.2 未优化代码生成模板(Templates)
temp = var:        mov var(%rbp), %rax ; movq %rax, temp(%rbp)
temp = temp op temp: mov t2, %rax ; add t3, %rax ; movq %rax, t1
temp = arr[idx]: mov idx, %r10 ; mov arr(,%r10,8), %rax ; movq %rax, t1%rax作工作寄存器;%r10作数组下标寄存器;临时值都在栈上。
6.3 数组访问与边界检查(Bounds Check)
数组访问前先检查下标合法:
cmp $0, idx         ; idx < 0 ?
jl  .boundsbad
mov idx, %rax
cmp $bound, %rax    ; idx >= bound ?
jge .boundsbad
jmp .boundsgood
.boundsbad:
    mov idx, %rdx   ; 参数1=下标
    mov $elemSize, %rcx
    call .boundserror
.boundsgood:
    mov idx, %r10
    mov arr(,%r10,8), %rax
全局数组声明 int values[20]; 对应汇编伪指令 .comm values,160,8(名、大小字节、对齐)。
6.4 控制流模板
::: example 例题(if-then-else 模板)
if (ax > bx) dx = ax - bx; else dx = bx - ax;
————————————————————————————————
    movq 16(%rbp), %r10        ; ax
    movq 24(%rbp), %r11        ; bx
    cmpq %r10, %r11
    jg  .L0                    ; 条件真跳 then
    movq 24(%rbp), %r10        ; FALSE: dx = bx - ax
    movq 16(%rbp), %r11
    subq %r10, %r11
    movq %r11, -8(%rbp)
    jmp .L1
.L0:                           ; TRUE: dx = ax - bx
    movq 16(%rbp), %r10
    movq 24(%rbp), %r11
    subq %r10, %r11
    movq %r11, -8(%rbp)
.L1:
while 循环优化模板(把测试放循环末尾,减少一次 jmp):
lab_cont:
    <do the test> ; joper lab_end   // 条件不满足跳出
    <body>
    jmp lab_cont
lab_end:
do-while 模板:lab_begin: <body> <test> joper lab_begin。
7. 从汇编到目标文件(Object File)
汇编语言优点:符号指令与符号名简化代码生成、提供逻辑抽象层、一种汇编可描述多架构。缺点:需额外汇编与链接、汇编器有开销。
- 可重定位机器码 (relocatable):地址用符号表示,链接/加载期映射到内存地址,支持分离编译。
- 绝对机器码 (absolute):地址硬编码,简单但不灵活,用于中断处理与设备驱动。
目标文件含多个段(Global Offset Table、Procedure Linkage Table、Text、Data、RO Data)、符号信息、重定位信息。OS 读目标文件→在内存建可执行进程→运行。
8. 代码生成器编写准则(Guidelines)
定理(代码生成器工程准则)
-
缓慢降级抽象层:多趟、每趟只做少量(或一件)事,便于分解与调试。
-
保持抽象层一致:IR 应始终有"正确"语义,趟与趟之间可插入部分优化。
-
编写并经常运行理智/一致性检查 (sanity checks)。
-
做最简单(甚至笨)的事,把优化交给优化器;面向优化器需要的形态来组织代码。
-
建立良好测试基础设施:回归测试(把触发 bug 的输入加入回归集)、二分查找 / delta debugging 找 bug。 :::
为什么用栈分配活动记录(而非静态预分配或堆分配)?支持递归与可重入、按调用动态伸缩、后进先出与调用嵌套自然吻合、回收开销 O(1)。
9. 静态单赋值形式(SSA)
该节为理论补充,项目中不要求实现 SSA。基于 SSA-based Compiler Design(Rastello 等)第 1–3 章。
9.1 什么是 SSA
一种低层 IR,其中每个变量恰好被定义一次(静态性质)。等价直觉:变量不可变;同名变量的每次出现都有相同的值;"SSA 即函数式编程"(Appel 1998)。
基本块内转 SSA:给每次定义一个新下标名。
a ← 1            a1 ← 1
b ← a + 1        b1 ← a1 + 1
a ← a + b   ⟹   a2 ← a1 + b1
c ← a + 1        c1 ← a2 + 1
a ← b + c        a3 ← b1 + c1
9.2 φ 函数(Phi Function)
在 CFG 的汇合点,不同控制流路径带来不同定义,需用 φ 函数合并:
定义(φ 函数)
表示根据所走的控制流路径,从 或 中选一个值。φ 节点放在汇合点(基本块开头),保证"每个变量仍只定义一次"
9.3 为什么 SSA 有用
SSA 让程序分析更简单更快——把 def-use 链这一关键环节一次性算好:
- def-use 链数量:无 SSA 时,N 个定义、N 个使用,每个使用可能来自任一定义 → 最坏 ;有 SSA 时每个使用只来自唯一定义 → 。
- 到达定义 (reaching definitions):有 SSA 只需看定义与使用是否同名。
- 可用表达式 (available expressions):原需"求值后 x、y 未被重新赋值"的条件,SSA 下自动满足(不可变)。
- 活跃性 (liveness):变量在其定义点活跃 ⟺ 它有使用。
- 据此可直接驱动常量传播(唯一定义且为常量)、复制传播(唯一定义且为拷贝)、归纳变量识别等。
9.4 SSA 构造(Construction)
朴素法:每个基本块开头给所有变量加 φ 节点,逐块转 SSA 并把"最后定义"传播到后继块的 φ;问题是 φ 节点过多(事后用复制传播 + 死代码消除清理)。
标准(高效)法:
定义(基于支配的 SSA 构造)
- 计算支配树 (dominator tree)。
- 对变量 在基本块 的每次赋值,计算迭代支配边界 ,在 的每个块放 的 φ 节点。
- 按支配树的 DFS 顺序遍历各块,重命名变量。
支配关系:
定义(支配 / 严格支配 / 直接支配 / 支配边界)
-
若从入口到 的每条路径都经过 ,则 支配 (dominate) 。
-
时为严格支配。
-
若不存在 使 严格支配 且 严格支配 ,则 直接支配 (immediately dominate) ;除入口外每个节点有唯一直接支配者,构成支配树。
-
支配边界 : 所支配 CFG 区域的"边界"——精确地,满足" 支配 的某个直接前驱、但不支配 "的节点 的集合。
-
迭代支配边界:, 的极限 。 :::
9.5 SSA 析构(Destruction)
最简单法:在 φ 节点各前驱块末尾插入相应赋值(如 a5 ← a3 / a5 ← a4)。这会产生额外拷贝,但合并式寄存器分配器 (coalescing register allocator) 能消掉它们(注意环的特例)。
可靠的 lowering 应每次只显式化一类约束:先把控制流变成 CFG,再把值变成三地址操作,最后适配 ABI 和 ISA。一次跨越太多语义层,就会让验证和调试同时失去落点。
10. CFG、x86-64 与 SSA 小结
- 流程:结构化 IR → CFG → 线性化汇编;强调先做未优化的最简单版本。
- CFG = 基本块(极大、无中途跳入跳出)+ 控制流边;合并相邻单入单出节点构造。
- 短路条件用
destruct/shortcircuit按结构归纳生成,&&/||/!分别处理真假目标;nop 由窥孔消除。 - x86-64:前 6 参数入寄存器、
%rax返回、caller/callee-save 之分、enter/leave管理帧、四段过程联接。 - 代码生成:表达式扁平化为三地址 + 模板套用 + 数组边界检查;保持简单,把效率交给优化器。
- SSA:每变量定义一次 + 汇合点 φ;把 def-use 链从 降到 ;标准构造靠支配树 + 迭代支配边界 + 重命名。