
Lec 4二进制计算
Lec 4 二进制计算
TL;DR
- 补码算术统一性:通过取模模数环绕将减法统一为加负数(取反加一),使加减法共享相同的硬件数据通路而无需维护正负零符号分支。
- 加法器关键路径瓶颈:行波进位加法器(RCA)具有 的串行延迟;选择进位加法器(CSelA)通过冗余投机预先计算进位为 0/1 的高位结果,以面积换取延迟折半。
- 超前进位与前缀树优化:抽象出进位生成(Generate)与传播(Propagate)算子,利用算子结合律构建 深度前缀计算树(CLA / Kogge-Stone),实现进位链对数级收敛。
本讲导览
- 二进制运算
- 加法器实现优化
二进制表示与算术
补码表示法
看一下例子
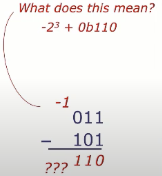
当发送 overflow 时候,通用的做法就是忽略额外 bit。可以看成是环绕的,如下图,
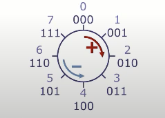
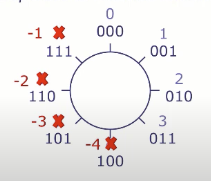
如果只是用最高位作为符号位,其他用无符号的方式表示数字大小,将会导致(+0, -0)都表示为 0,电路在对 0 进行加减法时候就会发现这相当不一样,也会变的很复杂。因此没有采用。
补码表示法(Two's Complement Encoding),环绕图中获取编码灵感。
补码表示的算术
取反
先取反,再加一。 原理:
- -A + A = 0 = -1 + 1, 接着移项得到
- -A = (-1 - A) + 1
- 其中-1 是 0b111...1
- -1 - A 就是将 A 所有比特取反
减法运算
可以很简单的写成 A + (-B)
示例
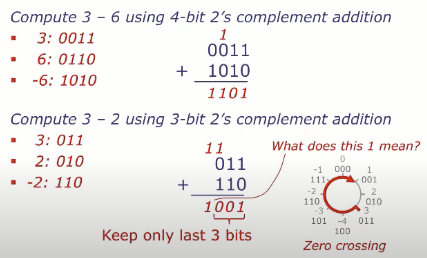
第二个例子中发生了 overflow, 这意味着发生了, zero crossing 导致的高位变化(符号变化), 这是没有意义的,需要忽略,只用剩下的低位来表示结果。
加法器实现优化
硬件设计的算法权衡:同一个功能,可以用很多种不同的实现方法,而且这些方法在速度(delay)、面积(area)、功耗(power)上差异很大。选一个合适的算法,是优化硬件设计(性能、面积、功耗)的关键。如果你一开始就选了一个很低效的算法,后面的综合工具/优化工具也救不了你。如果你用一个 O(n²) 的笨方法解决问题,不管编译器怎么优化,你还是慢。
行波加法器
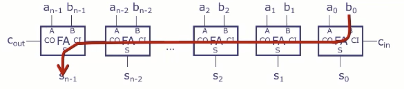
在加法器中,最坏情况下的路径是从最低位(LSB)一路向最高位(MSB)传播进位,比如在将 11...111 和 00...001 相加时。此时的总延迟 是 ,其中 是一个进位到下一个进位的延迟,而 是进位到求和位的延迟。整体延迟是 量级,也就是说,加法器的延迟随着操作数的位数 n 线性增长。
选择进位加法器
选择进位加法器(Carry-Select Adder)权衡面积和速度
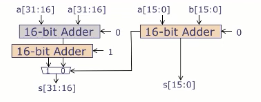
可以将高半部分的加法器复制两份,一份假设进位输入为 0,另一份假设进位输入为 1。然后根据低半部分的加法器产生的进位输出来选择正确的高半部分结果。其传播延迟为。如果使用 16 位的串行进位加法器,这种方法大约可以将 32 位串行进位加法器的延迟减少一半。如果继续递归应用这种策略(例如,用 8 位的 carry-select 加法器来构建 16 位加法器,以此类推),则最终加法器的延迟可以达到 O()的量级
缺点: 需要比行波加法器花费更大的面积,且位宽大多路复用器显著增加了延迟。
加速进位加法器(超前进位)
加速进位加法器(Carry-Lookahead Adder ,CLA)
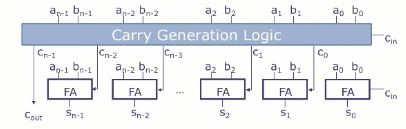
Carry-Lookahead Adders (CLAs) 通过把串行的进位计算链变成树状结构,在 延迟内计算所有进位。核心思路:先把“进位如何产生”抽象成两个可结合的信号,再用树结构并行求出所有进位。
第一步:改写全加器——生成(G)与传播(P)
把全加器的进位输出重写为两项:
- 生成位 :当前位自己就产生进位,无需等待 。
- 传播位 :当前位会把收到的 原样传出去。
- 注意 本可取 (不改变 真值表),但选 XOR 是为了顺便复用它来算和:。
直觉:一个模块产生进位,要么是它自己生成(G),要么是它传播了上一级来的进位(P·C_in)。
第二步:合并相邻模块——G、P 可结合
把高位块 H 和低位块 L 看成一个更大的块,则这个块整体的生成/传播为:
含义:整块要产生进位 = H 自己产生,或 L 产生且被 H 传播;整块要传播进位 = L 和 H 都传播。
关键: 的这个合并运算是可结合的,所以可以像求前缀和一样用树自底向上计算任意宽度块的 。对 位加法器,这棵 GP 树有 个 GP 模块,延迟 。
第三步:自顶向下分发进位(C 模块)
有了各块的 ,再从最低位进位 出发,沿树自顶向下求每个全加器的进位:给定送入某块的 ,
- 低半部分的进位输入 = (直接传下去);
- 高半部分的进位输入 = 。
这一步同样是 。
结果
向上算 GP、向下分发进位各 ,最后每位再做一次 (一个 XOR 延迟)。因此整个加法器延迟为 ,相比行波加法器的 是巨大提升。此时全加器内部的 电路已不再需要,可删去。
这种 generate-propagate 策略是目前最快加法器的基础,进一步可了解 Kogge-Stone 加法器。
核心机制思考与底层洞察
加法运算在形式逻辑上看似简单,但在 VLSI 物理实现中,它是理解硬件并发与拓扑权衡的终极试金石:
- 线性递归向并行前缀算子的数学跃迁:
- 行波进位本质上是一阶线性差分方程 ,串行求解必然导致 延迟。
- 超前进位(CLA)与其工业进阶版(Brent-Kung、Kogge-Stone、Han-Carlson)的核心思想,是将进位传递抽象为半群代数系统上的前缀扫描(Parallel Prefix Scan)。通过定义满足结合律的算子 ,进位求解被彻底重构为平衡二叉树,使逻辑门级深度压缩至 。
- 硅片物理实体的三维权衡(PPA 与布线拥塞):
- RCA(行波):逻辑级数最多(),但版图面积最小(),且仅需最近邻单轨金属连线,在 8 位或低频嵌入式场景中仍然最具性价比。
- CSelA(选择进位):利用典型的空间换时间(Spatial Speculation)冗余复制高位加法器,以几乎翻倍的静态面积换取延迟减半。
- Kogge-Stone / CLA(超前与并行前缀):虽然理论上具有最优的对数逻辑级数,但在深亚微米工艺下,树状网络引入了密集的跨位长导线与极高的扇出负载(Fan-out),导致线网寄生电阻电容(RC Delay)反超逻辑门延迟,甚至引发严重的布线拥塞(Routing Congestion)。现代高性能体系结构设计从来没有单纯的“算法胜出”,而是必须在逻辑层数、门单元面积与物理布线密度三者构成的帕累托前沿面上寻找动态折中。 :::