
Lec 15流水线基础
Lec 15 流水线基础
TL;DR
- 性能铁律与并发重叠:根据铁律(Time = IC × CPI × Clock Period),流水线通过将组合逻辑切分为多级寄存器阶段,在轻微增加延迟的代价下大幅提升吞吐量。
- 良构流水线(k-Pipeline)规范:要求所有从输入到输出的路径严格穿过相同数量(k 个)的寄存器,通过拓扑剖分法避免时序混淆与数据竞争。
- 经典五级流水线架构:将处理器解耦为取指(IF)、译码(DEC)、执行(EXE)、访存(MEM)与写回(WB),为后续解决数据与控制冒险奠定骨架。
性能度量:延迟与吞吐量权衡
这节 lec 我们开始新的内容,流水线技术(pipelining),可以帮助提高我们的电路性能。在设计系统时有两个指标比较重要,一个是延迟,一个是吞吐量。
- 延迟(latency):从输入进入系统到相关的输出被制造出来所需的时间。
- 吞吐量(throughput): at what rate can we produce valid inputs or outputs?
比如,安全气囊展开系统应优先优化延迟,而通用处理器则应主要优化吞吐量,其目标是每秒执行大量的计算。
本讲导览
- 流水线引例
- 流水线阶段划分
- 单周期处理器流水线
引例
常规
下面看组合逻辑性能的例子,假设 F、G 和 H 的传播延迟为 15,20,25ns 以下组合逻辑电路: 延迟 = , 吞吐量 = 1 /
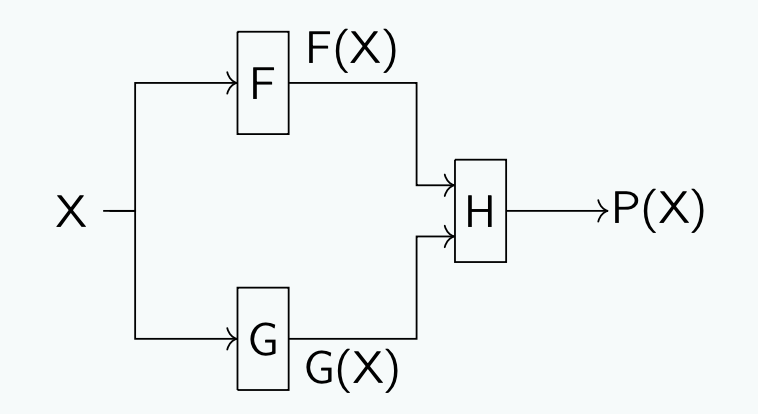
问题是,硬件资源没有被充分利用。整个电路的传播延迟是 tPD= 45ns,吞吐量是 1/45 当某个输入 X 到来时,F 和 G 很快就完成了工作(比如在前 20ns), 然后 H 在后面 25ns 进行计算。
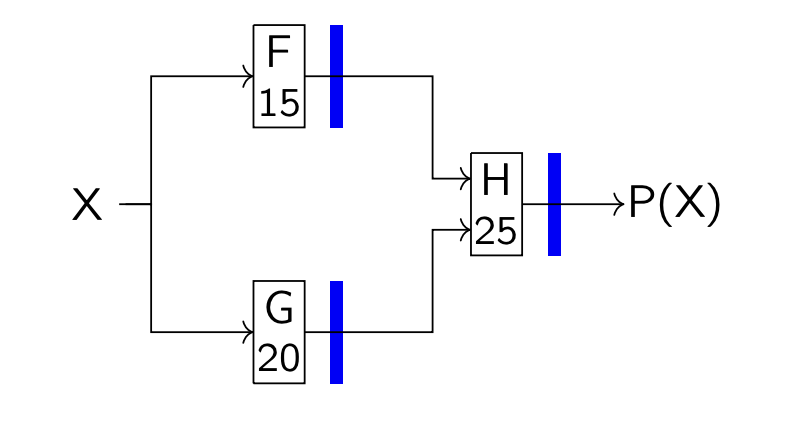
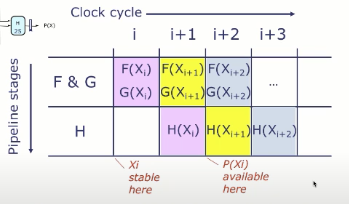
解决方案: 使用寄存器引入流水线(在图中蓝色标记处加入寄存器以保存中间结果)。现在,F 和 G 可以同时处理输入 ,而 H 正在对 进行计算。我们创建了一个两阶段流水线:如果在时钟周期 j 时有有效的输入 X,则在时钟周期 j+2 时 P(X) 有效。该例子中,假设我们使用的是理想寄存器()。
此时限制时钟周期的因素是最慢的电路部分,也就是 H 模块的工作。因此,我们可以采用 25 纳秒的时钟周期来满足时序要求,这样虽然总延迟变成了 50 纳秒(略微变差),但吞吐量提高到了 1/25(显著提升)。
一种分析流水线的行为可以用流水线图表示。
[!IMPORTANT]
一个 k 阶流水线是一个无环电路,在从输入到输出的每条路径上都包含 k 个寄存器(组合电路就是一个 0 阶流水线)
在结构设计中,我们默认每个流水线阶段的寄存器放在其输出端。流水线的时钟周期需要涵盖最长的”寄存器到寄存器路径“的延迟,基于此结构,我们可以推导出 k 级流水线的延迟和吞吐量:
- 延迟= k ·
- 吞吐量 = 1 /
病态
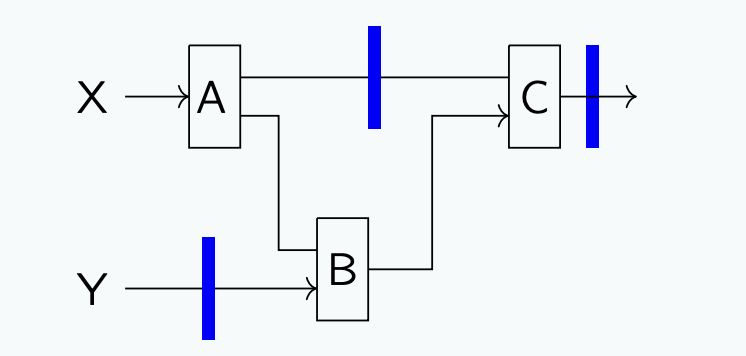
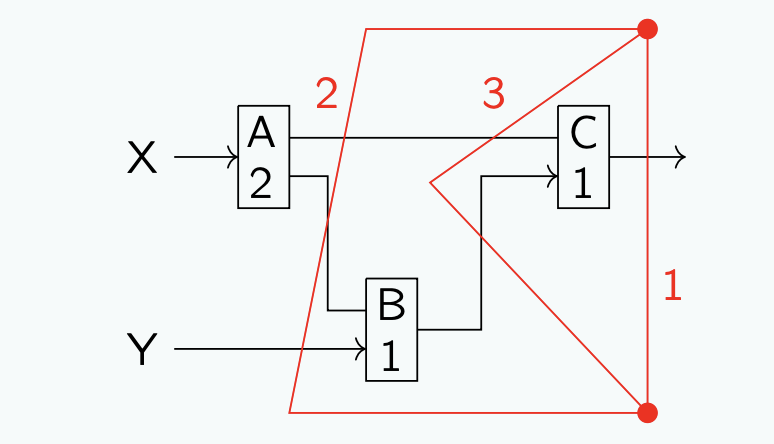
该电路的问题在于,从 X 出发经 A 和 C 的路径,以及从 Y 出发经 B 和 C 的路径,各自都经过 2 个寄存器。但 A-B-C 路径仅包含一个寄存器,这将导致不同时钟周期内的计算结果被混淆!具体来说,我们需要注意 A()和同时被输入到 B 的情况,这并不会发生在定义良好的 K 阶流水线
流水线划分
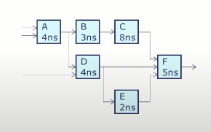
现在让我们讨论一个成功的流水线设计方案:
- 在电路中绘制一条穿过每个输出端的直线,并将两端标记为终端点
- 继续在终端点之间绘制新直线,穿过电路中的每个连接,确保每条直线与前一条直线在同一方向上穿过每个连接点。这些直线划分出流水线阶段, 在每个划分线与连接线相交的点添加一个流水线寄存器,将生成一个有效的流水线。
在设计流水线电路时总的策略就是,应优先在最慢的电路部分(也就是“瓶颈”)前后放置寄存器,以提升整体性能
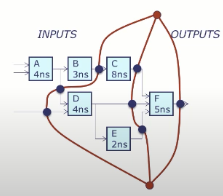
为什么不在左上角的 A 和 B 电路元件之间添加另一条线? 是多少?
Solution: 原因是由于元件 C 的存在,始终至少为 8ns(如果我们假设寄存器具有零建立时间和零传播延迟)。□
回到前面的病态例子。如果我们需要再输出端添加一个寄存器,我们在 C 的输出段添加 1 级流水线,实际上并不会改善延迟或者吞吐量(我们只是对电路进行了时钟同步,将其转换为顺序电路,而未带来性能上的变化)。第二个流水线阶段,可以将组件 A 放在自己的阶段,其他电路元件放在各自的阶段,从而得到 2 ns 的时钟时间。通过将 B 和 C 分成第三个流水线阶段并不会提升性能,因为性能瓶颈仍然是 A。以下是计算结果的表格:
| 延迟 | 吞吐量 | |
|---|---|---|
| 0阶流水线 | 4 | 1/4 |
| 1阶流水线 | 4 | 1/4 |
| 2阶流水线 | 4 | 1/2 |
| 3阶流水线 | 6 | 1/2 |
有以下几点观察:
- 1 阶流水线并不会优化延迟和吞吐量
- 吞吐量是通过打破长路径提高的。
- 随意添加流水线阶段是不可取的,可能只会增加延迟,而不会提高吞吐量
- 有时候为了保持流水线的良构,背对背的寄存器可能是需要的,这是合理的
单周期处理器
性能铁律(Iron Law) :处理器性能 = Time / Program = (指令数 / 程序) · (平均时钟周期 / 指令) · (时间 / 时钟周期)
要降低执行时间,可以采用:
- 降低执行指令数
- 降低每指令的时钟周期数(CPI)
- 时钟周期(也就是增加频率)
如果 CPI = 1, 我们称这个为单周期处理器。当前,执行一个时钟周期所需的时间为时钟周期,该值由任何指令的最长路径决定(因为我们希望指令周期数 CPI 仍为 1),而这样的路径可能相当长。 = 任何指令的最长路径。
OOh, 这样太慢了!
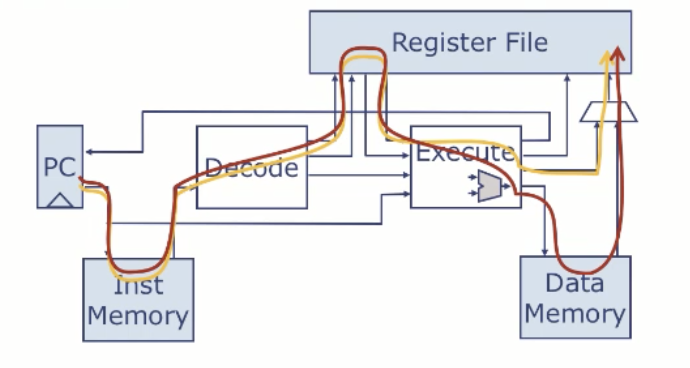
我们将借鉴之前讲座中的一个想法:我们将数据通路划分为多个流水线阶段,这意味着每个指令需要多个时钟周期来执行,但通过指令重叠,我们可以保持吞吐量约为每周期 1 条指令,并显著降低 tCLK
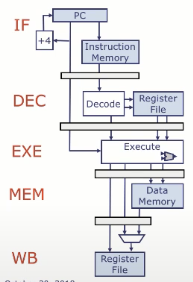
经典的 5 级流水线
- IF(取指阶段): 维护程序计数器(PC),从指令存储器中取出指令,并将其传递给下一个阶段。
- DEC(译码与读寄存器阶段):对指令进行译码,并从寄存器堆中读取源操作数。
- EXE(执行阶段):由 ALU 执行运算操作,例如加法、位移等,计算结果传给下一阶段;
- MEM(访存阶段):若指令是加载(load),则使用执行阶段的结果作为内存地址读取数据;否则直接传递 ALU 结果
- WB(写回阶段):将最终结果写回寄存器堆。
此时,
But,而且我们之前已经知道如何对组合逻辑电路进行流水线设计。但这个过程其实并不像表面上看起来那么简单:
- 处理器有多个状态: PC、寄存器堆和内存。这意味着我们需要更多地考虑现有状态与寄存器堆之间的交互。
- 我们的电路中存在无法立即打破的循环,比如
- 计算下一个 PC
- 将结果写入到寄存器堆的操作
- 不能生成一个良构的流水线
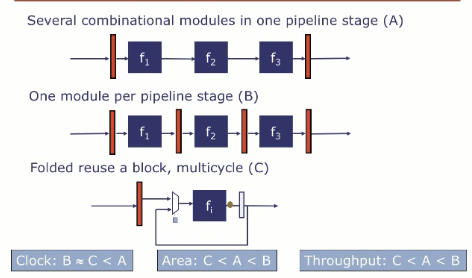
下图重新绘制了单周期处理器,更明确了各个阶段。
[!NOTE]
关于流水线冒险
流水线尝试重叠多条指令的执行,但是一条指令可能取决于上一条指令的结果。如果涉及到数据值,则是数据冒险;而涉及到 PC 则是控制冒险。
我的理解
::: insight
流水线级数提升的收益递减与时序开销墙
初学者常误以为“只要将流水线切得无限细,处理器的吞吐量和主频就能无限提高”。然而在真实物理实现中,存在严格的流水线收益递减与时钟开销墙:
- 寄存器物理时序税:每个流水线阶段的时钟周期并非仅由逻辑门延迟决定,而是包含硬件固有时序开销:。当流水线切分到极细粒度(如 20 级以上)时,寄存器的建立时间、触发器时钟到输出延迟以及全芯片时钟抖动(Clock Skew)在整个周期中的占比甚至会超过有效组合逻辑计算时间,使得主频提升空间迅速收窄。
- 冒险引发的 CPI 恶化:流水线级数越深,分支预测失败带来的气泡惩罚(Branch Penalty)和数据前递(Bypassing)不可化解时的加载停顿(Load Stall)周期数成倍增加。原本接近 1.0 的 CPI 会显著恶化,导致指令吞吐量不升反降。
- 能效与微架构甜点:在 Intel NetBurst(Pentium 4,长达 31 级流水线)遭遇功耗墙之后,现代高性能通用处理器(如 Zen 或 Apple M 系列)普遍将流水线深度回撤并稳定在 12–19 级之间,以此在时钟主频、单核 IPC、分支惩罚与芯片能耗之间取得全局最优平衡。 :::