
Lec 1介绍 & MapReduce
摘要
课件:Introduction (l01.txt);论文:MapReduce (2004)
这是当前课程已收录的第一篇。
Lec 1 介绍 & MapReduce
本课主线
Definition 什么是分布式系统?为什么用?为什么难?
是什么? 分布式系统是一组计算机协同工作,共同提供某种服务。在日常生活中,我们几乎都在使用分布式系统,例如流行 APP(实时通信 WECHAT、IG 等)、大型网站、电话通信系统等。
**为什么用?**分布式系统有如下好处,
- 通过并行处理提高计算能力
- 数据复制增强容错性
- 物理设备的分布适配实际需求(如传感器网络)
- 通过隔离提升系统的安全性。
为什么难? 难在:并发、复杂交互、协调带来的性能瓶颈、以及"部分失败"(一部分坏了、一部分还在跑)。
本课聚焦"分布式基础设施(distributed infrastructure)"——存储 / 通信 / 计算三类抽象,核心目标是对应用隐藏分布式的复杂性。围绕三大主题:
- 容错(fault tolerance):成千上万台机器总有在坏的,要做到高可用(坏了还能用)与可恢复,主要手段是复制(replication)。
- 一致性(consistency):通用基础设施要有"良好定义、可预测"的行为(如
read(x)读到最近一次write(x));但跨副本维持同一状态很难。 - 性能 / 可扩展性(scalability):理想是加 N 台机器得 N 倍吞吐;现实受负载不均、通信开销、瓶颈资源(比如受限于 N 台机器中延迟最长那台的影响)所限。
贯穿全课的根本张力:"容错、一致性、性能 三者互为敌人"
容错要协调(复制数据、确认写入),强一致要通信(查最新值、同步副本),而通信本身又慢又难扩展。于是很多系统牺牲一致性换性能(如允许 read 读不到最新 write)。系统设计就是在这条折中曲线上选点——本课后续每一讲几乎都在讨论某个具体折中。
并不是只有“两极”选择(强一致 or 不一致),而是有很多中间设计点:
| 模式 | 一致性强弱 | 性能高低 | 常见系统 |
|---|---|---|---|
| 强一致性 | 强 | 慢 | Paxos、Raft、Zookeeper |
| 线性一致性 | 比强一致稍弱 | 中等 | Etcd、Spanner |
| 顺序一致性 | 弱 | 高 | Kafka、消息队列 |
| 最终一致性 | 很弱 | 高 | Dynamo、Cassandra、S3 |
| 一致性完全不保证 | 极弱 | 非常高 | 一些本地缓存、CDN、MQTT等 |
MapReduce 的工程逻辑
目标:MapReduce 让非程序员只写 Map/Reduce 两个纯确定性函数,框架负责分发代码、调度、搬数据、容错。
执行四阶段:输入切成 M 片 → Map(每片一任务,产中间 KV)→ Shuffle(按 hash(key) mod R 分到 R 桶)→ Reduce(每桶一任务,产最终输出)。
能线性扩展,因为 Map 之间、Reduce 之间互不干涉。
当年的瓶颈是网络,于是有了三个关键工程优化
-
网络瓶颈:2004 年 1800 台机、根交换机总容量约 100–200 Gb/s,摊到每机仅 ~55 Mb/s;而 shuffle 让每个 Reduce 都要从每个 Map 拉数据,全压在根交换机上。
-
局部性(locality):协调者把 Map 任务调度到输入数据所在的那台 GFS 机器(GFS 与 MR worker 同机),于是 Map 读输入走本地磁盘、零网络;中间数据只跨网一次(Map 本地盘 → Reduce),而非两次。
-
负载均衡 + straggler:任务数 M、R 远多于机器数,谁先做完谁领新任务(快机多做);对最后几个慢任务(straggler,常因硬件故障)启动备份任务,谁先完成用谁。 :::
worker 崩了,协调者只重跑该 worker 的 Map/Reduce 任务,其余不受影响。前提是 Map/Reduce 必须纯确定(无外部状态/文件副作用/随机数/跨任务通信)。重复执行靠确定性(多次 Map 输出相同)+ GFS 的原子 rename(多次 Reduce 写同名文件,最终只一份可见)来兜底。未覆盖的失败:返回错误结果的硬件(MR 假设 fail-stop)、协调者崩溃(基础设计未处理)。
MR 做词频统计的例子
Input1 -> Map -> a,1 b,1
Input2 -> Map ->     b,1
Input3 -> Map -> a,1     c,1
                  |   |   |
                  |   |   -> Reduce -> c,1
                  |   -----> Reduce -> b,2
---------> Reduce -> a,2- 输入数据被预先划分成 M 个分片
- MapReduce 调用
Map()处理每个输入分片,输出中间的<key, value>对- 每个 Map 调用时一个任务
- 当所有 Map 完成后,MR 会将所有相同 key 的 value 聚合起来再调用
Reduce()来处理每个 key - 最终输出是所有 Reduce 的
<key, value>结构
# Word Count 代码示例
# Map(d)
for each word w in document d:
  emit(w, "1")

# Reduce(k, v[])
emit(k, len(v[]))
MR 的扩展性很好:
- 有 N 台“工作机”,可能就能得到 N 倍的吞吐量。
- 所有
Map()可以并行运行(彼此无依赖) - 所有
Reduce()也可以并行运行 - 增加机器数量 → 提高处理速度,这是非常理想的。
MR 自动隐藏的复杂性包括:
- 把 map 和 reduce 函数代码发送给工作机
- 跟踪哪些任务已经完成
- 将中间结果从 Map 发送到 Reduce(“shuffle” 阶段)
- 负载均衡
- 故障机器的容错恢复
为获得这些优点,MapReduce 做出了一些限制:
- 没有任务之间的交互或状态(除了通过中间输出)
- 数据流模式被限制为 map → shuffle → reduce
- 不支持实时处理或流式处理
一些细节(论文的图 1),输入输出存在 GFS(Google File System)中**:**
- MapReduce 需要高并行的输入输出
- GFS 把文件划分为 64MB 块,分布在多个服务器和磁盘上
- Map 任务并行读取
- Reduce 并行写入结果
- GFS 会对每个块进行 2 或 3 份复制,实现容错
- GFS 是 MapReduce 的一个核心优势
"协调器"管理作业的所有步骤。
- 协调器将 Map 任务分配给工作节点,直到所有 Map 任务完成。
- Map 任务将中间数据写入本地磁盘,并按
hash(key) mod R将输出分割成每个 Reduce 任务的文件。
- Map 任务将中间数据写入本地磁盘,并按
- 当所有 Map 任务完成后,协调器分配 Reduce 任务。
- 每个 Reduce 任务处理一个哈希桶。
- Reduce 任务从所有 Map 中取回自己对应的那一桶中间数据
- 按键排序,并对每个 key 调用 Reduce()
- 每个 Reduce 任务将结果写入 GFS 的一个输出文件
性能瓶颈在哪?
Solution: 瓶颈可能是:
- CPU?
- 内存?
- 磁盘?
- 网络?
在 2004 年,论文指出网络速度是瓶颈。MapReduce 在网络上传输了什么?
- Map 从 GFS 读取输入
- Reduce 从 Map 工作机获取中间结果(shuffle 阶段) 这部分数据有时和输入一样大(比如排序)
- Reduce 将结果写回 GFS
在交换机拓扑中,大约有一半的数据要经过根交换机(root switch),论文中的根交换机带宽:100~200 Gbps,支持约 1800 台机器 → 每台机器平均只有 55 Mbps,远低于磁盘或内存速度。
MapReduce 如何减少网络开销?
Solution:
- Map 尽量运行在本地拥有输入数据的 GFS 节点上 → 避免读取时通过网络传输 → 所有机器同时是 GFS 节点和 MR 工作机
- 中间数据仅通过网络传输一次
- Map 将中间结果写入本地磁盘
- Reduce 从对应 Map 的磁盘通过网络拉取数据 (如果把中间结果写入 GFS,会增加两次网络传输)
- 中间数据按哈希分桶(不是每个 key 一个 Reduce)
- 每个 Reduce 处理一个桶,里面包含多个 key
- 这样可以批量传输,提高网络效率
如何保证负载均衡?
Solution:任务数量远多于工作机器数量。 为每个工作节点分配更多的任务。协调器会将新的任务分配给已经完成任务的工作节点,因此,较快的服务器将承担更多任务,较慢的服务器则承担较少任务,减少对总时间的影响
MapReduce 如何处理容错?
我们希望把影响降到最低。只会重新执行失败的 Map 和 Reduce 任务,不需要重头运行整个作业。
- 工作节点崩溃, 我们希望应用程序开发者看不到故障(由 MR 自动处理)
- 如果在 Map 阶段
- 协调者会注意到工作节点没有响应
- 协调器知道它执行过哪些 Map 任务
- 这些任务的中间输出丢失,必须重新生成
- 协调器会让其他工作机重新运行这些任务
- 如果所有 Reduce 已经取走了中间数据,则可以省略重跑
- 如果在执行 Reduce 阶段
- 已完成的任务没问题——输出存储在 GFS,并且有副本
- 协调器会在其他机器上重新运行未完成的任务
- 如果在 Map 阶段
- 协调者崩溃(这本质上不能叫容错)
- 论文中没展开,但显然会比较麻烦。
其他失败/问题:
- 协调器把同一个 Map 任务分配给两台 worker:可能是协调器误认为某个节点死了。它会通知 Reduce 机器只从其中一台获取数据。
- 如果协调器将相同的 Reduce 任务分配给两个工作节点:它们会尝试写入相同的输出文件。GFS 的原子
rename可以防止这种情况;只有一个完整的文件会被显示。 - 如果某个工作节点非常慢("拖后腿"):可能是硬件不稳定, 协调器会启动一个新的副本来执行最后几个任务。
- 如果某个工作节点计算出错误的输出(硬件或软件故障):无能为力!MapReduce 假设"故障停止"的 CPU 和软件。
性能的限制因素是什么?
我们关心的是,这些限制是我们优化的目标。是 CPU?内存?磁盘?网络? 2004 年,作者们的性能限制主要是网络速度。 MapReduce 在网络上发送哪些数据?
- Map 任务从 GFS 读取输入。
- Reduce 任务读取 Map 的中间输出,通常和输入数据一样大,例如排序时。
- Reduce 任务将输出文件写入 GFS
实际部署是两级树形交换机网络,在 MapReduce 的 all-to-all 洗牌中,一半的流量通过根交换机。论文中的根交换机速度为 100 到 200 Gbps,总带宽为:1800 台机器,约为 55 Mbps/机器。这个速度较小:远低于磁盘或内存的速度。
MR 如何最小化网络使用?
- 协调器尽量让每个 Map 任务在存储其输入的 GFS 服务器上运行。所有计算机同时运行 GFS 和 MapReduce 工作任务。所以 Map 输入通常从本地磁盘读取,而非通过网络。
- 中间数据只通过网络传输一次。Map 工作节点将数据写入本地磁盘,Reduce 工作节点从 Map 节点的磁盘上通过网络读取数据。(如果存储在 GFS 中,至少需要两次网络传输。)
- 中间数据按哈希划分为多个文件,包含多个键。Reduce 任务的单位是哈希桶(而不仅仅是一个键)。大的网络传输更加高效。
Mapreduce 的现状?
Solution:MR 影响巨大,被运用在(Hadoop,Spark 等),可能现在 Google 已经不再使用了,被 Flume/FlumeJava 取代(见 Chambers 等人论文);GFS 也被 Colossus 和 BigTable 取代
本讲小结
MapReduce 的出现让集群计算变得流行, 虽然并不是最高效或者最灵活的,但是可扩展性好易于编程的特点——隐藏了失效和数据移动的细节。我们后续会学习更先进的继任者,RDD 等等
论文阅读: MapReduce
本讲导览
Mapreduce 是一种编程模型,是一种处理和产生大数据集的实现方式。 使用者通过 map 函数通过处理一个 key/value 对来产生一组中间 key/value 对,然后 reduce 函数将归并(merge)所有的与同一个中间 key 关联的中间 value。很多现实世界任务能够通过这个模型进行表达。
使用这种函数式编程风格编写的程序会自动并行化,并在一个大型商用计算机集群上执行。运行时系统负责输入数据的分区、程序在机器集群上的调度、机器故障的处理以及所需的机器间通信管理。这使得没有并行和分布式系统经验的程序员也能轻松利用大型分布式系统的资源。
1. 引言
背景:过去五年,作者与 Google 团队开发了数百个处理海量数据的计算任务,如网页抓取文档、请求日志等,生成倒排索引、页面结构分析、主机抓取统计等衍生数据。这些计算逻辑简单,但面临挑战:输入数据规模庞大时,如何在成百上千台机器上并行化计算、分发数据并处理故障,需编写大量复杂代码。
解决方案:受 Lisp 等函数式语言启发,提出一种新抽象模型,将计算抽象为map(处理每条输入记录生成中间键值对)和reduce(合并相同键的值)两个操作,隐藏并行化、容错、数据分发等底层细节。通过函数式编程模型和重新执行机制,实现高效并行与容错。
核心贡献:设计了一个简单强大的接口,可自动并行化大规模计算,并在商用 PC 集群中高效运行。论文结构:
- 第 2 节:编程模型与示例
- 第 3 节:集群环境下的实现
- 第 4 节:关键优化方法
- 第 5 节:性能评估
- 第 6 节:在索引系统中的实际应用
2. 编程模型
计算的输入是一组 K/V 对,输出是一组新的 K/V 对。MapReduce 库的用户通过两个函数 Map 和 Reduce 来表达计算。用户编写的 Map 函数输入为 一个 K / V 对,并输出 一组中间 K/V 对。MapReduce 库将所有与同一中间键 关联的中间值分组在一起,并将它们传递给 Reduce 函数。
Reduce 函数 输入是 一个中间键 及其对应的一组值,输出是 将这些值合并形成的一个可能较小的值集。通常,每次 Reduce 调用只生成零个或一个输出值。中间值通过 迭代器 传递给用户的 reduce 函数,这样可以处理过大无法容纳在内存中的值列表。
2.1 示例
统计每个单词出现的次数。
map(String key, String value):
	// key: document name
	// value: document contents
	for each word w in value:
		EmitIntermediate(w, "1");

reduce(String key, Interator values):
	// key: a word
	// values: a list of contents
	int result = 0;
	for each v in values:
		result += ParseInt(v);
	Emit(AsString(result));
map 函数会输出每个单词及其对应的出现次数(这个例子中,计数为“1”)。Reduce 函数会将每个单词的所有计数相加。
此外,用户需要编写代码,将输入和输出文件的名称以及可选的调整参数填充到 mapreduce 规范对象中。然后用户调用 MapReduce 函数,并将规范对象传递给它。用户代码与 MR 库链接在一起。
2.2 类型
尽管前面的伪代码是以字符串输入和输出为基础编写的,实际上用户提供的 map 和 reduce 函数具有相关类型:
map 		(k1, v1) -> list(k2, v2)
reduce	(k2, list(v2)) -> list(v2)
即输入键和值来自于不同的领域,而输出键和值来自于另一个领域。此外,中间键和值与输出键和值来自相同的领域。
2.3 更多的例子
- 分布式 grep:map 函数如果匹配上模式,就将该行发出(emit);reduce 就只是将中间数据复制到输出。
- 统计 URL 访问频率:map 函数处理网页请求日志并输出<URL, 1> ;reduce 将同一 URL 的所有值相加并发出<URL, 总计数>对
- Web 反向链接图: map 函数对于在 URL 为 source 的页面中找到的指向 target URL 的每个链接,输出<target, source>对;Reduce 则将所有的 source 进行拼接,形成<target, list(source)>
- 每个主机的词向量:一个词向量(term vector)是用来概括文档或一组文档中最重要的单词的,它的形式是一个列表,列表中每个元素是一个 ⟨word, frequency⟩ 。在 Map 阶段,对于每一个输入的文档,map 函数会输出一个 < hostname, term vector>,其中的主机名是从文档中的 URL 提取出来的; 在 Reduce 阶段会接收到所有属于 同一个主机 的、不同文档的词向量, Reduce 函数会将这些词向量合并,也就是把所有文档中同一个单词的频率加起来。对于出现次数非常少的单词会丢弃(过滤掉)
- 倒排索引(Inverted Index): 你可以把倒排索引理解为一个“词典”,它告诉我们每个词出现在哪些文档里。 map 函数将每个文档 document 解析,并且生成了一组<word, document ID>,然后 reduce 函数接受到上面的键值对,并将对应的 ducument ID 进行排序,生成<word, list(document ID)>,所有的输出就构成了简单的倒排索引
- 分布式排序:map 函数从每条 record 中提取键,并发出⟨ key,record ⟩对。reduce 函数不更改任何对,直接发出。这种计算依赖于第 4.1 节中描述的分区功能和第 4.2 节中描述的排序特性。
3. 实现
关于 mapreduce 的接口有很多不同的实现,比如有的适合小内存机器,有的大规模 NUMA 的多处理器,还有适用于更大的联网机器。配置的环境:
- 机器通常是双处理器 x86 处理器,运行 Linux,每台机器配备 2-4 GB 内存。
- 使用的是普通网络硬件——机器级通常为 100 Mbps 或 1 Gbps,但整体分割带宽平均远低于此
- 集群由数百或数千台机器组成,因此机器故障较为常见
- 存储通过连接到各机器的廉价 IDE 硬盘提供,使用内部开发的分布式文件系统来管理数据。该文件系统利用数据复制来提高可用性和可靠性,以应对不可靠的硬件。
- 用户通过调度系统提交作业。每个作业包含一组任务,调度器将这些任务映射到集群中可用的机器上。
3.1 执行概述
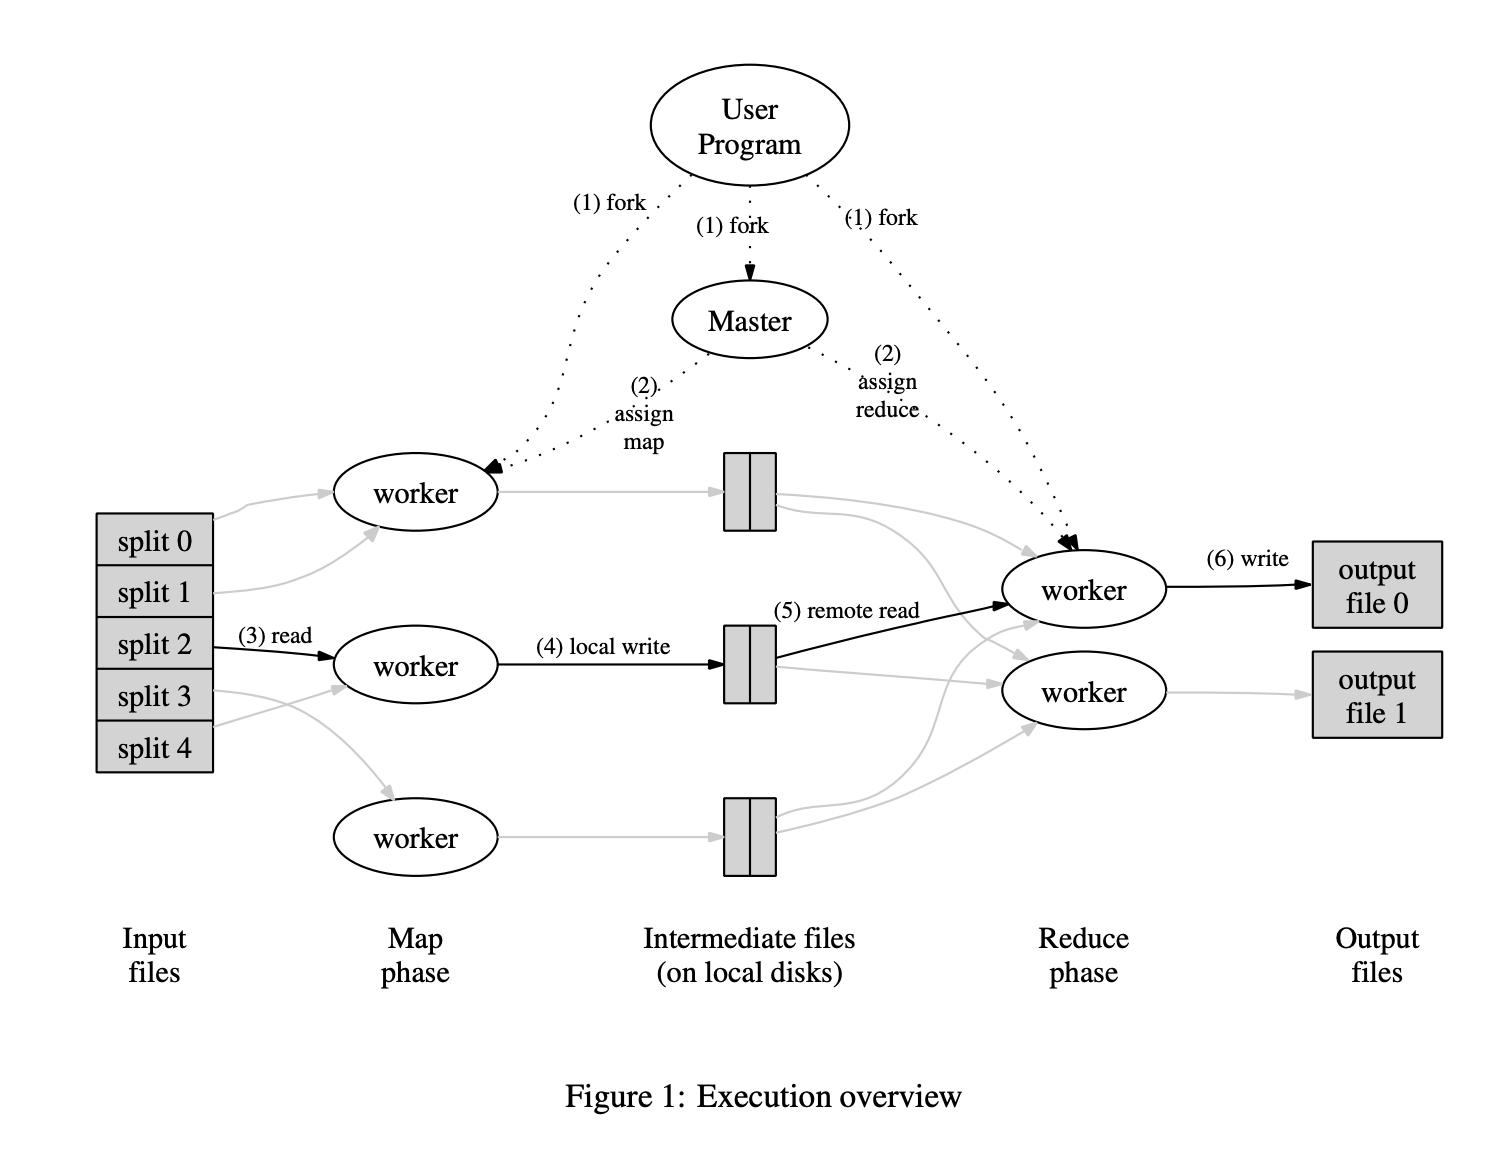
框架通过自动将输入数据成 M 个块,并在由不同机器并行处理 Map 调用。中间结果是 KV 对, 框架用分区函数(如 hash(key) mod R)把 key 空间 分成 R 个分区。也就是说 Reduce 调用只处理部分 Key 空间。
当用户程序调用 MapReduce 函数时,执行序列如下(图 1 中的数字标签对应以下步骤):
- 用户程序中的 MapReduce 库首先将输入文件分成 M 个块,每块通常为 16-64 MB(用户可以通过可选参数控制)。然后在集群中启动多份程序。
- 其中一个程序副本是特殊的——为主节点,其余为工作节点,由主节点分配任务。主节点分配 M 个 Map 任务和 R 个 Reduce 任务,并选择空闲的工作节点分配一个 M 或者一个 R 任务。
- 被分配 Map 任务的工作节点读取相应输入块的内容,将 K/V 对解析并传递给用户定义的 Map 函数。Map 函数生成的中间键/值对放在内存缓冲区中。
- 缓冲区的 KV 对会周期性地写入本地磁盘,并通过分区函数分为 R 个区域。这些对的存储位置反馈给主节点,由主节点将位置转发给 Reduce 工作节点。
- 当主节点通知 Reduce 工作节点这些位置时,Reduce 工作节点通过 RPC 从 Map 工作节点的本地磁盘读取数据到内存缓冲区。读取完所有中间数据后,将其按中间 Key 排序,以将相同键的值分组在一起。如果中间数据过大,使用外部排序。
- Reduce 工作节点遍历排序后的中间数据,对于每个唯一的中间 Key,传递该键和相应的值集合给用户的 Reduce 函数。Reduce 函数的输出被追加到对应 Reduce 分区的最终输出文件中。
- 当所有 Map 和 Reduce 任务完成后,主节点唤醒用户程序,此时用户程序中的 MapReduce 调用返回用户代码
执行成功后,mapreduce 的输出在 R 个输出文件中(每个 Reduce 任务一个,文件名由用户指定)。通常,用户无需将这些 R 个输出文件合并为一个文件——他们常将这些文件作为另一个 MapReduce 调用的输入,或在另一个能够处理多文件输入的分布式应用中使用。
3.2 主节点数据结构
主节点维护多个数据结构。对于每个 Map 和 Reduce 任务,存储其状态(空闲、进行中或已完成)以及工作机器的标识。
主节点作为中间文件区域位置从 Map 任务传递到 Reduce 任务的中枢。因此,对于每个已完成的 Map 任务,主节点存储由该任务生成的 R 个中间文件区域的位置和大小信息。随着 Map 任务完成,位置和大小信息逐步更新并推送给进行中的 Reduce 任务的工作节点。
3.3 容错
由于 MapReduce 库旨在使用数百或数千台机器处理大量数据,因此该库必须能够优雅地容忍机器故障。
3.3.1 工作节点失效
主节点定期 ping 工作节点。如果在一定时间内未收到工作节点的响应,主节点会将该工作节点标记为失效。该节点完成的任何 map 任务会被重置回初始的空闲状态,因此可以在其他工作节点上重新调度。类似地,在失效工作节点上进行中的任何 map 任务或 reduce 任务也会被重置为空闲状态并可以重新调度。
对于完成的 map 任务,在失效后需要重新执行,因为其输出存储在失效机器的本地磁盘上,因此无法访问。而完成的 reduce 任务不需要重新执行,因为它们的输出存储在全局文件系统中。
当某个 map 任务首先由工作节点 A 执行,然后由于 A 失效改由工作节点 B 执行时,所有正在执行 reduce 任务的工作节点都会收到重新执行的通知。任何尚未从工作节点 A 读取数据的 reduce 任务会从工作节点 B 读取数据。
MapReduce 对大规模的工作节点失效具有较强的容错性。例如,在某次 MapReduce 操作中,运行中的集群在进行网络维护时,导致每次有 80 台机器暂时无法连接,且持续了几分钟。MapReduce 的主节点仅重新执行了这些不可连接的工作节点上的任务,并继续保持进度,最终顺利完成了 MapReduce 操作。
3.3.2 主节点失效
可以让 Master 周期性地对上述 Master 数据结构进行 checkpoint 保存。如果 Master 任务失败,可以从最近的检查点状态启动一个新的副本。然而,由于 Master 是唯一的,其失败的可能性较低,因此目前的实现是在 Master 失败时中止 MapReduce 计算。如果客户端希望,可以检查此情况并重试 MapReduce 操作。
3.3.3 在故障情况下的语义
当用户提供的 map、reduce 操作是确定的,对于相同的输入而言,我们分布式实现生成的结果应该是相同的。
我们依赖 map 和 reduce 任务输出的原子提交来实现这一特性。每个进行中的任务会将输出写入专用的临时文件。reduce 任务生成一个这样的文件,而 map 任务生成 R 个这样的文件(每个 reduce 任务一个文件)。当 map 任务完成时,工作节点向 Master 发送一条消息,并在消息中包含 R 个临时文件的名称。如果 Master 接收到一个已完成的 map 任务的完成消息,它会忽略该消息。否则,它会将这 R 个文件的名称记录在 Master 的数据结构中。
当一个 reduce 任务完成时,reduce 工作节点会 rename 它的临时文件到最终文件,如果同样的 reduce 任务被多个机器执行,就会产生多个 rename 调用来完成该任务,我们依赖底层文件系统提供的原子重命名操作,以确保最终的文件系统状态仅包含由一个 reduce 任务执行生成的数据。
当大多数的 map 和 reduce 操作符是确定性的时,MapReduce 的语义等同于顺序执行。这使得程序员能够轻松地推断程序的行为,因为它与顺序执行的行为一致。在存在非确定性操作符的情况下,特定 reduce 任务 R1 的输出与非确定性程序顺序执行时 R1 的输出相等。然而,不同的 reduce 任务 R2 的输出可能对应于非确定性程序的另一种顺序执行的 R2 输出
例如, map 任务 M 和 reduce 任务和,令表示提交而来的的执行。较弱的语言产生的原因是可能读取了 M 的一次执行的输出,而可能读取了 M 的另一次执行的输出。 (M 可能被执行多次,那么不同的 Reduce 任务可能会读取不同次 M 的输出结果)
3.4 数据的局部性
网络带宽在计算环境中是一个相对重要的资源,输入数据由 google 文件系统(GFS)管理,存储在集群中的各个本地磁盘上,c 将每个文件划分成 64MB,并在不同的机器上存储每个块的多个副本(通常为 3 个副本)。MapReduce 的主节点会考虑输入文件的位置信息,并尝试将 map 任务调度到包含相应输入数据副本的机器上。如果无法调度在该机器上,则尝试将 map 任务调度到靠近该数据副本的机器上(例如,在与包含数据的机器同一网络交换机的工作机器上)。当在集群中大量运行 MapReduce 操作时,大多数输入数据都是本地读取的,不会消耗网络带宽。
3.5 任务粒度
我们将 map 阶段划分为 M 个小任务,将 reduce 阶段划分为 R 个小任务。理想情况下,M 和 R 应该远远大于工作机器的数量。【想一下有什么好处?】
在我们的实现中,M 和 R 的数量有实际限制。【限制点在哪?】 提示:因为主节点需要做出 O(M + R)次调度决策,并在内存中维护 O(M ∗ R)的状态,然而,内存使用的常数因子很小:O(M ∗ R)部分的状态数据大约是每对 map 任务/ reduce 任务占用一个字节的数据。【为啥 1 个字节能搞定?为啥要这么省】
[!NOTE]
每个 Map 任务会产生 R 个中间分区文件,所以会有 O(M * R)的状态
M = 10,000 个 map
R = 1,000 个 reduce
每对占 1 字节 → 需要 10,000 × 1,000 ≈ 10MB
此外,每个 Reduce 任务最终会生成一个单独的输出文件,R 太大话,文件系统也会随之压力大。所以实现中用主要 M 来划分任务,将输入划分成多个 16 MB 到 64 MB 小任务(GFS chunk 大小是 64MB),并使 R 是我们预计使用的工作机器数量的一个小倍数。我们常常在 M = 200,000 和 R = 5,000 的情况下进行 MapReduce 计算,使用 2,000 台工作机器。
3.6 备份任务
造成 MR 操作总耗时延长的常见原因之一是"滞后者": 机器由于某些原因在计算的最后几个 Map 或 Reduce 任务花费异常长的时间。
在 MapReduce 操作中,一台机器在计算的最后几个 map 或 reduce 任务中花费异常长的时间造成 stragglers 的原因有很多,滞后者可能由于各种原因产生。例如,一台硬盘有问题的机器可能会遇到频繁的可纠正错误,从而将其读性能从 30 MB/s 降到 1 MB/s。集群调度系统可能在该机器上安排了其他任务,导致由于 CPU、内存、本地磁盘或网络带宽的竞争,该机器执行 MapReduce 代码的速度变慢。(我们最近遇到的一个问题是机器初始化代码中的错误,导致处理器缓存被禁用:受影响的机器计算速度降低了超过 100 倍。)
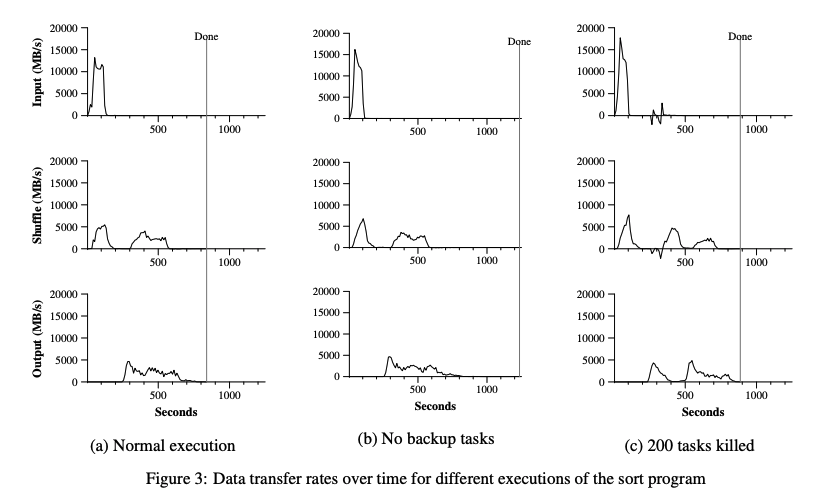
我们有一个通用机制来减轻滞后者问题。当一个 MapReduce 操作接近完成时,主节点会为剩下的进行中的任务调度备份执行。任务在主执行或备份执行中的任一完成时即被标记为完成。我们调优了这一机制,使其通常仅增加少量的计算资源消耗,通常不超过几个百分点。我们发现,这显著减少了完成大型 MapReduce 操作所需的时间。例如,如果禁用备份任务机制,5.3 节描述的排序程序的完成时间会增加 44%。
4. 扩展
虽然前面的工作机制已经能够满足大部分需求,但我们发现有些扩展也挺有用处。
4.1 数据分区函数
MapReduce 的用户可以指定他们所需的 reduce 任务/输出文件数量(R)。数据会根据中间键上的分区函数分配到这些任务中。默认分区函数使用哈希(例如,“hash(key) mod R”),这通常会产生较为均衡的分区。然而,在某些情况下,将数据按键的其他函数进行分区会更有用。例如,有时输出键是 URL,我们希望同一主机的所有条目最终存储在同一输出文件中。为了支持这种情况,MapReduce 库的用户可以提供一个特殊的分区函数。例如,使用“hash(Hostname(urlkey)) mod R”作为分区函数会使同一主机的所有 URL 存储在同一输出文件中。
4.2 排序保证
我们保证在一个给定的分区内,中间键/值对按键递增的顺序进行处理。这种排序保证使得每个分区生成一个排序输出文件变得简单,这在输出文件格式需要支持按键高效随机访问查找时非常有用,或者当用户希望数据是按排序的形式更方便时也很有用。
4.3 Combiner 函数
在某些情况下,每个 map 任务生成的中间键会有显著的重复,并且用户指定的 Reduce 函数是交换和结合律的。例如,在 2.1 节的词计数示例中,由于词频通常符合 Zipf's Law(幂律分布,少数元素出现频率极高,而大多数元素出现频率极低),每个 map 任务将生成成百上千条形式为<the, 1>的记录。所有这些计数都会通过网络发送到单个 reduce 任务中,然后通过 Reduce 函数加和得到一个数值。我们允许用户指定一个可选的合并器(Combiner)函数,用于在数据发送到网络之前进行部分合并。
Combiner 函数在执行 map 任务的每台机器上执行。通常情况下,实现 Combiner 函数和 reduce 函数可以使用相同代码。reduce 函数和 combiner 函数之间唯一的区别在于 MapReduce 库如何处理函数的输出。reduce 函数的输出写入最终的输出文件,而 combiner 函数的输出写入一个将发送到 reduce 任务的中间文件。
4.4 输入和输出类型
MapReduce 库支持以多种格式读取输入数据。例如,文本模式输入将每行视为一个键/值对:键是文件中的偏移量,值是该行的内容。另一种常见的格式存储按键排序的一系列键/值对。每种输入类型的实现都知道如何将其划分为有意义的范围,以便作为独立的 map 任务处理(例如,文本模式的范围划分确保仅在行边界处分割范围)。用户可以通过提供一个简单的Reader接口实现新输入类型的支持,尽管大多数用户只使用少数几种预定义的输入类型。
Reader 不一定必须提供从文件中读取的数据。例如,可以轻松定义一个从数据库中或从内存映射数据结构中读取记录的 reader。类似地,我们支持一组输出类型,以便以不同格式生成数据,用户代码也可以轻松地添加对新输出类型的支持。
4.5 副作用
在某些情况下,MapReduce 的用户发现从其 map 和/或 reduce 操作中生成辅助文件作为附加输出很方便。我们依赖应用程序编写者使这些副作用具有原子性和幂等性。通常,应用程序写入一个临时文件,并在完全生成后以原子方式重命名该文件。
MapReduce 本身 不支持保证这些文件的原子提交,即它们可能部分成功,部分失败。即不支持单任务生成的多个输出文件的原子两阶段提交。大致原因是,只能追加文件,无法轻易实现回滚。
[!NOTE]
如今更高级的存储系统 HBase、Spanner 等支持事务性操作。
4.6 跳过错误记录
有时用户代码中存在导致 Map 或 Reduce 函数在某些记录上确定性崩溃的错误。这些错误会阻止 MapReduce 操作的完成。通常的处理方式是修复错误,但有时这不可行;可能该错误位于一个无法获取源代码的第三方库中。另外,有时忽略少数记录是可以接受的,例如在对大型数据集进行统计分析时。我们提供了一种可选的执行模式,其中 MapReduce 库检测导致确定性崩溃的记录,并跳过这些记录以继续执行。
每个工作进程安装了一个信号处理程序,用于捕捉段错误和总线错误。在调用用户的 Map 或 Reduce 操作之前,MapReduce 库会将参数的序列号存储在全局变量中。如果用户代码生成信号,信号处理程序会发送一个包含序列号的“最后一息”UDP 数据包给 MapReduce 主节点。当主节点在特定记录上看到多个失败时,它会指示在下次重新执行相应的 Map 或 Reduce 任务时跳过该记录。
4.7 本地执行
调试 Map 或 Reduce 函数中的问题可能很棘手,因为实际计算发生在分布式系统中,通常在数千台机器上运行,并且工作分配由主节点动态决定。为了帮助调试、性能分析和小规模测试,我们开发了 MapReduce 库的替代实现,该实现按顺序在本地机器上执行 MapReduce 操作的所有工作。用户可以通过特定的标志调用他们的程序,从而轻松地使用任何他们认为有用的调试或测试工具(例如 gdb)
4.8 状态信息
主节点运行一个内部 HTTP 服务器,并提供一组供人工查看的状态页面。这些状态页面显示计算的进度,如已完成任务数量、进行中任务数量、输入字节数、中间数据字节数、输出字节数、处理速率等。这些页面还包含指向每个任务生成的标准错误和标准输出文件的链接。用户可以使用这些数据来预测计算的完成时间,并决定是否应增加计算资源。这些页面还可以用来判断计算是否比预期慢得多。
此外,顶层状态页面显示哪些工作节点已失败,以及它们在失败时正在处理的 map 和 reduce 任务。这些信息在诊断用户代码中的错误时很有帮助。
4.9 计数器
MapReduce 库提供一个计数器工具来统计各种事件的发生次数。例如,用户代码可能希望统计处理的总词数或索引的德语文档数等。
要使用此工具,用户代码创建一个命名的计数器对象,然后在 Map 和/或 Reduce 函数中适当地递增计数器。例如:
Counter* uppercase;
uppercase = GetCounter("uppercase");
map(String name, String contents):
  for each word w in contents:
    if (IsCapitalized(w)):
      uppercase-\>Increment();
  EmitIntermediate(w, "1");
各个工作机器上的计数器值会定期通过 ping 响应传递到主节点。主节点从成功的 map 和 reduce 任务中聚合计数器值,并在 MapReduce 操作完成时返回给用户代码。当前的计数器值也显示在主节点状态页面上,以便人工观察计算的实时进度。在聚合计数器值时,主节点会消除同一 map 或 reduce 任务的重复执行效果,以避免双重计数(重复执行可能来自于使用备份任务以及因失败而重新执行任务)。
用户发现计数器工具对检查 MapReduce 操作的行为是否正常很有帮助。例如,在某些 MapReduce 操作中,用户代码可能希望确保生成的输出对数与处理的输入对数完全相等,或者处理的德语文档占处理的总文档数的比率在某个可接受范围内。
5. 性能
在本节中,我们对运行在大型机群上的两个计算任务的 MapReduce 性能进行了测量。一个计算任务在大约 1TB 的数据中搜索特定模式,另一个计算任务对大约 1TB 的数据进行排序。
这两个程序代表了 MapReduce 用户编写的大部分真实程序的一个重要子集。其中一类程序将数据从一种表示形式转换为另一种表示形式,另一类程序则从大型数据集中提取少量有趣的数据。
5.1 集群配置
1800 机器 + 2 * 2Ghz * 4GB Mem + 2* 160GB 磁盘 + 1 Gbps 网络 + 2 级树状交换组织,根部提供 100-200Gbps 总带宽。任意一对机器的 RTT 小于 1ms
5.2 Grep
grep 程序扫描条 100 字节的记录,搜索一个相对稀有的 3 字符(这个模式出现在记录中。输入被分成了 64MB 的块(M = 15000),所有输出放在一个文件中(R = 1)。图 2 展示了计算随着时间的进展。
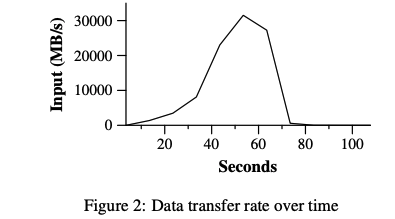
Y 轴显示了扫描输入数据的速率。随着更多机器被分配到这个 MapReduce 计算中,速率逐渐上升,在分配了 1764 个工作节点时达到 30 GB/s 的峰值。当 map 任务完成时,速率开始下降,约在计算开始 80 秒后降为零。整个计算大约耗时 150 秒,包括约一分钟的启动开销。该开销主要是将程序传播到所有工作机器,以及与 GFS 交互以打开 1000 个输入文件并获取定位优化所需的信息的延迟
5.3 排序
Sort 程序对个 100 字节的记录进行排序。该程序基于 TeraSort 基准[10]。排序程序包含不到 50 行用户代码。一个包含三行的 Map 函数从文本行中提取一个 10 字节的排序键,并将该键和原始文本行作为中间键/值对发出。我们使用内置的 Identity 函数作为 Reduce 操作符。该函数保持中间键/值对不变,直接输出为最终的键/值对。最终排序的输出写入一组 2 路复制的 GFS 文件(即该程序的输出写入了 2TB 的数据)
图 3(a)展示了排序程序正常执行的进展情况。左上图显示了读取输入的速率。速率峰值约为 13GB/s,并在 200 秒内所有 map 任务完成之前迅速下降。请注意,输入速率低于 grep,因为排序的 map 任务将其约一半的时间和 I/O 带宽用于将中间输出写入本地磁盘。grep 的相应中间输出尺寸可以忽略不计。
5.5 机器失效
图 3(C),我们展示了排序程序执行中突然干掉了 1746 个中的 200 个 worker 进程。底层的集群调度器很快在机器上重启新的 worker 进程,机器仍然能够工作。工作节点故障表现为输入速率下降,因为部分已完成的映射任务(对应的工作节点已失效)需要重新执行。这些任务的重新执行速度较快。整个计算过程(包括启动开销)共耗时 933 秒,仅比正常执行时间增加了 5%。
6. 经验
它已经被广泛应用于 Google 内的多个领域,包括:
- 大规模机器学习问题,
- Google 新闻和 Froogle 产品的聚类问题,
- 用于生成热门查询报告的数据提取(例如,Google Zeitgeist),
- 用于新实验和产品的网页属性提取(例如,从大规模网页语料库中提取地理位置用于本地化搜索),
- 大规模图计算。
6.1 大规模索引
迄今为止,我们最重要的 MapReduce 应用之一是彻底重写了生产索引系统,该系统生成用于 Google 网页搜索服务的数据结构。该索引系统将我们爬虫系统检索到的大量文档作为输入,这些文档存储为一组 GFS 文件。这些文档的原始内容超过 20TB 数据。索引过程作为五到十个 MapReduce 操作的序列运行。使用 MapReduce(而不是在旧版索引系统中采用的临时分布式操作)提供了几个好处:
- 索引代码更简单、更小、更易于理解,因为处理容错、分布式和并行化的代码都隐藏在 MapReduce 库中。例如,计算的一个阶段的代码量从约 3800 行 C++代码减少到使用 MapReduce 表达时约 700 行。
附录:代码
#include "mapreduce/mapreduce.h"
// User’s map function
class WordCounter : public Mapper {
public:
	virtual void Map(const MapInput &input) {
		const string &text = input.value();
		const int n = text.size();
		for (int i = 0; i < n;) {
			// Skip past leading whitespace
			while ((i < n) && isspace(text[i]))
				i++;
			// Find word end
			int start = i;
			while ((i < n) && !isspace(text[i]))
				i++;
			if (start < i)
				Emit(text.substr(start, i - start), "1");
		}
	}
};

REGISTER_MAPPER(WordCounter);


// User’s reduce function
class Adder : public Reducer {
	virtual void Reduce(ReduceInput *input) {
		// Iterate over all entries with the
		// same key and add the values
		int64 value = 0;
		while (!input->done()) {
			value += StringToInt(input->value());
			input->NextValue();
		}
		// Emit sum for input->key()
		Emit(IntToString(value));
	}
};

REGISTER_REDUCER(Adder);

int main(int argc, char **argv) {
	ParseCommandLineFlags(argc, argv);
	MapReduceSpecification spec;
	// Store list of input files into "spec"
	for (int i = 1; i < argc; i++) {
		MapReduceInput *input = spec.add_input();
		input->set_format("text");
		input->set_filepattern(argv[i]);
		input->set_mapper_class("WordCounter");
	}
	// Specify the output files:
	// /gfs/test/freq-00000-of-00100
	// /gfs/test/freq-00001-of-00100
	// ...
	MapReduceOutput *out = spec.output();
	out->set_filebase("/gfs/test/freq");
	out->set_num_tasks(100);
	out->set_format("text");
	out->set_reducer_class("Adder");
	// Optional: do partial sums within map
	// tasks to save network bandwidth
	out->set_combiner_class("Adder");
	// Tuning parameters: use at most 2000
	// machines and 100 MB of memory per task
	spec.set_machines(2000);
	spec.set_map_megabytes(100);
	spec.set_reduce_megabytes(100);
	// Now run it
	MapReduceResult result;
	if (!MapReduce(spec, &result))
		abort();
	// Done: ’result’ structure contains info
	// about counters, time taken, number of
	// machines used, etc.
	return 0;
}
本讲小结
MapReduce 编程模型已经成功应用到 google 的各种应用场景中。成功的原因有几个
-
模型足够简单。甚至对于不懂的并行和分布式经验的程序员也能写好业务代码,因为它隐藏了并行、容错、位置优化和负载均衡等细节
-
大部分问题都能用 MapReduce 来表达,比如数据挖掘、机器学习等
-
我们开发了一个 MapReduce 的实现,可以扩展到包含成千上万台机器的大型集群。该实现有效地利用了这些机器资源,因此适用于在谷歌遇到的许多大型计算问题上使用。
从这项工作中学到了几件事情。
- 限制编程模型使得并行化和分发计算以及使这种计算具有容错性变得容易。
- 网络带宽是一种稀缺资源。因此,我们系统中的许多优化都针对减少网络传输的数据量:本地化优化使我们能够从本地磁盘读取数据,并将中间数据写入本地磁盘的单个副本可以节省网络带宽。
- 冗余执行可以用于减少慢速机器的影响,并处理机器故障和数据丢失