Spark
摘要
LEC 15: Big Data: Spark, video Preparation: Read Spark (2012) (FAQ) (Question)
当前课程暂无后续已收录内容。
Lec 12 Spark
LEC 15: Big Data: Spark, video Preparation: Read Spark (2012) (FAQ) (Question)
Bigtable 的开源版本(如 HBase)
论文阅读:弹性分布式数据集 RDD
《Resilient Distributed Datasets: A Fault-Tolerant Abstraction for In-Memory Cluster Computing, OSDI'12》 最佳博士论文
Mapreduce 的论文是在 2008 年,分布式图计算框架 Pregel 是 2010 年
本讲导览
弹性分布式数据集(Resilient Distributed Datasets,RDDs)这是一种分布式内存抽象,允许程序员在大型集群上以容错的方式执行内存计算。RDDs 的设计动机源于当前计算框架无法高效处理的两类应用程序:迭代算法和交互式数据挖掘工具。在这两种情况下,将数据保存在内存中可以将性能提升一个数量级。为了高效地实现容错,RDDs 提供了一种受限的共享内存形式,基于粗粒度的转换(coarse-grained transformations),而非对共享状态的细粒度更新。我们展示了 RDDs 足够表达一大类计算,包括最近专门为迭代作业设计的编程模型(如 Pregel)等等。我们在一个名为 Spark 的系统中实现了 RDDs,并通过多种用户应用和基准测试对其进行了评估。
1. 引言
集群计算(Cluster computing)框架如 MapReduce 和 Dryad 已经被广泛采用于大规模数据分析。这些系统允许用户使用一组高级操作符编写并行计算,而无需担心工作分配和容错问题。尽管现有的框架提供了众多用于访问集群计算资源的抽象,但它们缺乏利用分布式内存的抽象。在许多迭代的机器学习和图算法中,如 PageRank、K 均值聚类和逻辑回归,数据重用非常常见。另一个引人注目的用例是交互式数据挖掘,用户在同一数据子集上运行多次临时查询。不幸的是,在大多数现有框架中,在计算之间重用数据(例如,在两个 MapReduce 作业之间)唯一的方法是将数据写入外部的稳定存储系统,例如分布式文件系统。
认识到这个问题,研究人员为一些需要数据重用的应用开发了专门的框架,比如 Pregel 是一个迭代式的图计算框架,将中间数据在内存中保持。然而,这些框架仅支持特定的计算模式(例如循环执行一系列 MapReduce 步骤),并且仅在这些模式下隐式地执行数据共享。它们不提供更通用的数据复用抽象。 我们提出了一种新的抽象,称为弹性分布式数据集(RDD),它可以在广泛的应用中实现高效的数据重用。RDD 是一种容错的并行数据结构,允许用户显式地将中间结果持久化在内存中,控制它们的分区以优化数据的放置,并使用丰富的操作符集合来操作它们。
设计 RDD 的主要挑战在于定义一个能够高效提供容错的编程接口。现有的集群内存存储抽象,如分布式共享内存、键值存储、数据库和 Piccolo,提供的接口基于对可变状态(例如表格中的单元格)的细粒度更新。对于这种接口,提供容错的唯一方法是将数据复制到多台机器上或跨多台机器记录更新。这两种方法对于数据密集型工作负载来说都很昂贵,因为它们需要通过集群网络复制大量数据,而集群网络的带宽远低于 RAM,并且它们会产生大量的存储开销。
与这些系统相比,RDD 提供了一个基于粗粒度变换(例如,map、filter 和 join)的接口,该变换将同一操作应用于许多数据项。这使得 RDD 能够通过记录用于构建数据集的变换而不是实际数据,来高效地提供容错。如果 RDD 的一个分区丢失了,RDD 拥有足够的信息来重新计算丢失的分区,而无需昂贵的复制。因此,丢失的数据可以快速恢复,而不需要高成本的复制。尽管基于粗粒度变换的接口乍看起来可能有限,但 RDD 非常适合许多并行应用,因为这些应用自然地将同一操作应用于多个数据项。
我们在一个称为 Spark 的系统中实现了 RDD,该系统正在加州大学伯克利分校和几家公司用于研究和生产应用。Spark 提供了一个方便的语言集成编程接口,类似于 Scala 编程语言中的 DryadLINQ [31]。此外,Spark 可以交互式地用于从 Scala 解释器查询大数据集。我们相信,Spark 是第一个允许使用通用编程语言以交互速度在集群上进行内存数据挖掘的系统。
Spark 比 Hadoop 快 20 倍,加速了一个现实世界的数据分析报告 40 倍,并且可以交互式地以 5-7 秒的延迟扫描 1 TB 的数据集。更为根本的是,为了说明 RDD 的通用性,我们在 Spark 之上实现了 Pregel 和 HaLoop 编程模型,包括它们所采用的放置优化
本文首先概述了 RDD (§2)和 Spark (§3),然后讨论了 RDD 的内部表示 (§4)、我们的实现 (§5)和实验结果 (§6)。最后,我们讨论了 RDD 如何捕捉几个现有的集群编程模型 (§7),回顾相关工作 (§8),并作出总结。
2. 弹性分布式数据集
本节提供了对 RDD 的概述。我们首先定义 RDD (§2.1) 并介绍它们在 Spark 中的编程接口 (§2.2)。接着,我们将 RDD 与更细粒度的共享内存抽象进行比较 (§2.3)。最后,我们讨论 RDD 模型的局限性 (§2.4)
2.1 RDD 的抽象
形式上,RDD 是一个只读的、分区的记录集合。RDD 只能通过对(1)稳定存储中的数据或(2)其他 RDD 进行确定性的操作来创建。我们称这些操作为转换(Transformation),以区别于对 RDD 进行的其他操作。转换的例子包括 map、filter 和 join。
RDD、并不需要始终被物化(即立即存储其所有数据)。相反,RDD 中保存了足够的信息,用于描述它是如何从其他数据集派生出来的(称为血统 lineage),从而可以根据稳定存储中的原始数据,重新计算出它的各个分区。 这种属性非常强大:本质上,程序不能引用一个在故障后无法重建的 RDD。最后,用户可以控制 RDD 的两个方面:持久性(persistence)和分区方式(partitioning)。用户可以指定哪些 RDD 会被重复使用,并为它们选择一种存储策略(例如存储在内存中)。也可以要求根据记录中的某个键,将 RDD 的元素在不同机器之间进行分区。这对于数据位置优化非常有用,例如确保两个即将进行连接(join)操作的数据集被使用相同的哈希分区策略。
2.2 Spark 的编程接口
在 Spark 你可以像操作普通变量一样操作 RDD,在这些 API 中,每个数据集被表示为一个对象,并且可以通过这些对象上的方法调用转换。
程序员首先通过对稳定存储中的数据进行转换(例如 map 和 filter)来定义一个或多个 RDD。然后,他们可以在操作中使用这些 RDD,这些操作返回一个值给应用程序或将数据导出到存储系统。操作的例子包括 count(返回数据集中的元素数)、collect(返回元素本身)和 save(将数据集输出到存储系统)。RDD 是惰性求值的,以便能够对转换进行流水线处理。
如果你希望后续多次使用某个 RDD,可以调用 persist() 方法将其持久化。默认情况下,Spark 将持久化的 RDD 保存在内存中,但如果内存不足,它可以将它们溢出到磁盘。用户还可以通过 persist 的标志请求其他持久化策略,例如仅将 RDD 存储在磁盘上或在机器间复制。最后,用户可以为每个 RDD 设置持久化优先级,以指定哪些内存数据应首先溢出到磁盘。
2.2.1 示例: 控制台日志挖掘
假设某个 Web 服务遇到了错误,运维人员希望搜索 Hadoop 文件系统(HDFS)中的海量日志,以查找问题的原因。使用 Spark,运维人员可以将日志中的错误消息加载到一组节点的内存中,并进行交互式查询。
首先,她会输入以下 Scala 代码:
lines = spark.textFile("hdfs://...")
errors = lines.filter(_.startsWith("ERROR"))
errors.persist()
第一行定义了一个由 HDFS 文件支持的 RDD(作为文本行的集合),第二行从中派生出一个过滤后的 RDD。第三行要求将错误消息持久化到内存中,以便可以在查询中共享它们。请注意,filter的参数是 Scala 语法中的闭包。
此时,集群上尚未执行任何工作。然而,用户现在可以在操作中使用 RDD,例如,计算消息的数量:
errors.count()用户还可以对 RDD 进行进一步的转换并使用其结果,如以下几行代码所示:
// 统计包含MySQL的错误:
errors.filter(_.contains("MySQL")).count()
// 返回包含HDFS的错误的时间字段作为数组(假设时间是制表符分隔格式中的字段号3):
errors.filter(_.contains("HDFS"))
.map(_.split(’\t’)(3))
.collect()
在第一次涉及 errors 的操作运行后,Spark 将把错误的分区存储在内存中,从而大大加快后续的计算。请注意,基础 RDD(lines)不会加载到 RAM 中。这是理想的,因为错误消息可能只是数据的一小部分(小到可以装入内存)。
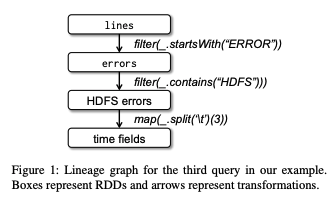
最后,为了说明我们的模型如何实现容错性,我们展示了图 1 中 RDD 在第三个查询中的血统图。在此查询中,Spark 会将 filter 和 map 组合为一个任务,分发到集群中每个分区执行,计算完成后,collect() 会将所有符合条件的数据汇集回驱动程序。实际上这段代码是,提取包含 "HDFS" 的错误中的时间字段,collect()会触发 action,返回一个包含时间字段的数组。容错机制 基于血统:如果某个分区丢失,Spark 仅需重算丢失的分区,而非全部数据。
2.3 RDD 模型的优势
为了理解 RDD 作为分布式内存抽象的好处,我们在表 1 中将其与分布式共享内存(DSM)进行了比较。在 DSM 系统中,应用程序读取和写入全局地址空间中的任意位置。DSM 是一个非常通用的抽象,但这种通用性使得在商品集群上以高效和容错的方式实现它变得更加困难。
| 方面 | RDDs | 分布式共享内存 (DSM) |
|---|---|---|
| 读取操作 | 粗粒度或细粒度 | 细粒度 |
| 写入操作 | 粗粒度 | 细粒度 |
| 一致性 | 简单(不可变) | 由应用程序或运行时环境决定 |
| 故障恢复 | 使用数据血统进行细粒度、低开销的恢复 | 需要检查点和程序回滚 |
| 缓慢节点缓解 | 通过备份任务实现 | 难以实现 |
| 工作分配 | 基于数据位置自动安排 | 由应用程序决定(运行时环境尝试透明化) |
| 内存不足时的行为 | 类似于现有的数据流系统 | 性能差(可能出现交换?) |
RDD 与 DSM 的主要区别在于,RDD 只能通过粗粒度的转换(例如 map 和 filter)来创建("写入"),而 DSM 允许对每个内存位置进行读写。这限制了 RDD 只能用于执行批量写入的应用程序,但允许更高效的容错性。特别是,RDD 不需要产生检查点的开销,因为它们可以通过血统信息进行恢复。此外,在故障发生时,只需重新计算 RDD 的丢失分区,并且可以在不同的节点上并行进行重新计算,而不需要回滚整个程序。
RDD 的另一个好处是,由于其不可变性,系统可以通过运行慢速任务的备份副本来缓解慢速节点("拖尾")的影响,如 MapReduce [10]中的实现。如果是 DSM,则难以实现备份任务,因为任务的两个副本将访问相同的内存位置,并干扰彼此的更新。
最后,RDD 相比于 DSM 还提供了两个其他好处。首先,在 RDD 上的批量操作中,运行时可以基于数据本地性进行任务调度,以提高性能。其次,只要 RDD 仅用于基于扫描的操作,当内存不足以存储它们时,它们会优雅地退化。未能装入 RAM 的分区可以存储在磁盘上,并提供与当前数据并行系统相似的性能。
2.4 不适合 RDD 的应用
RDD 最适合批处理应用,这些应用对数据集的所有元素应用相同的操作。在这些情况下,RDD 可以高效地记住每次转换作为血统图中的一个步骤,并且可以在不需要记录大量数据的情况下恢复丢失的分区。RDD 不太适合那些对共享状态进行异步细粒度更新的应用,例如 Web 应用程序的存储系统或增量 Web 爬虫。对于这些应用,使用执行传统的更新日志记录和数据检查点的系统更为高效。我们的目标是为批量分析提供一种高效的编程模型,并将这些异步应用留给专用系统
3. RDD 抽象的 Spark 实现
Spark 通过一个类似于 DryadLINQ 的语言集成 API 来提供 RDD 抽象。该 API 在 Scala 中实现,Scala 是一种用于 Java 虚拟机(JVM)的静态类型的函数式编程语言。我们选择 Scala 是因为它具有简洁性(便于交互使用)和效率(由于静态类型)。不过,RDD 抽象本身并不需要函数式语言。
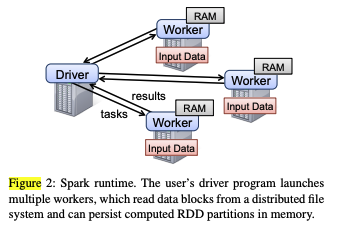
为了使用 Spark,开发者编写一个驱动程序,该程序连接到一组工作节点,如图 2 所示。驱动程序定义一个或多个 RDD,并在其上调用操作。驱动程序中的 Spark 代码还跟踪 RDD 的血统(即数据的来源和变换过程)。工作节点是持久化的进程,可以在多次操作之间将 RDD 的分区存储在 RAM 中。
正如我们在第 2.2.1 节的日志挖掘示例中所展示的,用户通过传递闭包给 RDD 操作(如map)来提供参数。Scala 将每个闭包表示为一个 Java 对象,这些对象可以序列化并加载到另一个节点上,以在网络上传递闭包。Scala 还将闭包中绑定的变量作为字段保存在 Java 对象中。例如,可以编写如下代码来将 5 添加到 RDD 的每个元素中:var x = 5; rdd.map(_ + x)。
RDD 本身是具有静态类型的对象,其参数化的元素类型。例如,RDD[Int]表示一个整数的 RDD。然而,由于 Scala 支持类型推断,大多数示例中我们省略了类型。
尽管我们在 Scala 中暴露 RDD 的方法在概念上很简单,但我们不得不使用反射来解决 Scala 的闭包对象的一些问题。我们还需要更多的工作来使 Spark 在 Scala 解释器中可用,具体内容将在第 5.2 节讨论。然而,我们并没有修改 Scala 编译器。
3.1 Spark 中的 RDD 操作
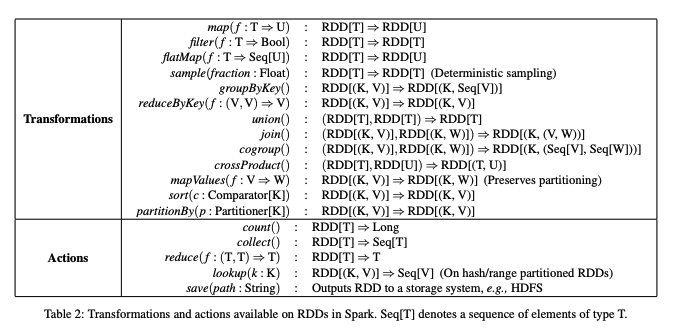
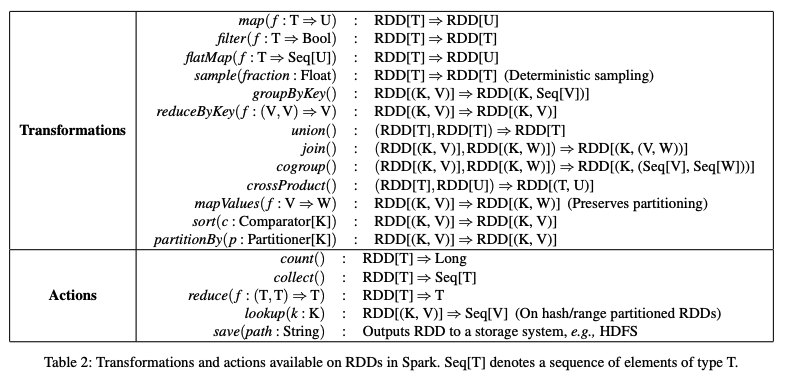
表 2 列出了 Spark 中主要的 RDD 转换和动作操作。我们给出了每个操作的签名,使用方括号表示类型参数。回想一下,转换操作是定义一个新 RDD 的惰性操作,而动作操作会启动计算以将值返回给程序或将数据写入外部存储。需要注意的是,一些操作(如join)只在键值对 RDD 上可用。此外,我们选择的函数名称与 Scala 和其他函数式语言中的 API 相匹配;例如,map是一个一对一的映射,而flatMap将每个输入值映射到一个或多个输出(类似于 MapReduce 中的map)。
除了这些操作之外,用户还可以要求持久化一个 RDD。此外,用户可以获取一个 RDD 的分区顺序,该顺序由一个 Partitioner 类表示,并根据它对另一个数据集进行分区。诸如groupByKey、reduceByKey和sort之类的操作会自动生成哈希或范围分区的 RDD。
3.2 示例应用程序
我们用两个迭代应用程序来补充第 2.2.1 节中的数据挖掘示例:逻辑回归和 PageRank。后者还展示了如何控制 RDD 的分区以提高性能。
3.2.1 逻辑回归
许多机器学习算法具有迭代性,因为它们运行迭代优化过程(如梯度下降)来最大化一个函数。通过将数据保存在内存中,这些算法可以运行得更快。
作为示例,以下程序实现了逻辑回归,一种常见的分类算法,用于寻找最佳分隔两个点集(如垃圾邮件和非垃圾邮件)的超平面 w。该算法使用梯度下降:从随机值 w 开始,在每次迭代中,通过在数据上求和一个函数来移动 w,使其更接近优化目标。
val points = spark.textFile(...)
  .map(parsePoint).persist()
var w = // 随机初始向量
for (i <- 1 to ITERATIONS) {
  val gradient = points.map { p =>
    p.x * (1/(1+exp(-p.y*(w dot p.x)))-1)*p.y
  }.reduce((a, b) => a + b)
  w -= gradient
}
我们首先通过对文本文件执行map转换,并解析每行文本为一个Point对象,定义了一个持久化的 RDD,名为points。然后我们在每次迭代中反复对points执行map和reduce操作,以计算每一步的梯度,方法是对当前w的一个函数求和。通过在迭代之间保持points在内存中,可以实现 20 倍的加速。
3.2.2 PageRank
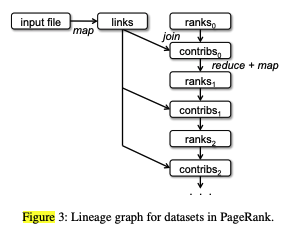
在 PageRank 中发生了更复杂的数据共享模式。该算法通过累加来自链接到它的文档的贡献,迭代地更新每个文档的排名。在每次迭代中,每个文档向其邻居发送一个贡献r/n,其中r是其排名,n是其邻居的数量。然后它将其排名更新为α/N + (1 − α)∑ci,其中累加和来自收到的贡献,N是文档总数。
// 加载图作为(URL, 出链)对的RDD
val links = spark.textFile(...).map(...).persist()
var ranks = // (URL, 排名)对的RDD
for (i <- 1 to ITERATIONS) {
  // 构建一个RDD (targetURL, float)对,
  // 其中包含每个页面发送的贡献
  val contribs = links.join(ranks).flatMap {
    case (url, (links, rank)) =>
      links.map(dest => (dest, rank / links.size))
  }
  // 通过URL求和贡献并获取新排名
  ranks = contribs.reduceByKey((x, y) => x + y)
    .mapValues(sum => α / N + (1 - α) * sum)
}
这个程序导致了图 3 中的 RDD 血统图。在每次迭代中,我们根据前一轮的contribs和ranks以及静态的links数据集创建一个新的ranks数据集。这个图的一个有趣特性是它随着迭代次数的增加而变得越来越长。因此,在有很多迭代的作业中,可能需要可靠地复制一些ranks的版本,以减少故障恢复时间。用户可以通过调用带有RELIABLE标志的persist方法来实现这一点。
最后,我们可以通过控制 RDD 的分区来优化 PageRank 中的通信。如果我们为links指定了一个分区方式(例如,通过 URL 对链接列表进行哈希分区),我们可以以同样的方式对ranks进行分区,确保links和ranks之间的连接操作不需要通信(因为每个 URL 的排名会与其链接列表位于同一台机器上)。我们还可以编写自定义的 Partitioner 类,将相互链接的页面分组在一起(例如,按域名对 URL 进行分区)。这两种优化都可以通过在定义links时调用partitionBy来表达:
links = spark.textFile(...).map(...)
.partitionBy(myPartFunc).persist()在此初始调用之后,links和ranks之间的连接操作将自动将每个 URL 的贡献聚合到其链接列表所在的机器上,在那里计算其新排名,并与其链接一起加入。这种跨迭代的一致分区是像 Pregel 这样专门化框架中的主要优化之一。RDD 允许用户直接表达这一目标。
4. RDD 的表示
为 RDD 提供抽象的挑战之一是能够支持各种转换。理论上应该提供给用户任意组合,因此我们提出了一种基于图形的简单 RDD 表示形式。我们建议通过一个通用接口来表示每个 RDD,该接口公开五条信息:一组分区,它们是数据集的原子部分;一组对父 RDD 的依赖关系;一个基于其父级计算数据集的函数;以及有关其分区方案和数据放置的元数据。
例如,表示 HDFS 文件的 RDD 为文件的每个块都有一个分区,并且知道每个块位于哪些机器上。同时,此 RDD 上的映射结果具有相同的分区,但在计算其元素时将映射函数应用于父级数据。我们在表 3 中总结了此接口。
| 操作 | 作用 |
|---|---|
| partitions() | 返回一个分区对象列表 |
| preferreLocations(p) | 列出由于数据局部性而可以更快访问分区 p 的节点 |
| dependencies() | 返回依赖的列表 |
| iterator(p, parentIters) | 给定分区 p 的父分区的迭代器,计算分区 p 的元素 |
| partitioner() | 返回指定 RDD 是否为哈希/范围分区的元数据 |
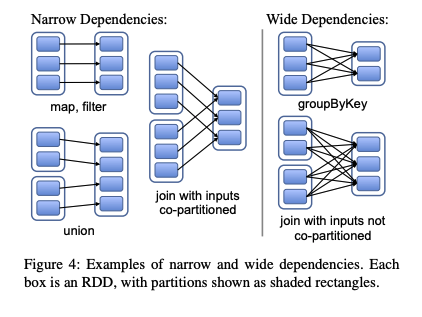
在设计这种接口时,最有趣的问题是如何表示 RDD 之间的依赖关系。 我们发现将依赖关系分类为以下两种类型既足够又实用:
- 窄依赖(Narrow Dependencies):
- 每个父 RDD 的分区最多被一个子 RDD 的分区使用。
- 例如,
map操作会产生窄依赖。
- 宽依赖(Wide Dependencies):
- 多个子 RDD 的分区可能依赖于同一个父 RDD 的分区。
- 例如,
join操作通常会产生宽依赖(除非父 RDD 经过哈希分区)。
图 4 展示了其他示例。
HDFS 文件:在我们的样本中,输入 RDD 来自 HDFS 中的文件。对于这些 RDD,partitions 方法为文件的每个数据块返回一个分区(每个 Partition 对象中存储了数据块的偏移量),preferredLocations 方法返回数据块所在的节点,iterator 方法用于读取数据块。
- map:在任何 RDD 上调用
map方法都会返回一个MappedRDD对象。该对象与其父 RDD 具有相同的分区和首选位置,但在其iterator方法中对父 RDD 的记录应用传递给map方法的函数。 - union:在两个 RDD 上调用
union方法会返回一个 RDD,其分区是父 RDD 分区的并集。每个子分区通过与对应父 RDD 之间的窄依赖(narrow dependency)进行计算。 - sample:抽样操作与映射操作类似,区别在于 RDD 会为每个分区存储一个随机数生成器的种子,从而对父 RDD 的记录进行确定性抽样。
- join:对两个 RDD 执行
join操作可能会产生两种窄依赖(如果两个 RDD 都使用相同的哈希分区器或范围分区器)、两种宽依赖(wide dependency)或二者的混合形式(如果只有一个父 RDD 使用分区器)。无论哪种情况,输出 RDD 都会有一个分区器(要么继承自父 RDD,要么使用默认的哈希分区器)。
5. 实现
我们用大约 14,000 行 Scala 代码实现了 Spark。该系统运行在 Mesos 集群管理器之上 ,因此可以与 Hadoop、MPI 以及其他应用共享资源。每个 Spark 程序作为一个独立的 Mesos 应用运行,拥有自己的 驱动器(driver,即主节点)和工作节点(workers),而这些应用之间的资源共享由 Mesos 管理。Spark 可以通过 Hadoop 现有的输入插件 API,从任何 Hadoop 输入源(例如 HDFS 或 HBase)读取数据,并且可以运行在未修改的 Scala 上。接下来,我们将简要介绍该系统中几个具有技术亮点的部分:§5.1:我们的 作业调度器(job scheduler);§5.2:支持交互式使用的 Spark 解释器(Spark interpreter);§5.3:内存管理机制;§5.4:对 检查点机制(checkpointing)的支持
5.1 Job 调度
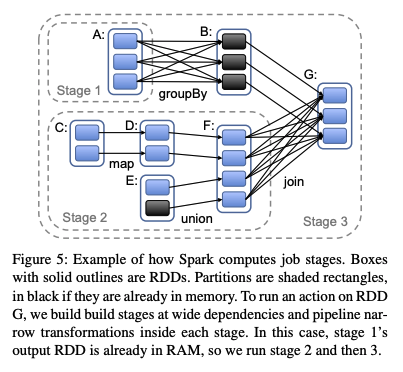
Spark 调度采用了第四节介绍的 RDD 的表示,总的来说,我们的调度器类似于 Dryad‘s,但是考虑了哪写分区的 RDD 在内存可用。每当用户在 RDD 上运行 action(比如 count 或 save),调度程序都会检查该 RDD 的血统以构建要执行的 DAG,如图 5 所示(实线框是 RDD,分区时阴影框,如果在内存则为黑色。要在 RDD G 上 action,在宽依赖项处构建构建阶段,并在每个阶段内流水线化窄转换)。每个阶段都包含尽可能多的的窄依赖性的流水线转换,阶段的边界是宽依赖所需的 shuffe 操作,或者是任何可以缩短父 RDD 计算的已计算分区。