
Lec 11多线程技术(Multithreading Techniques)
Lec 11 多线程技术(Multithreading Techniques)
TL;DR
- 多线程动机与硬件成本:通过交错执行多线程指令隐藏长访存延迟与流水线冒险;硬件需为每个线程独立复制架构状态(PC、GPR 与系统状态),但共享执行单元。
- 调度粒度演进:细粒度多线程(FGMT)按周期交错消解单线程冒险,粗粒度多线程(CGMT)在长停顿事件发生时切换,而同时多线程(SMT)在同周期内向功能单元并发混合发射多线程指令。
- SMT 资源共享与隔离:SMT(如 Pentium 4 超线程)共享物理执行通路与大部分缓存,但在返回栈(RAS)与重命名队列等关键前端结构维持严格的逻辑线程隔离。
一、流水线数据冒险与多线程交错执行
流水线冒险(Pipeline Hazards)
LW r1, 0(r2)
LW r5, 12(r1)
ADDI r5, r5, #12
SW 12(r1), r5
每个指令可能取决于之前的一个,这种情况下要怎么处理?
虽然旁路(bypassing)、推测执行(speculation)和乱序执行(out-of-order execution,O-O-O)可以在一定程度上缓解这些延迟,但它们不能完全消除所有的延迟。
我们如何保证指令之间没有依赖呢?
从不同的程序里面取指令。我们有四个线程(T1 到 T4),它们的指令将在一个没有旁路功能的 5 级流水线中交错执行。
假设我们有以下顺序的指令:
- T1:
LW r1, 0(r2) - T2:
ADD r7, r1, r4 - T3:
XORI r5, r4, #12 - T4:
SW 0(r7), r5 - T1:
LW r5, 12(r1)
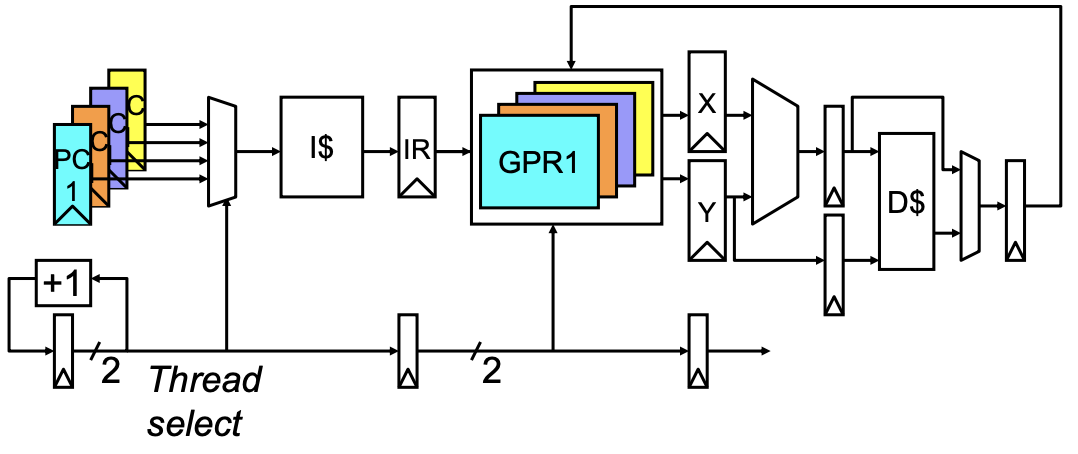
在同一个线程中的前一条指令总是在下一条指令读取寄存器文件之前完成写回(write-back)。
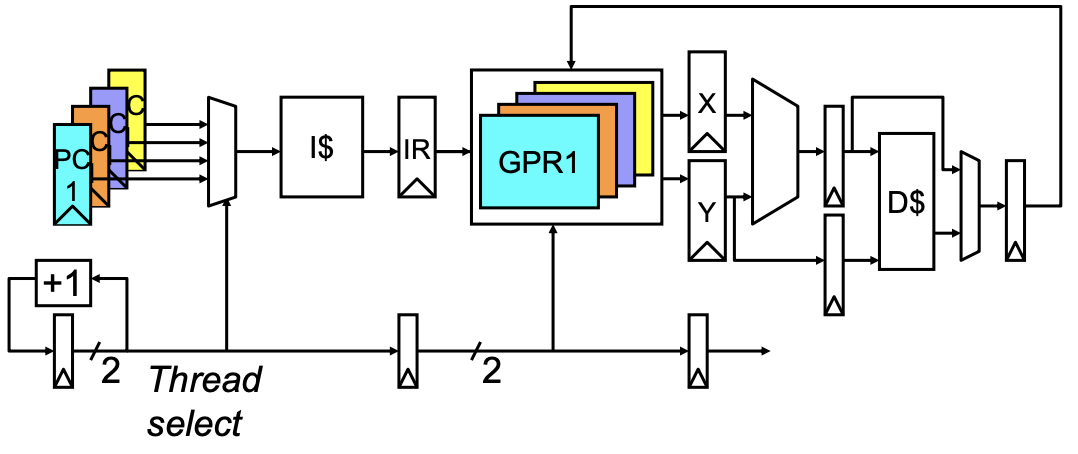
简单单线程流水线
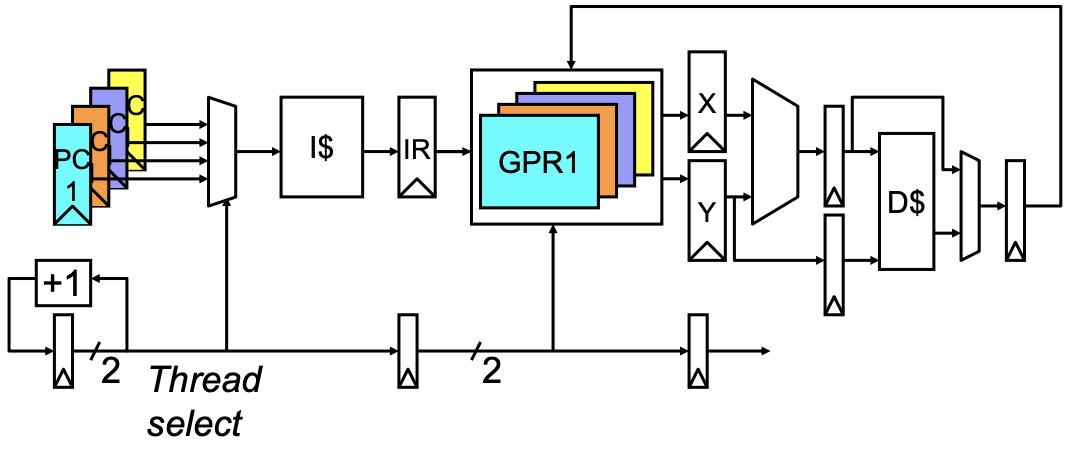
简单多线程流水线
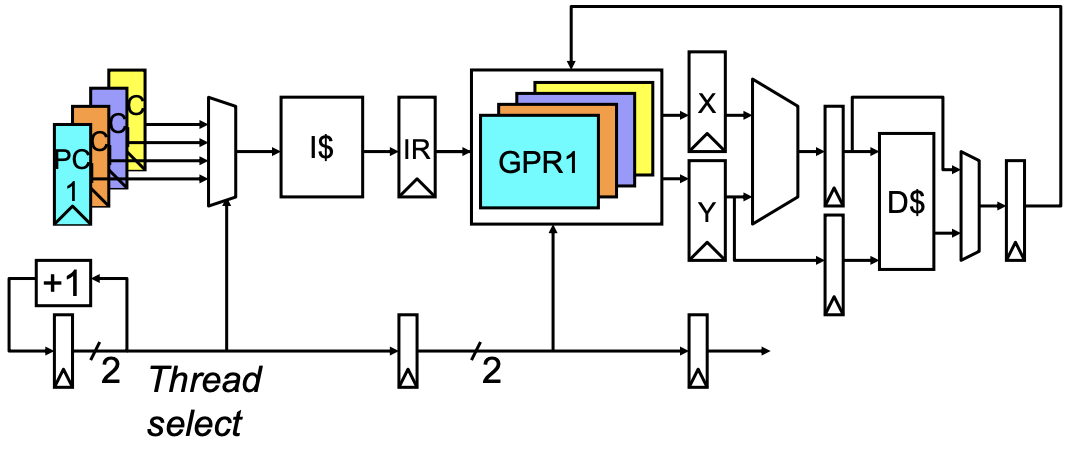
为了确保每个流水线阶段正确地读取和写入状态位,必须在流水线中传递线程选择信息。
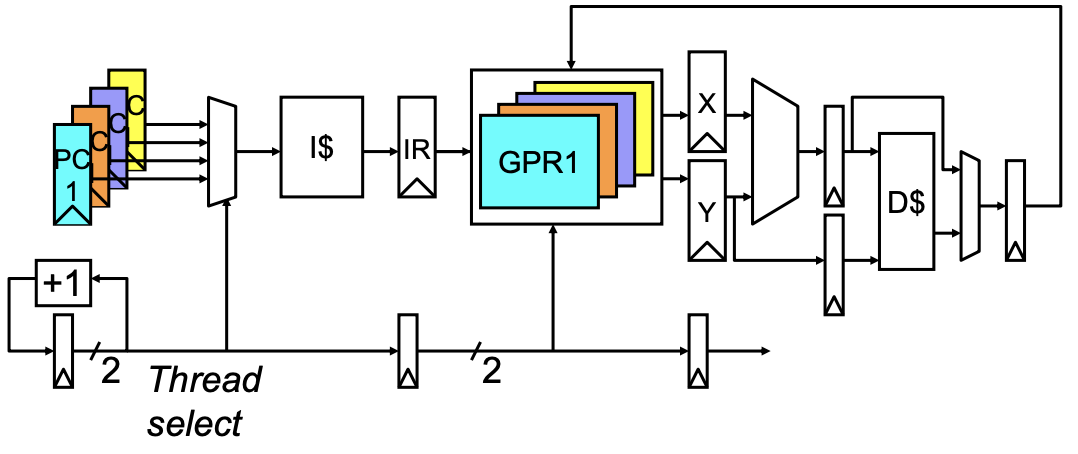
需要在流水线中传递线程选择信息。这可以确保每个阶段知道当前处理的是哪个线程的指令,从而访问和修改正确的状态位,避免线程之间的混淆和数据不一致。
二、多线程硬件开销与架构状态复制
- 每个线程需要自己的用户架构状态
- 程序计数器(PC)
- 通用寄存器(GPRs)
- 还有系统架构状态
- 虚拟内存页基址寄存器
- 异常处理寄存器
- 其他成本
- 上下文切换开销
- 共享资源管理
- 复杂硬件设计
- 在软件(包括操作系统)看来,就像是多个 CPU,虽然速度较慢
三、硬件线程调度策略与实现
- 固定交错执行(CDC 6600, 1965)
- 每个线程在每 N 个周期中执行一条指令。
- 例如,如果有 N 个线程,则每个线程在固定的时间间隔内交替执行指令。
- 如果某个线程在它的时隙中没有准备好执行指令,则在流水线中插入一个空泡(pipeline bubble)
- 软件控制的交错(T1 ASC PPUs, 1971)
- 操作系统(OS)在 N 个线程中分配 S 个流水线时隙。
- 硬件在这 S 个时隙中进行固定交错,执行分配到这些时隙中的线程。
- 硬件控制交错(HEP 1982)
- 硬件跟踪哪些线程准备好执行指令。
- 根据硬件优先级方案选择下一个要执行的线程。
历史硬件多线程机器对比
1、CDC 6600 外围处理器(Peripheral Processors, PPU)
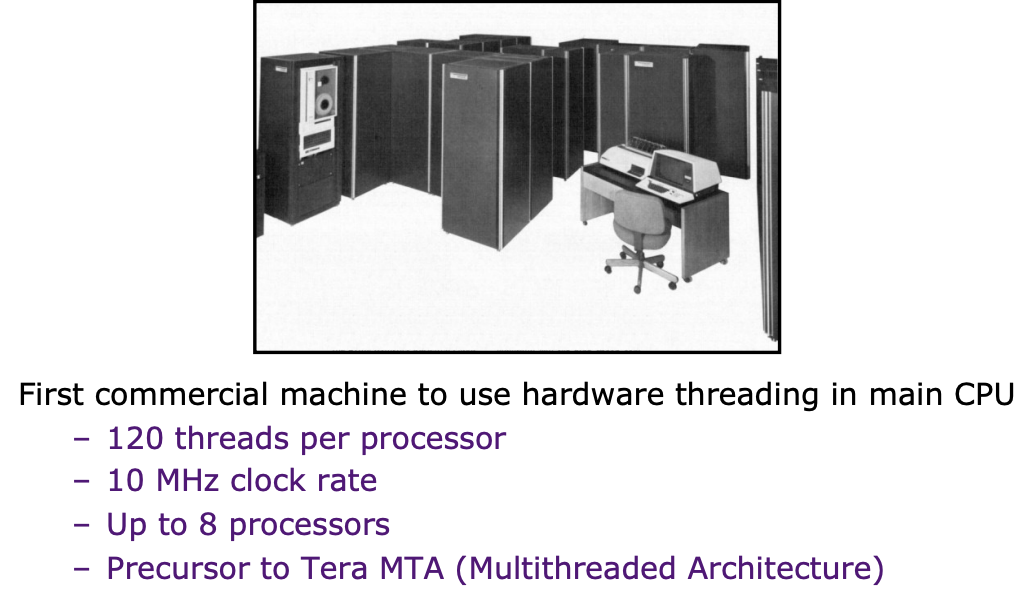
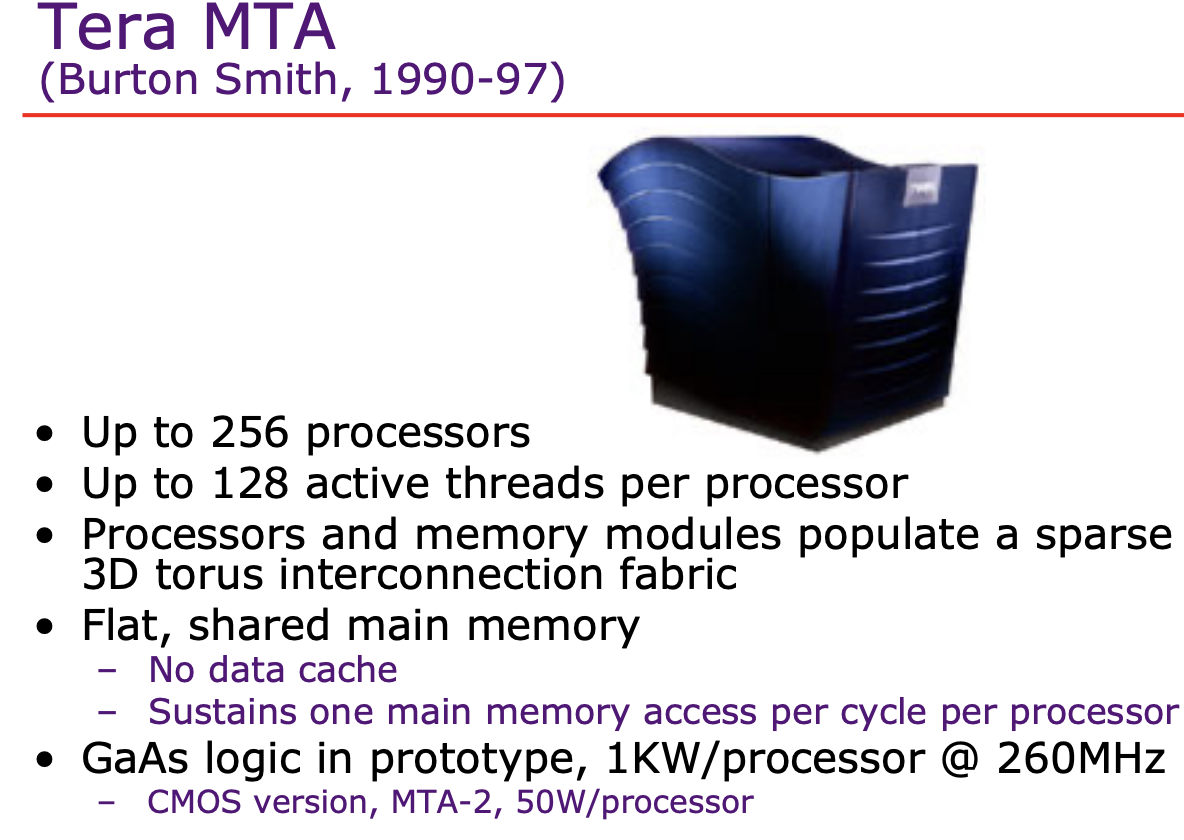
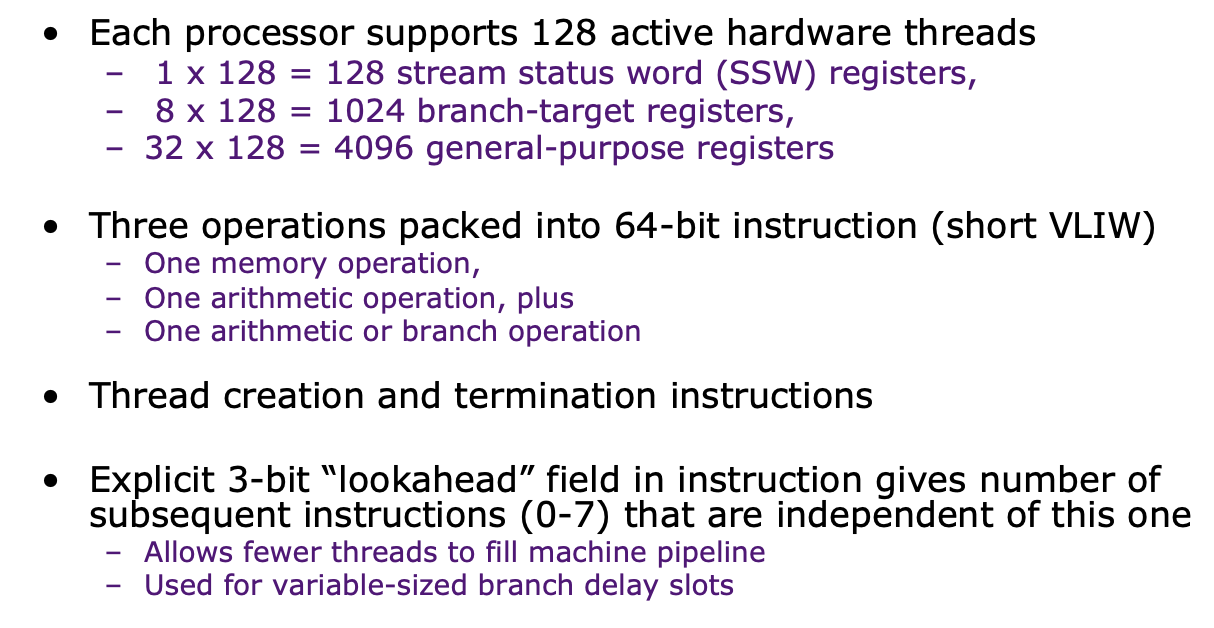
2、Denelcor HEP(Heterogeneous Element Processor, 1982)
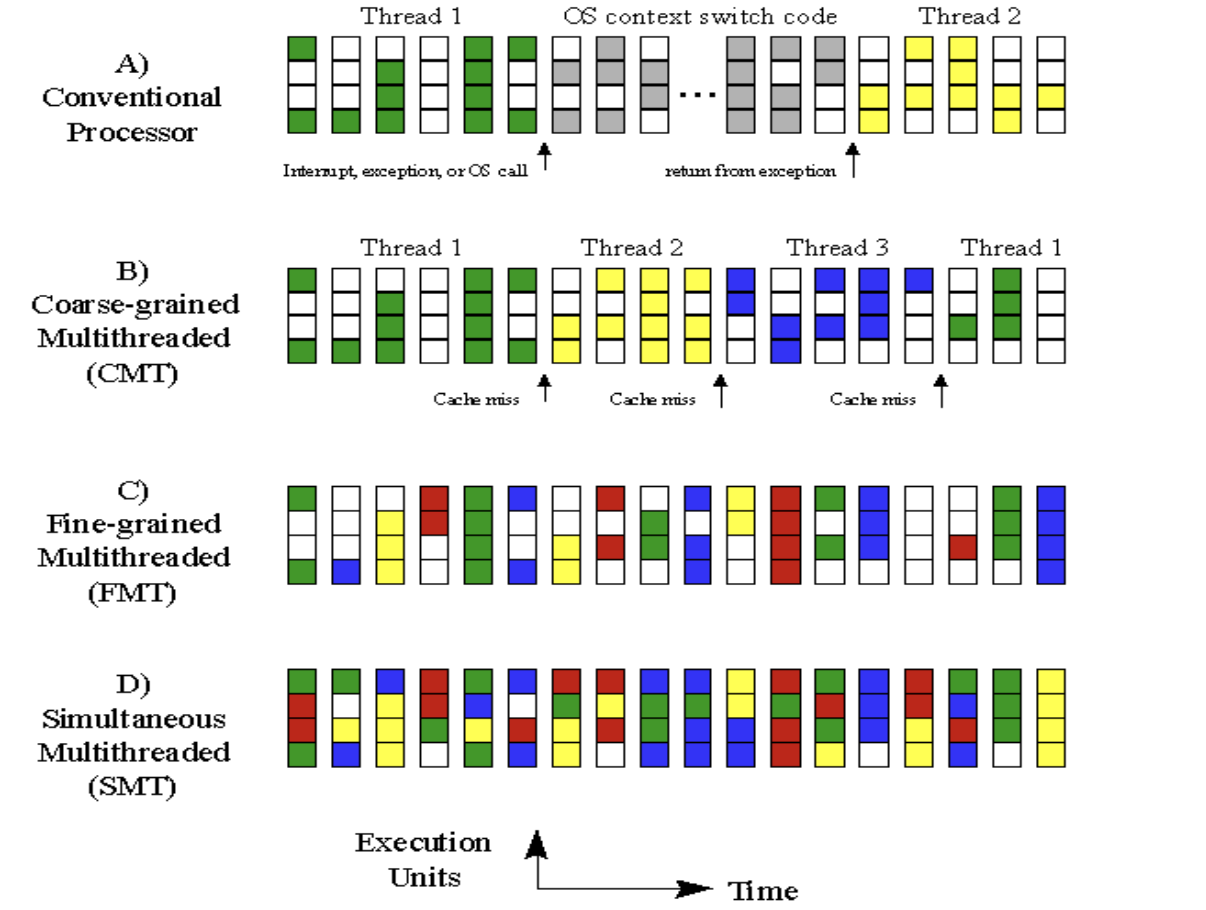
多线程架构时空槽对比
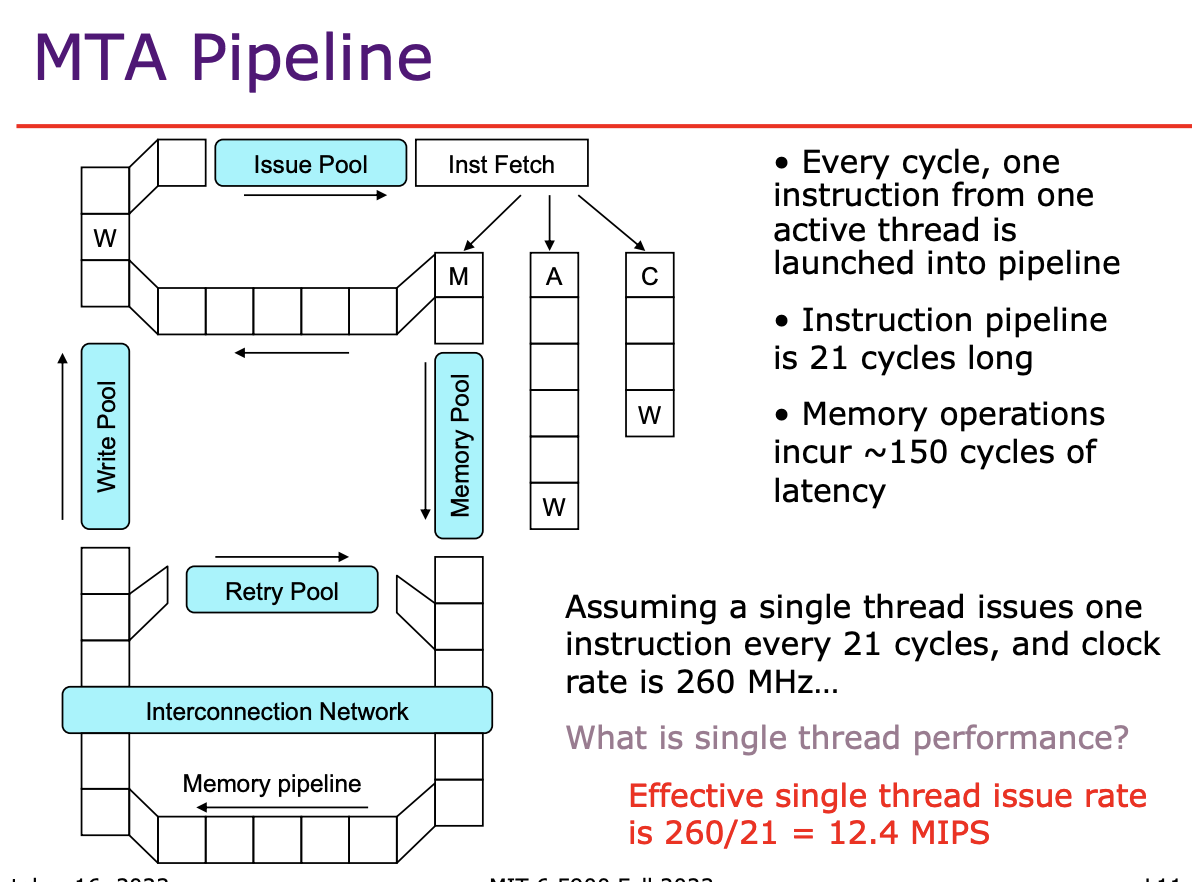
四、细粒度与粗粒度多线程架构
细粒度多线程(Fine-Grained MT)
定义:每个时钟周期都在不同的就绪线程之间进行指令交错发射与上下文轮转。
优点:
- 高效隐藏单个线程内部的流水线延迟与短期数据冒险。
- 能够平滑地在多个就绪线程之间饱和分配执行流水槽。
缺点:
- 单个线程的指令吞吐速率被按线程数成比例分摊。
- 需要在硬件上复制所有活跃线程的状态(寄存器、PC 与状态字)。
适应性:
- 应用具有极高并发度且单线程延迟充裕的场景。
- 追求整体高流水吞吐、允许单线程变慢的吞吐型架构(如 GPU、Tera MTA)。
粗粒度多线程(Coarse-Grained MT)
定义:单个线程连续占用流水线执行,仅当遭遇长延迟事件(如 L2/L3 缓存未命中、TLB 缺失或长周期计算)时才切换至备用线程。
优点:
- 线程切换频率显著降低,单线程在命中缓存时保持全速运行。
- 硬件状态开销较轻,无需在时钟周期级裁决所有在飞线程。
缺点:
- 切换延迟不可忽视(流水线需排空或重填若干阶段)。
- 短期流水线气泡无法被有效填充。
适应性:
- 并发度中等、单线程单核性能要求苛刻的通用计算场景(如 IBM RS64 IV)。
五、奔腾-4 超线程与 SMT 微架构实现
- 首个商用 SMT(同时多线程技术)设计(2 路多线程)
- 超线程=SMT
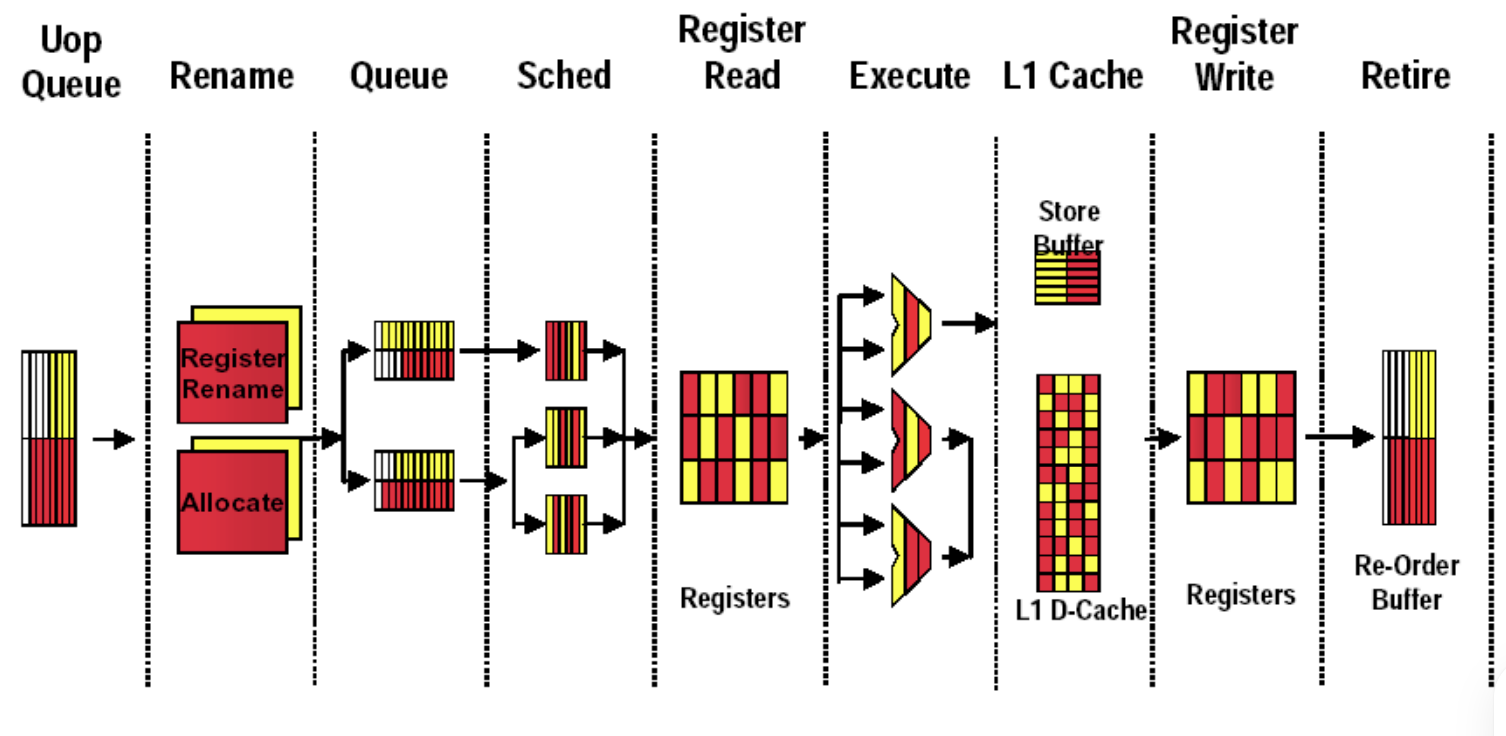
- 逻辑处理器共享几乎所有物理处理器资源
- 一个物理处理器核心被分成两个逻辑处理器。尽管它们在操作系统中表现为两个独立的处理器,但它们共享大部分硬件资源,如缓存、执行单元和分支预测器
- 超线程的芯片面积开销约为 5%
- 当一个逻辑处理器停顿时,另一个可以继续运行
- 在两个线程活跃时,没有一个逻辑处理器可以使用队列中的所有条目
- 处理器运行单个活跃软件线程时,性能几乎不受超线程影响
- 如果处理器只运行一个活跃的线程,开启或关闭 HT 技术对性能几乎没有影响。这是因为一个逻辑处理器可以独占使用所有共享资源。
前端
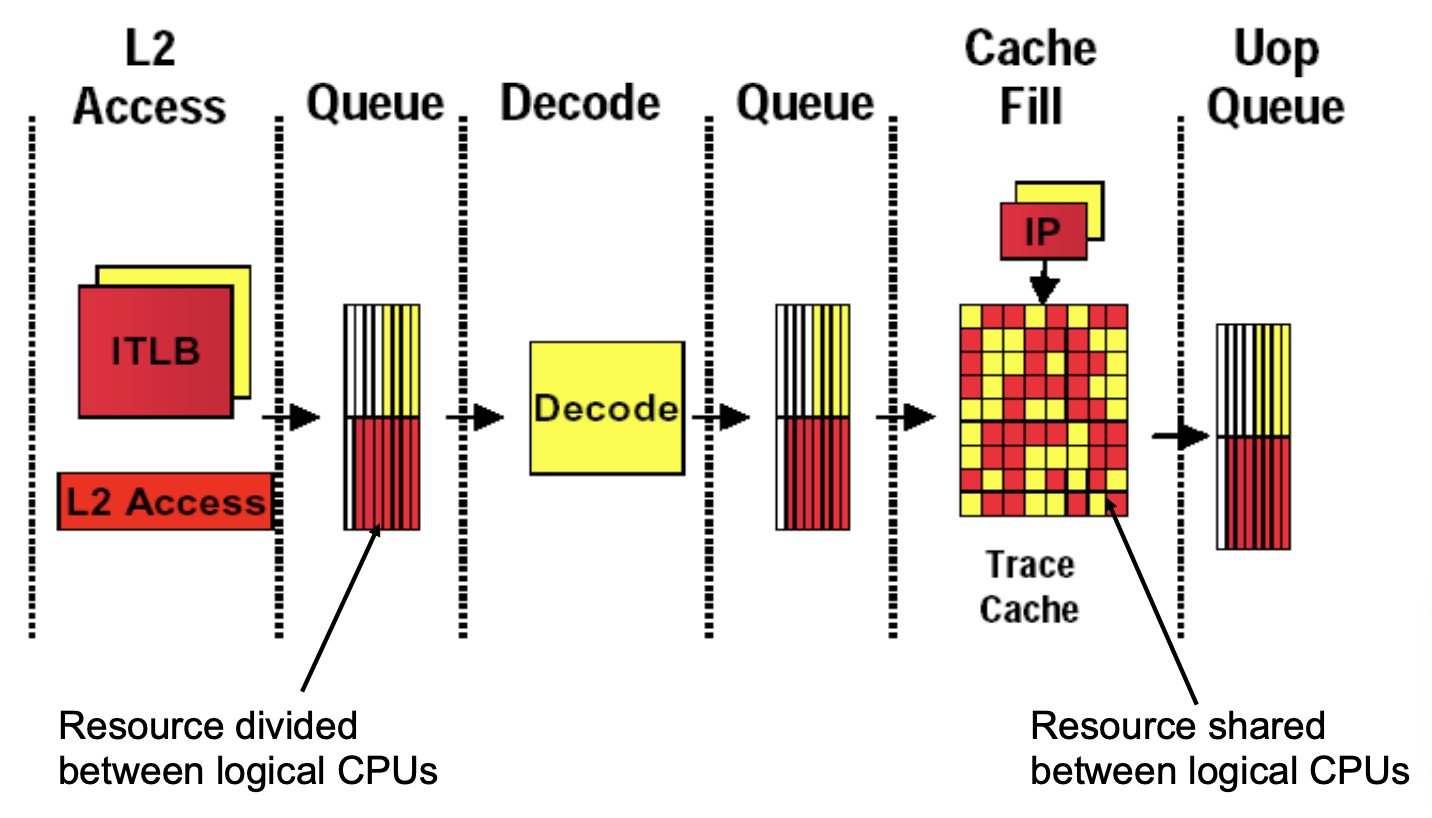
分支预测
为什么要独立的返回地址栈
解释: 在程序执行过程中,函数调用和返回会使程序跳转到不同的地址。返回地址栈用于存储函数返回地址,以便在函数结束时能够正确返回调用点。在多线程环境中,如果多个线程共享同一个返回地址栈,那么一个线程的函数返回地址可能会被另一个线程的函数调用覆盖,导致错误的返回地址和程序崩溃。
为什么要有独立的一级全局分支历史表?
解释: 分支预测依赖于分支历史信息来预测未来的分支走向。一级全局分支历史表记录了最近的分支走向历史。在多线程环境中,如果多个线程共享同一个一级全局分支历史表,不同线程的分支历史会相互干扰,导致预测准确性下降。
为什么共享的二级分支历史表,并标记逻辑处理器 ID?
解释: 二级分支历史表(通常是一个模式历史表)用于存储模式和相应的分支结果。通过共享二级分支历史表,可以减少硬件资源开销,提高资源利用率。但是,为了防止不同线程的分支历史相互干扰,需要使用逻辑处理器 ID 对条目进行标记,以区分不同线程的分支历史。
执行流水型
硬件多线程与超线程架构全景总结
多线程技术是计算机架构的交叉枢纽,它将流水线与超标量技术与 GPU、多处理器系统紧密联结。每个硬件线程具备独立的架构状态与当前 PC,在共享功能单元上实现指令级与线程级并行的统一调度。
同时多线程(SMT)与单核利用率的权衡本质
超标量处理器的核心矛盾在于:受限于单线程的控制与数据依赖(ILP 有限),即便硬件配备了 4 到 8 发射的宽数据通路,典型 IPC 也往往仅在 1 到 2 之间徘徊,导致大部分功能单元处于空闲状态。同时多线程(SMT)的精髓在于用「线程级并行(TLP)」去填补「指令级并行(ILP)」留下的水平气泡(发射槽未满)与垂直气泡(流水线全停顿)。
然而,SMT 绝非免费午餐。多个线程共享执行单元与各级缓存,极易引发缓存污染(Cache Thrashing)与执行队列的资源争用。当一个线程发生 L2/L3 缓存缺失持续停顿,若硬件调度不当允许其继续霸占重排序缓冲(ROB)或保留站表项,就会反向饿死另一个正在顺畅执行的线程。因此,现代高性能 SMT 架构必须引入自适应流控机制(如 ICOUNT 策略),动态惩罚停顿线程并优先服务健康线程,在资源共享与性能隔离之间维持脆弱而高效的平衡。