
Lec 21容器与虚拟机
摘要
论文阅读: Blending Containers and Virtual Machines: a study of Firecracker and gVisor (VEE 2020)
Lec 21 容器与虚拟机
本讲导览
-
虚拟机
-
trap-and-emulate 虚拟化
-
硬件虚拟化(Intel VT-x / VMX)
-
论文阅读: Dune
-
论文阅读: Blending Containers and Virtual Machines: a study of Firecracker and gVisor (VEE 2020)
我们以《Blending Containers and Virtual Machines: a study of Firecracker and gVisor》这篇论文为例。
这篇论文目的是,对不可信的代码进行”监禁“。OS 的隔离是基于 内核 + 进程 + 虚拟内存的,一旦内核被攻破,隔离就会失效。现代 OS 提供了丰富的系统调用接口,这些系统调用可能涉及许多共享命名空间(如文件系统、PID 等)。 论文调研了用于实现更强隔离的技术,目标是减少对系统调用和命名空间的访问。
论文动机来自这样的场景,租户向提供商提供 APP,提供商希望在同一台服务器上运行多个应用,以提高资源的利用率;这样带来隔离的挑战,代码来源是任意,需要隔离不同的租户;同时也带来性能挑战,负载可能变化很大,且变化可能很快,需要快速启动新实例。许多具体的隔离技术也在更广泛的场景中使用,如 Android 手机、Web 服务器、Chrome 浏览器以及 OpenSSH 等
隔离方法大致有:
- 使用
chroot把进程的根目录改为某个子目录<dir>,让进程只能看到这个目录下的文- 缺点:容易被逃逸,比如符号链接和
..; 仅仅适用于文件系统,许多系统调用仍可以访问其他共享资源,比如kill <pid>
- 缺点:容易被逃逸,比如符号链接和
- 容器技术。使用 Linux 命名空间,控制进程能看到的资源(文件、PID、网络、用户);用
cgroups控制进程能使用的资源量(CPU、内存、IO 等)- 粗粒度隔离,不受应用行为影响
- 用户态内核 / “库操作系统”(gVisor、Drawbridge),把系统调用处理搬到用户态的“轻量内核”中(Sentry);应用的 syscall 不直接进入 Linux 内核,而先被用户态内核处理
- 虚拟机技术 每个应用运行在独立的客体操作系统(guest OS)中,客体 OS 通过虚拟化层(hypervisor)访问物理硬件
我们知道,Linux 进程提供了文件访问权限,针对不同的用户 ID 可以设置不同的权限,由此实现用户之间的共享,很难仅靠此在两个应用之间强制隔离,应用可能会意外或故意创建共享文件。系统调用通过命名来访问共享状态,比如 PID、文件名、IP 地址 / 端口,甚至是某种形式的用户 ID。
命名空间提供了系统调用可命名资源的作用域,每个进程属于特定的命名空间,新进程继承父进程的命名空间,命名空间类型可以是 PID、IPC(共享内存等)、NET、UTS(主机名)、USER 等, 比如,PID 命名空间限制进程可以使用的 PID,这种方法,可以看作是更好的 chroot,适用于不同资源类型(不仅仅是文件系统)。
进程在监禁环境中仍可能需要运行动态链接库、配置文件(如时区),可能需要 Python 解释器或者其他程序,也就是说,需要一个 Linux 环境。解决方案就是使用 OCI(Open Container Initiative)提供的标准容器格式,这是流行的做法,Linux 容器、gVisor 和 Firecracker 都使用它。
Linux 容器而言,通过 namespace 控制可见的文件、进程等,每个进程有自己的容器镜像(Linux 环境),用 Cgroups 控制资源使用实现性能隔离。”容器“可以指容器镜像,也可以容器隔离技术,即基于命名空间和 cgroups 两种 Linux 机制实现隔离的技术。 通过 cgroups 技术限制资源的使用,适用于进程,新进程继承父进程的 cgroups,它并不是安全边界、但对防止 Dos 攻击很重要,例如,一个进程或虚拟机尝试占用全部 CPU 或内存
为什么命名空间/容器可能仍不够?
Solution:
- Linux 内核是共享的
- 攻击面大:350+ 系统调用,许多 ioctl 专用函数
- 内核代码量大,用 C 写,缓冲区溢出、使用后释放等漏洞仍在被发现;内核内部没有隔离
- 内核漏洞可能让攻击者逃脱隔离(本地权限提升 LPE),相对常见,每年都会有新的 LPE 漏洞
一种安全机制:seccomp-bpf,它为每个进程绑定一个过滤器,这个过滤器是一个小程序(用 BPF 写的),每次进程调用 syscall 时,先经过 filter,由 filter 决定 allow 还是 deny,或者是做其他处理(如kill进程)。 filter 可以看 syscall 编号(比如 open、read、kill等)以及参数(打开哪个文件),子进程会继承 filter(sticky),在 syscall 进入内核之前执行。
Linux kernel 攻击面太大,350+个系统调用,ioctl 更加复杂,很多冷门的 syscall 更容易有 bug。seccomp的思路是:既然内核太大,就少用它,例如禁止ptrace、禁止mount以及冷门 的 syscall,这样攻击者就少了很多入口。但是这样可能会带来兼容性问题,并且核心问题也没解决,常用的 syscall 还是很复杂,seccomp 只是减少入口,但没有减少内核代码复杂度。
论文提供了一个思路,为了让应用必须还能正常运行,由真正减少可用 syscall,那就不要让应用直接调用 Linux kernel。
虚拟机
什么是虚拟机
是计算机的模拟器, 精确到可以运行操作系统。
+-------------------+
|      应用         |
|    (App1, App2)   |
+--------+----------+
         |
+--------v----------+
|     客户操作系统  |
|    (Guest OS)     |
|     (Linux)       |   通过Guest Supervison
+--------+----------+
         |
+--------v----------+
|     虚拟机监控器  |
|  (Virtual Machine |
|   Monitor, VMM)   |
+--------+----------+
         |
+--------v----------+
|      硬件         |
|   (Hardware)      |
+-------------------+
VMM 的两种实现方式
- 独立运行的 VMM
- 在宿主操作系统(例如 Linux)上运行的 VMM
使用虚拟机的动机
- 云计算:在每台物理机器上运行许多小型客户虚拟机实例。
- 每个客户可以在他们的虚拟机中运行任何操作系统等。
- 隔离用户:即使在同一台机器上,也能将客户彼此隔离。
- 每个服务一个实例:简化管理。
- 控制和调整资源:内存、CPU、磁盘、网络流量等资源的管理。
- 迁移、挂起/恢复、备份。
- 软件开发人员:
- 虚拟 "崩溃" 盒子,用于测试。
我们为什么要学习虚拟机?
VMM 和操作系统内核有很多共同点,并且 OS 设计中的大部分已经转移到了虚拟机上,并且虚拟机已经影响到了操作系统(上层)和硬件(下层)
虚拟机的历史
- 1960 年代,IBM 使用虚拟机来共享昂贵的大型计算机。
- 1980 年代,计算机变得小巧且廉价,机房变得拥挤。
- 1990 年代, VMWare 再次普及了虚拟机技术,用于 x86 硬件
- 2000 年代,虚拟机在云计算和企业中被广泛使用
虚拟机需要多精确?
- 通常的目标是 100%的准确性
- 这样可以在不修改的情况下启动任何客户操作系统
- 并且防止恶意客户逃逸出虚拟机
- 在实际应用中,虚拟机监控器(VMM)和操作系统常常合作
- 例如,VMM 提供特定的磁盘/网络“设备”,客户操作系统可以识别并使用这些设备
我们可以通过编写软件来模拟机器指令来构建虚拟机。
- VMM 解释每条客户指令
- 维护客户的虚拟机状态
- 例如,32 个寄存器、satp、模式、RAM、磁盘等
- 优点:这种方法可行,例如 qemu
- 缺点:速度慢。在云计算上面这样运行显然不合适。
能不能直接在 CPU 上执行客户内核的特权指令?
不能给客户内核直接访问超级用户寄存器。
用户模式执行客户机内核指令
类似于将客户内核作为一个 xv6 进程运行。当然,客户内核假设它在超级用户模式下。
普通指令
普通指令可以正常工作,例如:
- 两个寄存器相加
- 函数调用等
特权指令
RISC-V 指令在特权用户模式下是非法的,会导致陷入(trap)到 VMM。
VMM 陷入处理器
VMM 的陷入处理器模拟特权指令:
- 可能会将特权操作应用到虚拟状态,例如读/写
sepc,并把它写入到 trapframe 返回 - 可能会转换并应用到真实硬件,例如对
satp的赋值
这种方法称为“陷入和模拟” (trap-and-emulate)。
优点
- 你可以完全通过软件构建这样的虚拟机
- 也许可以将 xv6 转变为一个用于 RISC-V 的陷入和模拟 VMM
"陷入和模拟" VMM 需要“虚拟化”哪些 RISC-V 状态?
- 所有“特权的 CPU 状态”
- 客户内核它可以读/写的 CPU 状态
- 这些状态在用户模式下是禁止访问的(VMM 需要保护这些状态以确保安全)
- 所有的 s* 寄存器(在 VMM 内部用一个列表维护)
- sepc: (异常程序计数器)
- stvec: (陷入向量基地址寄存器)
- scause: (陷入原因寄存器)
- satp 等: (超级地址转换和保护寄存器)
- 所在的 mode(是客户用户模式,还是用户超级管理员模式)
- hart 编码:每个硬件线程(hart)的编号也需要被虚拟化,以确保多线程环境下的正确性
- 页表: 虚拟内存管理依赖于页表,VMM 需要管理和虚拟化客户内核的页表。
- Platform-Level Interrupt Controller (PLIC) 、Core Local Interruptor (CLINT),平台级中断控制器(PLIC)和核心本地中断控制器(CLINT)需要被虚拟化,以管理中断和定时器
- (32 个寄存器和内存已经被虚拟化,无需额外处理)
下面分情况讨论在“trap-and-emulate”中,各种情况的操作:
-
当客户机的用户代码执行 ecall 系统调用时
-
CPU 会陷入到 VMM(ecall 总是生成一个 trap)。
-
VMM 的陷阱处理程序会:
-
检查客户端指令。
-
将虚拟的 sepc(异常指令地址)设置为实际的 sepc。
-
将虚拟的 mode 设置为 supervisor(监管模式)。
-
将虚拟的 scause(异常原因)设置为"system call"。
-
将实际的 sepc 设置为虚拟的 stvec(异常入口地址)。
-
修改(实际的)页表,为非 PTE_U 条目设置 PTE_V。
-
从陷阱中返回。
-
-
-
当客户端内核读取 scause(例如,csrr a0, scause)时:
-
CPU 会陷入到 VMM(因为 csrr 是特权指令)。
-
VMM 的陷阱处理程序会:
-
检查客户端指令。
-
将陷阱帧的 a0 寄存器设置为虚拟的 scause。
-
将实际的 sepc 增加 4。
-
从陷阱中返回。
-
-
-
当客户端内核执行 sret(返回到用户模式)时:
-
CPU 会陷入到 VMM。
-
实际上这是从用户模式到监管模式的陷阱。
-
硬件会将客户端的 PC 保存在实际的 sepc 中。
-
VMM 的陷阱处理程序会:
-
将虚拟的模式设置为用户模式。
-
将实际的 sepc 设置为虚拟的 sepc。
-
修改(实际的)页表,清除非 PTE_U 条目的 PTE_V。
-
从陷阱中返回。
-
-
-
当客户端内核写入 satp 时:
-
VMM 必须确保客户端只能访问自己的内存,并重新映射客户端物理地址。
-
VMM 会设置一个“影子”页表,该页表从客户端的页表派生而来。
-
客户端的页表映射为:
- 客户端虚拟地址(VA) -> 客户端物理地址(PA)
-
VMM 为该客户端设置的映射为:
- 客户端物理地址(PA) -> 主机物理地址(PA)
-
VMM 的“影子”页表为:
- 客户端虚拟地址(VA) -> 主机物理地址(PA)
-
VMM 会将影子页表安装到实际的 satp 中。
-
除此之外我们还有两大内容没有涉及,一个是关于页表, 一个是关于设备
内存虚拟化
VMM 会负责给每个运行的客户机实例分配一个独立的页表,称为“影子”页表,用于将客户机的虚拟地址(Guest Virtual Address, GVA)映射到宿主机的物理地址(Host Physical Address, HPA),客户机操作系统维护其自己的页表,将其虚拟地址(GVA)映射到客户机的物理地址(Guest Physical Address, GPA) ,VMM 本身
当虚拟机内存访问时
- 访问的是客户机的 GVA
- VMM 拦截客户机的内存访问请求,并使用影子页表将 GVA 转换为宿主机的 HPA,以实际执行内存访问
当客户端内核修改活跃页表中的页面表项(PTE)时
- VMM 不需要立即做任何操作,PTE 不会立即生效,直到执行
sfence.vma指令 - 当客户端内核执行
sfence.vma指令时,会陷入到 VMM - VMM 的处理程序会
- 检查并解释
sfence.vma的效果 - 生成一个新的影子页表,来反映客户端内核对页表的修改
- 检查并解释
设备虚拟化
设备虚拟化策略
-
模拟 Emulation
- 目的: 使无感知的客户机操作系统能够运行。
- 方法:
- 拦截内存映射控制寄存器的读写操作。
- 通过标记这些页为无效,使得 VMM 能捕获页面错误。
- VMM 将页面错误(page fault)转换为对模拟设备状态的操作。
-
虚拟化设备(Virtual Devices)
- 要求: 客户机操作系统驱动程序,即客户机知道自己在 VM 中。
- 优点: 比拦截控制寄存器读写操作更加高效。
- 示例: xv6 的 virtio_disk.c,QEMU 将其转换为对文件 fs.img 的读写操作。
-
直通硬件(Pass-though )
- 方法:客户机操作系统直接访问设备硬件,无需拦截。
- 要求:通常需要设备的特定支持。
- 现代网卡具有每个 VM 单独的 DMA 环。
- 优点: 效率很高。
》
硬件支持的 x86 虚拟化
动机
- 提升性能。 软件虚拟化需要频繁陷入和退出 VMM,产生性能开销
- 增强安全性(提供根模式和非跟模式)。 确保了虚拟机之间和虚拟机与宿主机之间的隔离性
如何减少频繁陷入 vmm 呢?
想法:之前虚拟状态通过 VMM 存储(软件),硬件层面存储, 允许客户机执行特权指令而无需陷入。因此硬件虚拟化技术提供了一套完整的寄存器集,这些寄存器包括通用寄存器、控制寄存器、状态寄存器。 但是需要添加额外的检查机制免得让虚拟机滥用这些寄存器,影响到其他虚拟机。 guest mode 在这里被称为 non-root 非根模式。
VT-x/VMX/SVM: 硬件支持的虚拟化
虚拟机控制结构
在 VMM 内部有一段内存结构,是用来 VMM 与 VT-x 硬件通信和保存主机状态,称为VMCS(虚拟机控制结构)或者是 VM control,里面有很多设置,以及各种寄存器的初始值,该结构与虚拟机一一对应。
vmlaunch指令告诉这个地址,对应的虚拟机开始运行了;vmresume指令用于恢复一个已经暂停或停止的虚拟机vmcall用于虚拟机与 VMM 通信
虚拟机执行特权指令时通常需要引发 VM Exit,陷入到虚拟机管理程序,在特定情况下直接执行特权指令而不引发 VM Exit,这种情况被称为“intentional exit”(有意退出)。 当一个虚拟机触发中断时,VMM 可以将该中断虚拟化,并将其注入到目标虚拟机,而无需每次都引发 VM Exit。从客户机退出到主机时恢复宿主机状态,使客户机无法扰乱宿主机的特权状态。
产生的效果:
- 如果主机正确配置,客户机无法逃逸。
页表
既希望让客户机内核控制页表(CR3, 这是 x86 Intel 或者 AMD 等同于 RISC-V 的 SATP 寄存器),又希望限制客户机只能访问其允许的物理内存加载。硬件虚拟化技术提供了硬件辅助的嵌套分页(EPT),或者叫扩展页表,工作机制如下:
- MMU 在 VMX 客户机模式下有两层地址转换:
- 第一层,CR3 页表映射客户机虚拟地址 -> 客户机物理地址。
- 第二层,EPT 映射客户机物理地址 -> 主机物理地址。
- VMM 设置 EPT 仅包含客户机自身内存的映射。
- 客户机无法看到或改变 EPT。
产生的效果:
- 客户机可以自由读取/写入 %cr3、改变 PTE、读取 D 位等。
- VMM 仍然可以通过 EPT 提供隔离。
- CPU 将普通 (%cr3) 页表的页面错误传递给客户机。
- EPT 的页面错误强制退出到主机,客户机无法看到这些错误。
安全性
- 术语:
- 每个 CPU 处于 root 模式(运行 VMM,即主机)或非 root 模式(运行客户机:内核+用户进程)。
- 执行在两者之间来回切换。
- 特殊指令切换 VMX 模式:
- VMLAUNCH/VMRESUME:从主机切换到客户机。
- VMCALL:从客户机切换到主机。
- 某些事件也会强制客户机切换到主机("exit")。
- 客户机可能的恶意行为:
- 读取/写入其自身内存之外的内容。
- 与硬件设备通信或抢占中断。
- 以破坏主机 VMM 的方式修改控制寄存器。
设备和定时器中断
- CPU 强制客户机退出,传递中断给主机。
FQA
有没有一些例子需要在硬件的寄存器,而不在 VMM 的虚拟寄存器运行的客户内核指令?
有的,比如 SCAUSE 寄存器(陷入原因寄存器),VMM 会通过硬件设置 SCAUSE,比如不合法的指令。
论文阅读: Dune
利用 Intel VT-x 虚拟化技术提供进程的抽象,有趣的是硬件虚拟化并不是用在这个场景的,而是用在对虚拟机的支持上。
本讲导览
Dune 是一个系统,为应用程序提供直接但安全的访问硬件功能,例如环、ring 保护、页表和标记的 TLB,同时保留了现有的进程操作系统接口。Dune 利用现代处理器中的虚拟化硬件,提供了进程级别的抽象,而不是机器级别的抽象。它包括一个小型内核模块,初始化虚拟化硬件并协调与内核的交互,以及一个用户级别的库,帮助应用程序管理特权硬件功能。我们介绍了 Dune 在 64 位 x86 Linux 上的实现。我们使用 Dune 实现了三个用户级应用程序,这些应用程序可以从访问特权硬件中受益:一个用于不受信任代码的沙盒、一个权限分离设施和一个垃圾收集器。Dune 的使用极大简化了这些应用程序的实现,并提供了显著的性能优势。
1. 引言
许多应用程序可以通过访问”仅内核“(原本只能通过内核才能访问的)硬件功能获益。例如,
- Azul Systems 通过使用分页硬件显著加快了垃圾收集速度 [15, 36]。
- 进程迁移,虽然可以在用户程序内实现,但通过访问页错误 [40] 和系统调用 [32] 可以显著提升性能
- 在某些情况下,甚至可能需要完全替换内核以满足特定应用程序的需求。例如,IBOS 通过将浏览器抽象层移到最低的操作系统层来提高浏览器安全性 [35]。
这些系统需要在内核中进行更改,因为出于安全和隔离的考虑,用户空间对硬件访问受到限制。然而,实际上修改内核并不理想,因为内核更改可能会相当入侵性,并且如果执行不当,可能会影响整个系统的稳定性。此外,如果多个应用程序需要内核更改,不能保证这些更改能够兼容。
另一种策略是将应用程序打包成带有专用内核的虚拟机镜像。许多现代 CPU 包含虚拟化硬件,使得客户操作系统可以安全高效地访问内核硬件功能。此外,虚拟机提供类似进程的故障隔离能力,即有错误或恶意行为不应导致整个物理机器崩溃。
然而,虚拟机与主机操作系统的集成性较差。进程期望从其父进程继承文件描述符,生成其他进程,与其父子进程共享文件系统和设备,并使用 IPC 服务(如 Unix 域套接字)。将进程移至虚拟机,例如为了加速垃圾收集,很可能会破坏许多假设,并且可能并不值得麻烦。此外,为应用特定的虚拟机生产内核并非易事。像 Linux 这样的生产内核非常复杂且难以修改。然而,实现一个具有简单虚拟内存层的专用内核也是具有挑战性的。除了虚拟内存外,还必须支持文件系统、网络堆栈、设备驱动程序和引导进程。
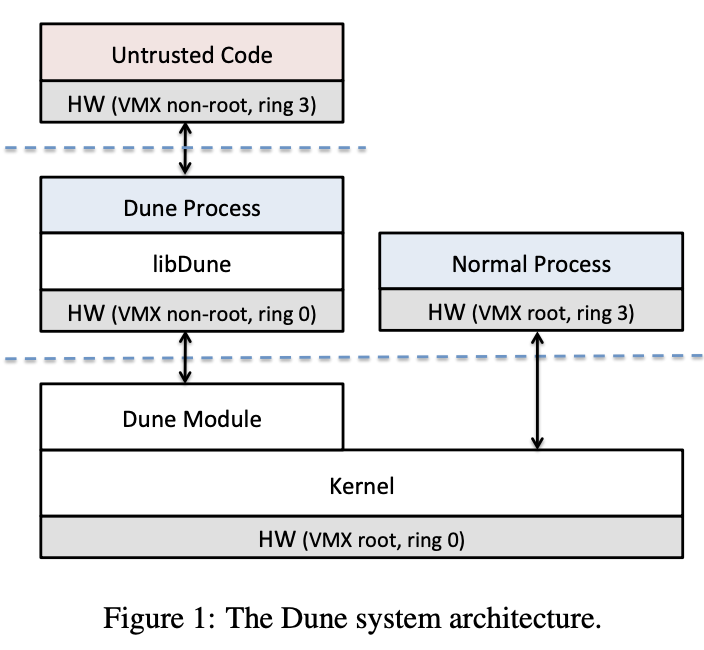
这篇论文介绍了一种新的应用内核硬件功能的方法:利用虚拟化硬件提供进程级别的抽象,而不是机器级别的抽象。我们在 64 位 Intel CPU 上实现了这种方法,称为Dune系统。Dune 提供了一个可加载的内核模块,可以与未修改的 Linux 内核配合使用。该模块允许进程进入“Dune 模式”,这是一个不可逆转的转换,在此模式下,通过虚拟化硬件可以安全且快速地访问特权硬件功能,包括特权模式、虚拟内存寄存器、页表以及中断、异常和系统调用向量。我们提供了一个用户级库 libdune,以便更容易地使用这些功能。
对于符合其范式的应用程序,Dune 相比虚拟机提供了几个优势。首先,Dune 进程是一个普通的 Linux 进程,唯一的区别在于它使用VMCALL指令调用系统调用。这意味着 Dune 进程可以完全访问系统的其余部分,并且是其不可或缺的一部分,同时 Dune 应用程序开发起来也很容易(类似于应用程序编程,而不是内核编程)。其次,由于 Dune 内核模块并不试图提供机器级别的抽象,因此模块可以更简单且更快速。特别是,虚拟化硬件可以配置为避免保存和恢复虚拟机所需的多个硬件状态片段。
通过 Dune,我们做出了以下贡献:
- 我们提出了一种设计,利用硬件辅助虚拟化安全高效地向用户程序公开特权硬件功能,同时保留标准操作系统抽象。
- 我们详细评估了三个硬件功能,并展示了它们如何为用户程序带来好处:异常处理、分页和特权模式。
- 我们通过实现和评估三个用例(沙盒、特权分离和垃圾收集)展示了 Dune 的端到端实用性。
2. 虚拟化和硬件
在整篇论文中,我们以 x86 CPU 和 Intel VT-x 来描述 Dune。然而,这并不是我们设计的基础,在第 7 节中,我们扩展讨论到未来可能支持的其他架构。
2.1 Intel VT-x 扩展
为了提高虚拟化性能并简化 VMM(虚拟机监视器)实现,Intel 开发了 VT-x 这是 x86 ISA 的虚拟化扩展 [37]。AMD 也提供了类似的扩展,其硬件接口称为 SVM [3]。
适应硬件以支持虚拟化的最简单方法是引入一种机制来捕获访问特权状态的每条指令,以便 VMM 可以进行仿真。VT-x 采用了一种更复杂的方法,受 IBM 的解释执行架构 [31] 启发,尽可能多地执行访问特权状态的指令,其中大部分直接在硬件中执行,无需 VMM 干预。这种方法的动机在于提高性能,因为 trap 可以是性能开销的一个重要来源。
VT-x 采用了一种设计,其中 CPU 分为两种操作模式:VMX 根(root)模式和 VMX 非根(non-root)模式。VMX 根模式通常用于运行 VMM,并且不改变 CPU 行为,除了启用管理 VT-x 的新指令。另一方面,VMX 非根模式限制 CPU 行为,适用于运行虚拟化的客户操作系统。
VMX 模式之间的转换由硬件管理。当 VMM 执行 VMLAUNCH 或 VMRESUME 指令时,硬件执行 VM 进入操作;将 CPU 置于 VMX 非根模式并执行客户操作系统。然后,当需要 VMM 的操作时,硬件执行 VM 退出操作,将 CPU 置于 VMX 根模式并跳转到 VMM 的入口点。硬件在这两种转换期间自动保存和恢复大部分体系结构状态,这通过使用内存中的数据结构 VM 控制结构(VMCS)中的缓冲区来实现。
除了存储体系结构状态外,VMCS 还包含许多配置参数,允许 VMM 控制执行并指定哪些类型的事件应该生成 VM 退出。这使得 VMM 能够在确定哪些硬件应该向客户公开时具有相当大的灵活性。例如,VMM 可以配置 VMCS,使得 HLT 指令导致 VM 退出,或允许客户操作系统停止 CPU。然而,某些硬件接口(如中断描述符表(IDT)和特权模式)在 VMX 非根模式下隐式公开,并且在访问时不会生成 VM 退出。此外,客户操作系统可以通过使用 VMCALL 指令手动请求 VM 退出。
虚拟内存可能是 VMM 安全地暴露的最困难的硬件功能。一个简单的解决方案是配置 VMCS,使客户操作系统可以访问页表根寄存器%CR3。然而,这将完全信任客户操作系统,因为它可以配置页表以访问任何物理内存地址,包括属于 VMM 的内存。幸运的是,VT-x 包括一个专用的硬件机制,称为扩展页表(EPT),可以强制执行对具有直接访问虚拟内存的客户操作系统的内存隔离。AMD 的 SVM 也包括类似于 EPT 的机制,称为嵌套页表(NPT)。
4. 用户模式环境
论文阅读:结合容器和虚拟机的容器技术
在无服务器计算中,提供商会部署应用代码并动态管理资源分配,从而将基础设施管理从应用开发中剥离出来。
无服务器提供商可以选择多种虚拟化平台来隔离函数,从原生 Linux 进程,到 Linux 容器,再到轻量级隔离平台,例如 Google gVisor 和 AWS Firecracker。这些平台形成了一个连续谱系(spectrum),随着功能从宿主内核迁移到隔离的客户环境中而变化。例如,gVisor 会在用户态的 Sentry 进程中处理许多系统调用,而 Firecracker 则在每个微虚拟机(microVM)中运行完整的客户操作系统。这些平台的共同目标是强隔离和高性能。
在本文中,我们对 Linux 容器(LXC)、gVisor 安全容器和 Firecracker 微虚拟机进行了对比研究,以了解它们如何不同地使用 Linux 内核服务:它们对宿主内核功能的使用程度有多大差异?我们还通过一系列针对不同内核子系统的微基准测试评估了这些设计的性能开销。
我们的结果显示,尽管将大量功能从内核中移出,Firecracker 和 gVisor 实际执行的内核代码量仍远高于原生 Linux。gVisor 与 Linux 容器执行的代码大体相同,但执行频率有所不同。