
Lec 20多核可扩展性 & RCU
摘要
阅读资料:RCU Usage In the Linux Kernel: One Decade Later, 2013
Lec 21 多核可扩展性 & RCU
[toc]
阅读资料:RCU Usage In the Linux Kernel: One Decade Later, 2013
如何在多核 CPU 计算机上获得好的性能,这是一个非常有趣,深入且令人着迷的话题。今天我们只会涉及这个话题的很小的一个部分,也就是在面对内核中需要频繁读但是不需要频繁写的共享数据时,如何获得更好的性能?
我们今天要看的是Linux 的 RCU,它对于需要频繁读的内核数据来说是一种非常成功的方法。
问题背景
一个现代的计算机,包含多个并行运行的 CPU 核,这些 CPU 核共享着内存数据。
如果你在内核中有大量的进程,在不做任何额外工作的前提下,这些进程极有可能是并行运行的。但另一方面,如果你有很多应用程序都在执行系统调用,很多时候,不同的应用程序执行的不同系统调用也应该是相互独立的。
但问题是内核中包含了大量的共享数据。出于一些其他的原因,内核共享了大量的资源,例如内存,CPU,磁盘缓存,inode 缓存,这些东西都在后台被不同的进程所共享。这意味着,即使两个完全不相关的进程在执行两个系统调用,如果这两个系统调用需要分配内存或使用磁盘缓存或者涉及到线程调度决策,它们可能最终会使用内核中相同的数据结构,因此我们需要有办法能让它们在使用相同数据的同时,又互不影响。
在过去的许多年里,人们付出了巨大的努力来让内核中的这些场景能更快的运行。我们之前看过其中一种可以保证正确性的方法,也就是 spinlock。spinlock 很直观,它的工作就是当两个进程可能会相互影响时,阻止并行运行。所以 spinlock 的直接效果就是降低性能。它使得正确性有了保障,但是又绝对的阻止了并行执行。
我将使用单链表来作为主要的例子。尽管我们关注的主要是读操作,我们也需要关心写操作,我们需要保证读操作在面对写操作时是安全的。
读写锁的局限性
但是使用锁有个缺点,如果通常情况下没有修改数据的线程,那么意味着每次有一个读取数据的线程,都需要获取一个排他的锁。因此出现了读写锁,一种允许多个线程读和一个线程写。正是因为它的不足促成了对于 RCU 的需求。
// 读写锁接口
// for reader
r_lock(l);
r_unlock(l);

// for writer
w_lock(l);
w_unlock(l)
读写锁排除了某人获取了数据的写锁,同时又有别人获取读锁的可能性。你要么只有一个数据写入者,要么有多个数据 Reader ,不可能有别的可能。
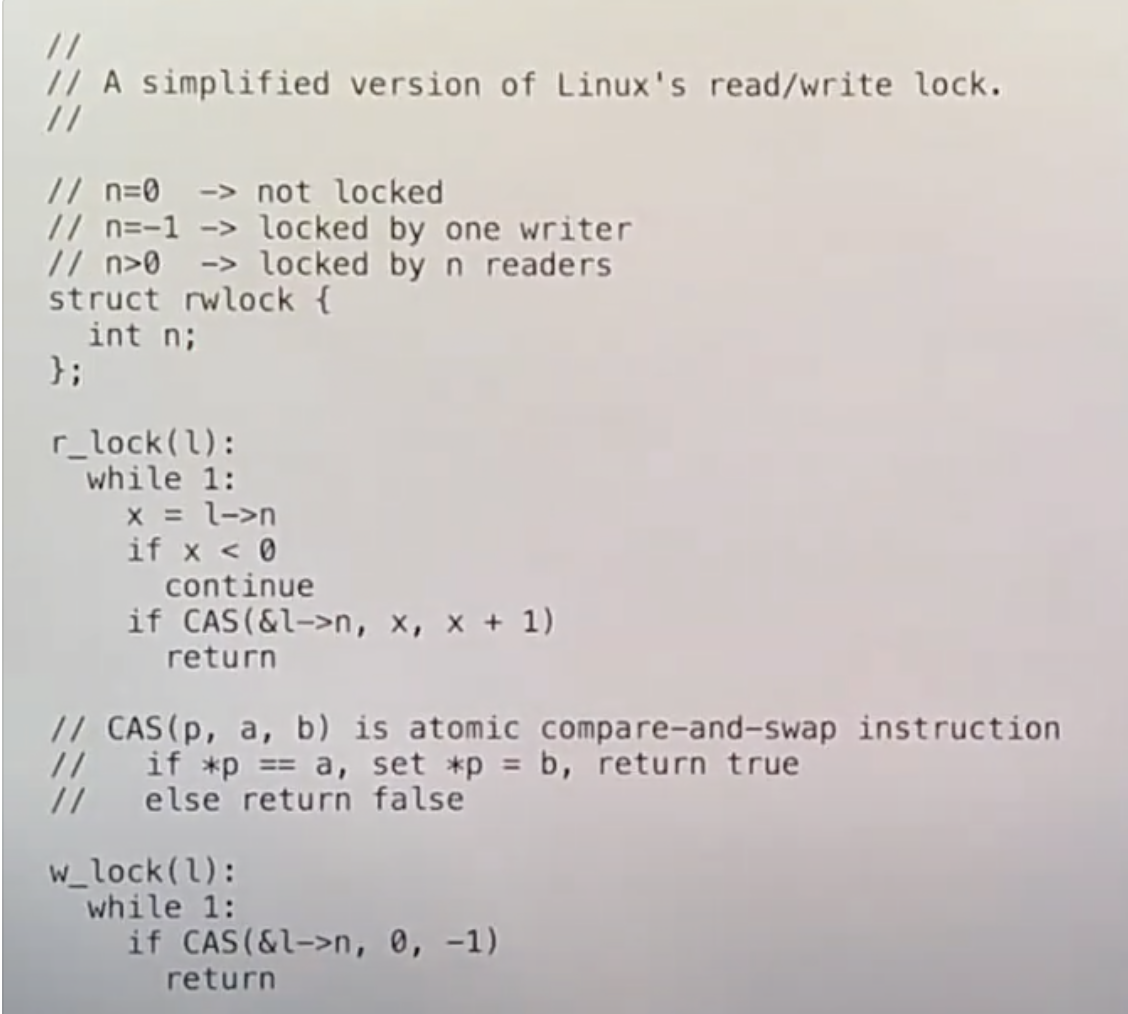
实际上如果你深入细节,你会发现当你使用读写锁时,尤其对于大部分都是读取操作的数据结构,会有一些问题。为了了解实际发生了什么,我们必须看一下读写锁的代码实现。
[!NOTE]
CAS 的原子语义
CAS 接收三个参数,第一个参数是内存的某个地址,第二个参数是我们认为内存中该地址持有的数值,第三个参数是我们想设置到内存地址的数值。CAS 的语义是,硬件首先会设置一个内部的锁,使得一个 CAS 指令针对一个内存地址原子的执行;之后硬件会检查当前内存地址的数值是否还是 x;如果是的话,将其设置为第三个参数,也就是 x+1,之后 CAS 指令会返回 1;如果不是的话,并不会改变内存地址的数值,并返回 0。
为什么这里要用本地变量? .e.g.
x = l->n
Solution:因为 n 可能在任意时间被修改,所以我们需要在最开始在本地变量 x 中存储 n 的一个固定的值。▯
并行读结果
假设 n 从 0 开始,当两个r_lock同时调用时,我们希望当两个r_lock都返回时,n 变成 2。 因为我们希望两个数据 Reader 可以并行地使用数据。两个r_lock在最开始都将看到 n 为 0,并且都会通过传入第二个参数 0,第三个参数 1 来调用 CAS 指令,但是只有一个 CAS 指令能成功。CAS 是一个原子操作,一次只能发生一个 CAS 指令。不管哪个 CAS 指令先执行,将会看到 n 等于 0,并将其设置为 1。另一个 CAS 指令将会看到 n 等于 1,返回失败,并回到循环的最开始,这一次 x 可以读到 1,并且接下来执行 CAS 的时候,第二个参数将会是 1,第三个参数是 2,这一次 CAS 指令可以执行成功。
最终, 两次r_lock都能成功获取锁,其中一次r_lock在第一次尝试就能成功,另一次r_lock会回到循环的最开始再次尝试并成功。
缓存失效
在一个多核的系统中,每个 CPU 核都有一个关联的 cache,也就是 L1 cache。每当 CPU 核读写数据时,都会保存在 cache 中。除此之外,还有一些内部连接的线路使得 CPU 可以彼此交互,因为如果某个 CPU 核修改了某个数据,它需要告诉其他 CPU 核不要去缓存这个数据,这个过程被称为缓存失效(cache invalidation)
如果有多个数据 Reader 在多个 CPU 上同时调用r_lock,只有第一个调用 CAS 指令的 CPU 会修改l->n的内容。作为修改的一部分,它还需要使得其他 CPU 上的缓存失效。所以执行第一个 CAS 指令的 CPU 需要通过总线发送 invalidate 消息给其他每一个 CPU 核。 之后剩下的所有数据 Reader 都会回到循环的最开始,重复上面的流程,但这一次还是只有一个数据 Reader 能成功。
读锁成本
假设有 n 个数据 Reader ,那么每个r_lock平均需要循环 n/2 次,每次循环都涉及到 O(n)级别的 CPU 消息,因为至少每次循环中所有 CPU 对于l->n的 cache 需要被设置为无效。这意味着,对于 n 个 CPU 核来说,同时获取一个锁的成本是 O(),当你为一份数据增加 CPU 核时,成本以平方增加。
这是一个非常糟糕的结果,我们期望如果有 10 个 CPU 核完成一件事情,你将获得 10 倍的性能,尤其现在还只是读数据并没有修改数据。你期望它们能真正的并行运行。当有多个 CPU 核时,每个 CPU 核读取数据的时间应该与只有一个 CPU 核时读取数据的时间一致,这样并行运行才有意义,因为这样你才能同时做多件事情。但是现在,越多的 CPU 核尝试读取数据,每个 CPU 核获取锁的成本就越高。
只读数据本来可以直接从 CPU 缓存里读取,只需几十个周期。但读写锁却要求在 r_lock 时修改共享计数器 l->n,这会触发跨 CPU 的缓存一致性通信,代价可能高达数百甚至数千个周期,尤其在多核下成本呈 O() 增长。结果是,把一个本来很快的读操作,变成了昂贵的写共享数据操作。
因此问题的核心是:r_lock 对共享计数器的写操作让读不再是“真正的只读”。我们需要一种读操作完全不写共享数据的机制,才能发挥缓存的优势。
RCU 实现
我们接下来快速的看一下能不能让数据 Reader 在不上锁的时候直接读取链表。假设我们有个链表,链表元素中存的数据是字符串,我们将读取链表中的数据。如果没有数据的写入者,那么不会有任何问题。
接下来我们看一下存在数据写入者时的三种可能场景:
- 首先是数据的写入者只修改了链表元素的内容,将链表元素中的字符串改成了其他的字符串。
- 第二种场景是数据写入者插入了一个链表元素。
- 第三种场景是数据写入者删除了一个链表元素。
因为 RCU 需要分别考虑这三种场景,我们将会分别审视这三种场景并看一下同时发生数据的读写会有什么问题?
- 如果数据写入者想要修改链表元素内的字符串,而数据 Reader 可能正在读取相同字符串。如果不做任何特殊处理,数据 Reader 可能会读到部分旧的字符串和部分新的字符串。这是我们需要考虑的一个问题。
- 如果数据写入者正在插入一个链表元素,假设要在链表头部插入一个元素,数据写入者需要将链表的头指针指向新元素,并将新元素的 next 指针指向之前的第一个元素。这里的问题是,数据的写入者可能在初始化新元素之前,就将头指针指向新元素,也就是说这时新元素包含的字符串是无效的并且新元素的 next 指针指向的是一个无效的地址。这是插入链表元素时可能出错的地方。
- 如果数据写入者正在删除一个链表元素,我们假设删除的是第一个元素,所以需要将链表的头指针指向链表的第二个元素,之后再释放链表的第一个元素。这里的问题是,如果数据 Reader 正好在读链表的第一个元素,而数据写入者又释放了这个元素,那么数据 Reader 看到的是释放了的元素,这个链表元素可能接下来被用作其他用途,从数据 Reader 的角度来说看到的是垃圾数据。
假设数据写入者在完成任何操作前,都会使用类似 spinlock 的锁。我们不能直接让数据 Reader 在无锁情况下完成读取操作,但是我们可以修复上面提到的问题。RCU 是一种实现并发的特殊算法,它是一种组织数据 Reader 和写入者的方法,通过 RCU 数据 Reader 可以不用使用任何锁。RCU 的主要任务就是修复上面的三种数据 Reader 可能会陷入问题的场景,它的具体做法是让数据写入者变得更加复杂一些,所以数据写入者会更慢一些。除了锁以外它还需要遵循一些额外的规则,但是带来的好处是数据 Reader 因为可以不使用锁、不需要写内存而明显的变快。
修改场景下实现
第一个场景中,数据写入者会更新链表元素的内容。RCU 将禁止这样的行为,也就是说数据写入者不允许修改链表元素的内容。假设我们有一个链表,数据写入者想要更新链表元素 E2。
现在不能直接修改 E2 的内容,RCU 会创建并初始化一个新的链表元素。所以新的内容会写到新的链表元素中,之后数据写入者会将新链表元素的 next 指针指向 E3,之后在单个的写操作中将 E1 的 next 指针指向新的链表元素。
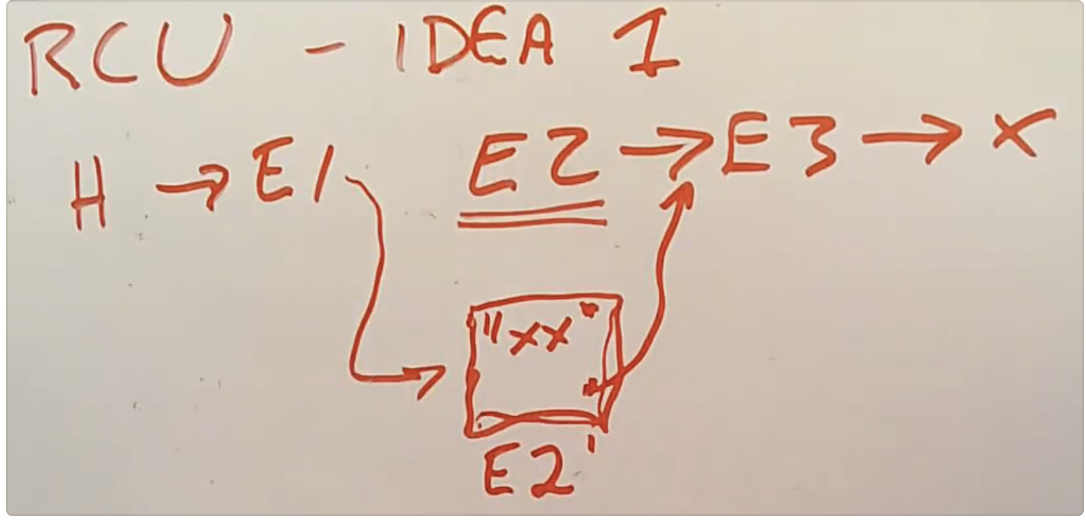
对于数据 Reader 来说,如果遍历到了 E1 并正在查看 E1 的 next 指针:
- 要么看到的是旧的元素 E2,这并没有问题,因为 E2 并没有被改变;
- 要么看到的是新版本的 E2,这也没有问题,因为数据写入者在更新 E1 的 next 指针之前已经完全初始化好了新版本的 E2。
不管哪种情况,数据 Reader 都将通过正确的 next 指针指向 E3。这里核心的点在于,数据 Reader 永远也不会看到一个正在被修改的链表元素内容。
旧的 E2 和 E3 之间的关系会被删除吗?
会被保留。这是个好问题,并且这也是 RCU 中较为复杂的主要部分,现在我们假设旧的 E2 被保留了。
需要释放旧的 E2 吗? 何时回收 E2?
这里的问题是,在我们更新 E1 的 next 指针时,部分数据 Reader 通过 E1 的旧的 next 指针走到了旧的 E2,所以当完成更新时,部分数据 Reader 可能正在读取旧的 E2,我们最好不要释放它。至于何时释放,继续阅读。
将 E1 的 next 指针从旧的 E2 切换到新的 E2, 我将其称为 committing write。这里能工作的部分原因是,单个 committing write 是原子的,从数据 Reader 的角度来说更新指针要么发生要么不发生。通过这一条不可拆分的原子指令,我们将 E1 的 next 指针从旧的 E2 切换到的新的 E2。写 E1 的 next 指针完成表明使用的是新版本的 E2。
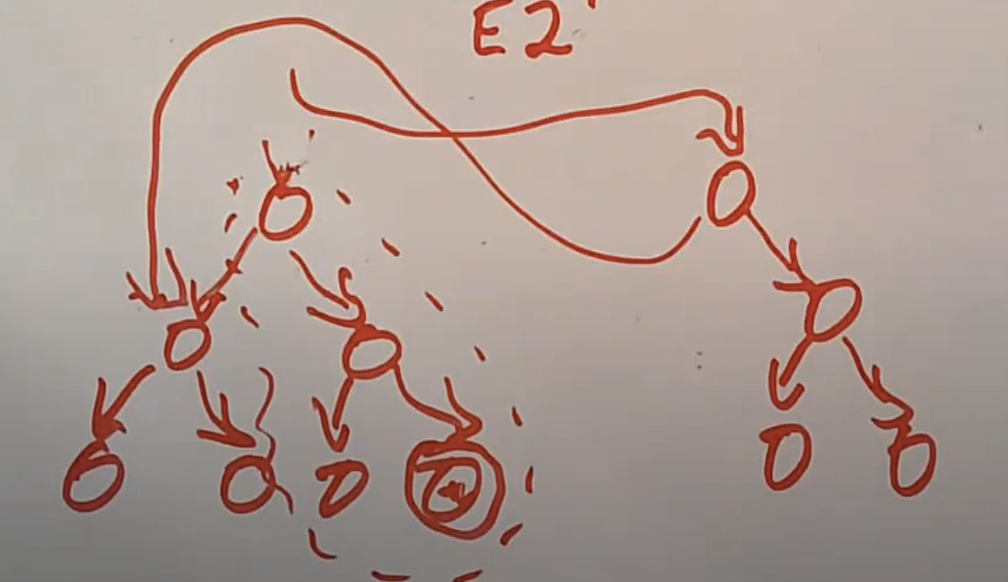
这是对于 RCU 来说一个非常基本同时也是非常重要的技术,它表示 RCU 主要能用在具备单个 committing write 的数据结构上。这意味着一些数据结构在使用 RCU 时会非常的奇怪,例如一个双向链表,其中的每个元素都有双向指针,这时就不能通过单个 committing write 来删除链表元素,因为在大多数机器上不能同时原子性的更改两个内存地址。所以双向链表对于 RCU 来说不太友好。相反的,树是一个好的数据结构。如果你有一个如下图的树:
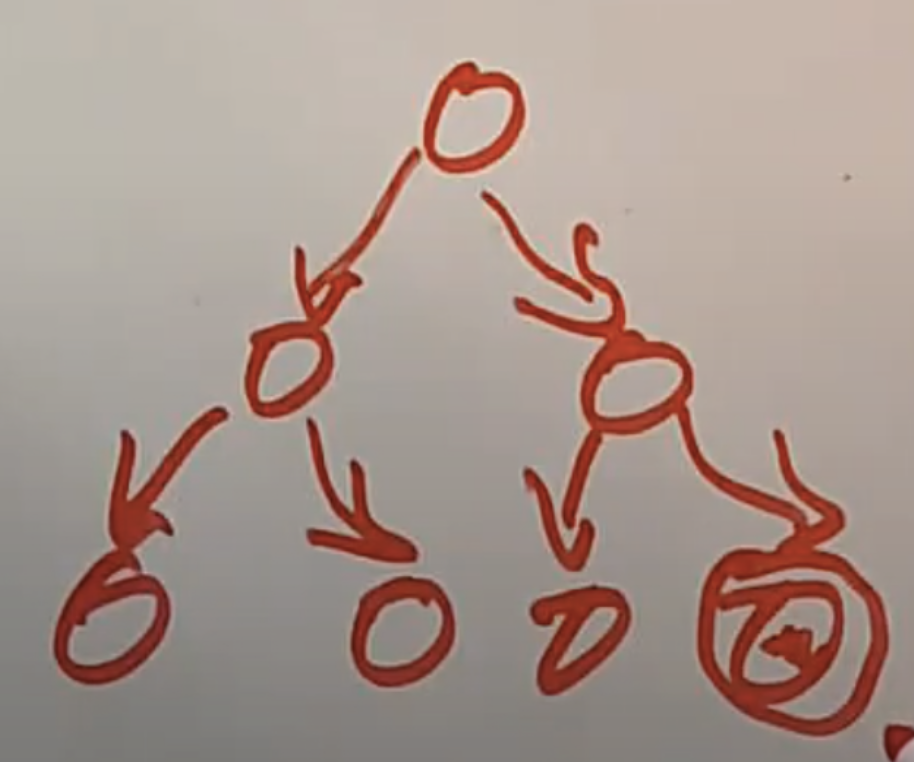
如果我们要更新图中的节点,我们可以构造树的虚线部分,然后再通过单个 committing write 更新树的根节点指针,切换到树的新版本。
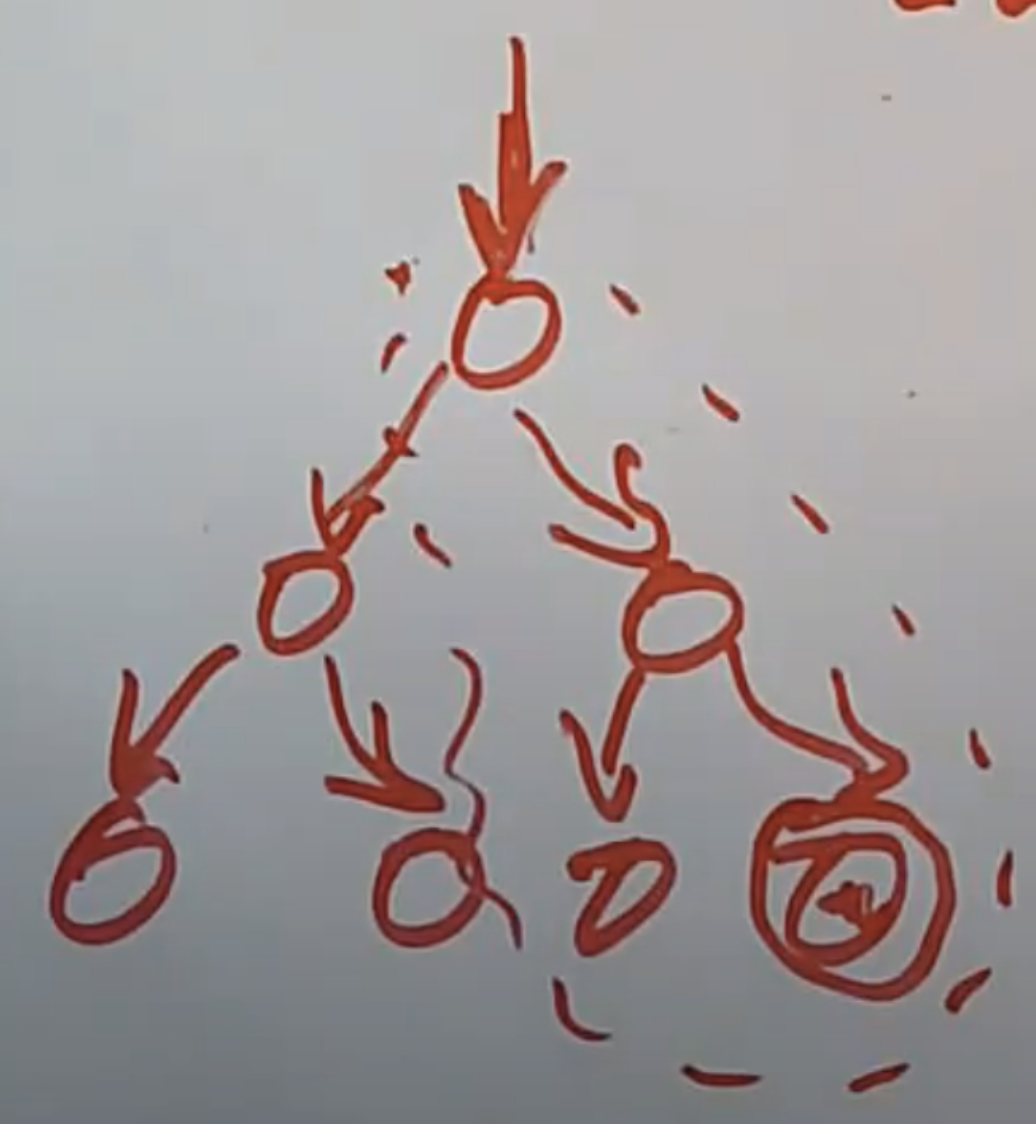
数据写入者会创建树中更新了的那部分,同时再重用树中未被修改的部分,最后再通过单个 committing write,将树的根节点更新到新版本的树的根节点。
写提交的实现
许多计算机中都不存在“之后”或者“然后”这回事,通常来说所有的编译器和许多微处理器都会重排内存操作。
e = alloc();
e->next = E2;
E1->next = e;
如果你测试这里的代码,它可能可以较好的运行,但是在实际中就会时不时的出错。这里的原因是编译器或者计算机可能会重排这里的写操作,也有可能编译器或者计算机会重排数据 Reader 的读操作顺序。如果我们在初始化 E2’的内容之前,就将 E1 的 next 指针设置成 E2‘,那么某些数据 Reader 可能就会读到垃圾数据并出错。
所以实现 RCU 的第二个部分就是数据 Reader 和数据写入者都需要使用 memory barriers,这里背后的原因是因为我们这里没有使用锁。对于数据写入者来说,memory barrier 应该放置在 committing write 之前
e = alloc();
e->next = E2;
// Barrier
E1->next = e;
这样可以告知编译器和硬件,先完成所有在 barrier 之前的写操作,再完成 barrier 之后的写操作。所以在 E1 设置 next 指针指向 E2‘的时候,E2’必然已经完全初始化完了。
对于数据 Reader ,需要先将 E1 的 next 指针加载到某个临时寄存器中,我们假设 r1 保存了 E1 的 next 指针,之后数据 Reader 也需要一个 memory barrier,然后数据 Reader 才能查看 r1 中保存的指针。
r1 = E1->next;
// Barrier
out1 = r1->x;
out2 = r1->next;
这里的 barrier 表明的意思是,在完成 E1 的 next 指针读取之前,不要执行其他的数据读取,这样数据 Reader 从 E1 的 next 指针要么可以读到旧的 E2,要么可以读到新的 E2‘。通过 barrier 的保障,我们可以确保成功在 r1 中加载了 E1 的 next 指针之后,再读取 r1 中指针对应的内容。
何时才能释放旧数据?
你可以想到好几种方法来实现这里的等待。
例如,我们可以为每个链表元素设置一个引用计数,并让数据 Reader 在开始使用链表元素时对引用计数加 1,用完之后对引用计数减 1,然后让数据写入者等待引用计数为 0。但是我们会第一时间就否定这个方案,因为 RCU 的核心思想就是在读数据的时候不引入任何的写操作,因为我们前面看过了,如果有大量的数据 Reader 同时更新引用计数,相应的代价将十分高。所以我们绝对不会想要有引用计数的存在。
另一种可能是使用自带垃圾回收(Garbage Collect)的编程语言。在带有 GC 的编程语言中,你不用释放任何对象,相应的 GC 会记住是否有任何线程或者任何数据结构对于某个对象还存在引用。如果 GC 发现对象不可能再被使用时,就会释放对象。这也是一种可能且合理的用来释放链表元素的方法。但是使用了 RCU 的 Linux 系统,并不是由带有 GC 的编程语言编写,并且我们也不确定 GC 能不能提升性能,所以这里我们也不能使用一个标准 GC 来释放 E2。
RCU 使用的是另一种方法,数据 Reader 和写入者都需要遵循一些规则,使得数据写入者可以在稍后再释放链表元素。规则如下:
- 数据 Reader 不允许在 context switch 时持有一个被 RCU 保护的数据的指针(注,是指线程切换的 context switch)。所以数据 Reader 不能在 RCU critical 区域内 yield CPU。
- 对于数据写入者,它会在每一个 CPU 核都执行过至少一次 context switch 之后再释放链表元素。
这里的第一条规则也是针对 spin lock 的规则,在 spin lock 的加锁区域内是不能出让 CPU 的。第二条规则更加复杂点,但是相对来说也更清晰,因为每个 CPU 核都知道自己有没有发生 context switch,所以第二条规则是数据写入者需要等待的一个明确条件。数据写入者或许要在第二条规则上等待几个毫秒的时间才能确保没有数据 Reader 还在使用链表元素,进而释放链表元素
人们创造了多种技术来实现上面第二条规则中的等待,论文里面讨论的最简单的一种方法是通过调整线程调度器,使得写入线程简短的在操作系统的每个CPU核上都运行一下,这个过程中每个CPU核必然完成了一次context switching。因为数据 Reader 不能在 context switch 的时候持有数据的引用,所以经过这个过程,数据写入者可以确保没有数据 Reader 还在持有数据。
所以数据写入者的代码实际上看起来是这样的:
- 首先完成任何对于数据的修改
- 之后调用实现了上面第二条规则 synchronize_rcu 函数
- 最后才是释放旧的链表元素
...;
E1 ->next = e;
synchronize_rcu();
free(old);
synchronize_rcu 迫使每个 CPU 核都发生一次 context switch,所以在 synchronize_rcu 函数调用之后,由于前面的规则 1,任何一个可能持有旧的 E1 next 指针的 CPU 核,都不可能再持有指向旧数据的指针,这意味着我们可以释放旧的链表元素。
你们可能会觉得 synchronize_rcu 要花费不少时间,可能要将近 1 个毫秒,这是事实并且不太好。其中一种辩解的方法是:对于 RCU 保护的数据来说,写操作相对来说较少,写操作多花费点时间对于整体性能来说不会太有影响。
...;
E1 ->next = e;
call_rcu(old, cb);
对于数据写入者不想等待的场景,可以调用另一个函数 call_rcu,将你想释放的对象和一个执行释放的回调函数作为参数传入,RCU 系统会将这两个参数存储到一个列表中,并立刻返回。之后在后台,RCU 系统会检查每个 CPU 核的 context switch 计数,如果每个 CPU 核都发生过 context switch,RCU 系统会调用刚刚传入的回调函数,并将想要释放的对象作为参数传递给回调函数。这是一种避免等待的方法,因为 call_rcu 会立即返回。
但是另一方面不推荐使用 call_rcu,因为如果内核大量的调用 call_rcu,那么保存 call_rcu 参数的列表就会很长,这意味着需要占用大量的内存,因为每个列表元素都包含了一个本该释放的指针。在一个极端情况下,如果你不够小心,大量的调用 call_rcu 可能会导致系统 OOM,因为所有的内存都消耗在这里的列表上了。所以如果不是必须的话,人们一般不会使用 call_rcu
上面提到的条件 1,是不是意味着我们必须关注在 RCU read crtical 区域内的代码执行时间,因为它限制了 CPU 核在这个区域内不能 context switch?
是的,在 RCU 区域内,数据 Reader 会阻止 CPU 发生 context switch,所以你会想要让这个区域变得较短,这是个需要考虑的地方。RCU 使用的方式是,在 Linux 中本来有一些被普通锁或者读写锁保护的代码,然后某人会觉得锁会带来糟糕的性能问题,他会将 Locking 区域替换成 RCU 区域,尽管实际中会更加复杂一些。Locking 区域已经尽可能的短了,因为当你持有锁的时候,可能有很多个 CPU 核在等待锁,所以普通锁保护的区域会尽量的短。因为 RCU 区域通常是用来替代 Lock 区域,它也趋向于简短,所以通常情况下不用担心 RCU 区域的长短。这里实际的限制是,数据 Reader 不能在 context switch 时持有指针指向被 RCU 保护的数据,这意味着你不能读磁盘,然后在等读磁盘返回的过程中又持有指针指向被 RCU 保护的数据。所以通常的问题不是 RCU 区域的长短,而是禁止出让 CPU。
RCU 用例代码
// list reader;
rcu_read_lock();
e = head;
while(p) {
  e = rcu_dereference(e);
  lock at e->x ...;
  e = e->next;
}
rcu_read_unlock();

// replace the first list element
acquire(lock);
old = head;
e = alloc();
e->x = ...;
e->next = head->next;
rcu_assign_pointer(&head, e);
release(lock);
syncronize_rcu();
free(old);
数据读取位于 rcu_read_lock 和 rcu_read_unlock 之间,这两个函数几乎不做任何事情。rcu_read_lock 会设置一个标志位,表明如果发生了定时器中断,请不要执行 context switch,因为接下来要进入 RCU critical 区域。所以 rcu_read_lock 会设置一个标志位来阻止定时器中断导致的 context switch,中断或许还会发生,但是不会导致 context switch(注,也就是线程切换)。rcu_read_unlock 会取消该标志位。所以这是一个集成在 RCU critical 区域的计数器。rcu_read_lock 和 rcu_read_unlock 因为几乎不做任何工作所以极其的快(注,这里有个问题,23.2 中描述的读写锁慢的原因是因为在读数据的时候引入了写计数器的操作,这里同样也是需要额外的写操作,为什么这里不会有问题?这是因为读写锁的计数器是所有 CPU 共享的,而这里的标志位是针对每个 CPU 的,所以修改这里的标志位并不会引起 CPU 之间的缓存一致消息)。
其中的 while 循环会扫描链表,rcu_dereference 函数会插入 memory barrier,它首先会从内存中拷贝 e,触发一个 memory barrier,之后返回指向 e 的指针。之后我们就可以读取 e 指针指向的数据内容,并走向下一个链表元素。数据读取部分非常简单。
数据写入部分更复杂点。
- RCU 并不能帮助数据写入者之间避免相互干扰,所以必须有一种方法能确保一次只能有一个数据写入者更新链表。这里我们假设我们将使用普通的 spinlock,所以最开始数据写入者获取锁。
- 如果我们要替换链表的第一个元素,我们需要保存先保存链表第一个元素的拷贝,因为最后我们需要释放它,所以有 old=head。
- 接下来的代码执行的是之前介绍的内容,首先是分配一个全新的链表元素,之后是设置该链表元素的内容,设置该链表元素的 next 指针指向旧元素的 next 指针。
- 之后的 rcu_assign_pointer 函数会设置一个 memory barrier,以确保之前的所有写操作都执行完,再将 head 指向新分配的链表元素 e。
- 之后就是释放锁。
- 之后调用 synchronize_rcu 确保任何一个可能持有了旧的链表元素的 CPU 都执行一次 context switch,因此这些 CPU 会放弃指向旧链表元素的指针。
- 最后是释放旧的链表元素。
这里有件事情需要注意,在数据读取代码中,我们可以在循环中查看链表元素,但是我们不能将链表元素返回。例如,我们使用 RCU 的时候,不能写一个 list_lookup 函数来返回链表元素,也不能返回指向链表元素中数据的指针,也就是不能返回嵌入在链表元素中的字符串。我们必须只在 RCU critical 区域内查看被 RCU 保护的数据,如果我们写了一个通用的函数返回链表元素,或许我们能要求这个函数的调用者也遵循一些规则,但是函数的调用者还是可能会触发 context switch。如果我们在函数的调用者返回之前调用了 rcu_read_unlock,这将会违反 23.5 中的规则 1,因为现在定时器中断可以迫使 context switch,而被 RCU 保护的数据指针仍然被持有着。所以使用 RCU 的确会向数据 Reader 增加一些之前并不存在的限制。
这样是不是说我们不可能返回下标是 i 的元素所包含的内容?
可以返回一个拷贝,如果 e->x 是个字符串,那么我们可以返回一个该字符串的拷贝,这是没有问题的。但是如果我们直接返回一个指针指向 e->x,那就违反了 RCU 规则。实际上返回 e 中的任何指针都是错误的,因为我们不能在持有指向 RCU 保护数据的指针时,发生 context switch。通常的习惯是直接在 RCU critical 区域内使用这些数据。
性能
接下来我将再简短的介绍性能。如果你使用 RCU,数据读取会非常的快,除了读取数据本身的开销之外就几乎没有别的额外的开销了。如果你的链表有 10 亿个元素,读取链表本身就要很长的时间,但是这里的时间消耗并不是因为同步(注,也就是类似加锁等操作)引起的。所以你几乎可以认为 RCU 对于数据 Reader 来说没有额外的负担。唯一额外的工作就是在 rcu_read_lock 和 rcu_read_unlock 里面设置好不要触发 context switch,并且在 rcu_dereference 中设置 memory barrier,这些可能会消耗几十个 CPU cycle,但是相比锁来说代价要小的多。
对于数据写入者,性能会更加的糟糕。首先之前使用锁的时候所有的工作仍然需要做,例如获取锁和释放锁。其次,现在还有了一个可能非常耗时的 synchronize_rcu 函数调用。实际上在 synchronize_rcu 内部会出让 CPU,所以代码在这不会通过消耗 CPU 来实现等待,但是它可能会消耗大量时间来等待其他所有的 CPU 核完成 context switch。所以基于数据写入时的多种原因,和数据读取时的工作量,数据写入者需要消耗更多的时间完成操作。如果数据读取区域很短(注,这样就可以很快可以恢复 context switch),并且数据写入并没有很多,那么数据写入慢一些也没关系。所以当人们将 RCU 应用到内核中时,必须要做一些性能测试来确认使用 RCU 是否能带来好处,因为这取决于实际的工作负载。
使用场景
你们应该已经看到了 RCU 并不是广泛通用的,你不能把所有使用 spinlock 并且性能很差的场景转化成使用 RCU,并获得更好的性能。主要的原因是 RCU 完全帮不到写操作,甚至会让写操作更慢,只有当读操作远远多于写操作时才有可能应用 RCU。因为 RCU 有这样的限制:代码不能在 sleep 的时候持有指针指向被 RCU 保护的数据,所以这会使得一些代码非常奇怪。当一定要 sleep 的时候,在 sleep 结束之后需要重新进入 RCU critical 区域再次查找之前已经看过的数据,前提是这些数据还存在。所以 RCU 使得代码稍微复杂了一些。
另一方面可以直接应用 RCU 的数据结构在更新时,需要能支持单个操作的 committing write。你不能在原地更新数据,而是必须创建一个新的链表元素对象来替代之前的元素对象。所以单链表,树是可以应用 RCU 的数据结构,但是一些复杂的数据结构不能直接使用 RCU。论文里面提到了一些更复杂的方法,例如sequence lock,可以在允许原地更新数据的同时,又不用数据 Reader 使用锁。但是这些方法要复杂一些,并且能够提升性能的场景也是受限的。
本讲小结
另一个小问题是,RCU 并没有一种机制能保证数据 Reader 一定看到的是新的数据。因为如果某些数据 Reader 在数据写入者替换链表元素之前,获取了一个指针指向被 RCU 保护的旧数据,数据 Reader 可能会在较长的时间内持有这个旧数据。大部分时候这都无所谓,但是论文提到了在一些场景中,人们可能会因为读到旧数据而感到意外。
作为一个独立的话题,你们或许会想知道对于一个写操作频繁的数据该如何提升性能。RCU 只关心读操作频繁的数据,但是这类数据只代表了一种场景。在一些特殊场景中,写操作频繁的数据也可以获取好的性能,但是我还不知道存在类似 RCU 这样通用的方法能优化写操作频繁的数据。不过仍然有一些思路可以值得借鉴。
- 最有效的方法就是重新构造你的数据结构,这样它就不是共享的。有的时候共享数据完全是没必要的,一旦你发现数据共享是个问题,你可以尝试让数据不共享。
- 但是某些时候你又的确需要共享的数据,而这些共享数据并没有必要被不同的 CPU 写入。实际上你们已经在 lab 中见过这样的数据,在 locking lab 的 kalloc 部分,你们重构了 free list 使得每个 CPU 核都有了一个专属的 free list,这实际上就是将一个频繁写入的数据转换成了每个 CPU 核的半私有数据。大部分时候 CPU 核不会与其他 CPU 核的数据有冲突,因为它们都有属于自己的 free list。唯一的需要查看其他 CPU 核的 free list 的场景是自己的 free list 用光了。有很多类似的例子用来处理内核中需要频繁写入的数据,例如 Linux 中的内存分配,线程调度列表。对于每个 CPU 核都有一套独立的线程对象以供线程调度器查看(注,详见 11.8,线程对象存储在 struct cpu 中)。CPU 核只有在自己所有工作都完成的时候才会查看其他 CPU 核的线程调度列表。另一个例子是统计计数,如果你在对某个行为计数,但是计数变化的很频繁,同时又很少被读出,你可以重构你的计数器,使得每个 CPU 核都有一个独立的计数器,这样每个 CPU 核只需要更新属于自己的计数器。当你需要读取计数值时,你只需要通过加锁读出每个 CPU 核的计数器,然后再加在一起。这些都是可以让写操作变得更快的方法,因为数据写入者只需要更新当前 CPU 核的计数器,但是数据 Reader 现在变得更慢了。如果你的计数器需要频繁写入,实际上通常的计数器都需要频繁写入,通过将更多的工作转换到数据读取操作上,这将会是一个巨大的收益。
论文阅读: Linux 内核的 RCU 的使用
RCU(Read-Only update)是 Linux 内核实现的一个可扩展性的高性能同步机制。RCU 新颖的性质包括读写并发,和极大优化了 CPU 同步的性能。今天,很多内核子系统都用了 RCU,这篇论文讲推动 RCU 的开发必要性, API 的设计,以及开发者如何使用 RCU。
1. 介绍
过去用一把大锁进行同步,内核即时应用在过去的多处理器机器上表现很差,需要可扩展性好,且性能好的同步机制,在多核处理器上运行。内核开发者用了很多各种技术,包括细粒度锁,无锁结构,每个 CPU 一个副本的数据结构(Per-CPU),以及 RCU。 RCU 并不是 Linux 独有的,但 Linux 的适用范围和方式与众不同,这使得 RCU 称为理解 Linux 内核机器性能的前提条件。
RCU 的成功源于高性能的并发 reader 和 updater 的出现,且尽利用了简单的原语,reader 在 RCU 的读者端的临界区内访问数据,而 updater 使用 RCU 的同步来等待所有之前的 RCU 读者端的临界区完成。这样一结合,这些原语允许线程并发读数据结构,即便其他线程在更新他们。
3. RCU 设计
RCU 是一个给 Linux 内核的库,允许内核子系统以高效的方式同步和访问共享数据。RCU 的两个原语,简单说就是,RCU 临界区和 RCU 同步。一个线程进入 RCU 临界区通过调用rcu_read_lock,完成临界区用rcu_read_unlock,一个线程进行RCU同步通过synchronize_rcu,他可以保证直到所有的RCU临界区都完成后才会返回,并且Synchronize_rcu 不会阻止新的 RCU 临界区开始,也不会等待在调用 synchronize_rcu 后启动的 RCU 临界区完成。
下面阐述了一种可能的使用方式。假设需要在应用程序删除文件时,安全地释放与一个目录项(dentry)相关联的内存。一种实现方式是,一个线程只从目录缓存中获取 dentry 的指针,并在操作目录项时始终处在 RCU 临界区中执行。当一个应用删除一个文件时,内核需要在其所在目录缓存中去除这个文件,调用call_synchronize_rcu来等待所有线程完成临界区。当调用返回时,内核已经安全释放了这个目录项。
RCU 基于调度器上下文的切换来完成低成本的执行和存储开销。如果 RCU 关闭了线程抢占(thread preemption),则synchronize_rcu只需要等待直到所有的CPU都执行了上下文切换。在 RCU 临界区和 synchronize_rcu 之间,不需要额外的显式通信。
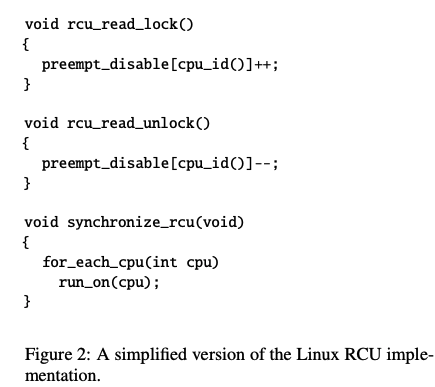
图 2 展示了 Linux RCU 简化实现的版本。lock 关闭抢占,unlock 打开抢占。preempy_disable是一个 CPU 本地变量,因此线程在更改它时不会造成竞争。为了确保每个 CPU 执行了上下文切换,执行 sync 的线程会对在每个 CPU 上执行。注意,sync 的成本与执行 lock 和 unlock 的次数无关。
实际中 Linux 实现 Snyc 通过等待所有的 CPU 完成上下文切换,而不是调度一个线程在每个 CPU 上执行。这个设计优化了低成本的 RCU 临界区,但代价是 synchronize_rcu 的调用者需要等待的时间可能比实际必要的更长。Linux 的实现,本质上是批处理了读者到写着的通信,通过等待上下文切换实现。尽可能地,读者使用异步版本的 sync,叫call_rcu,在所有 CPU 至少完成一次上下文切换后,能够异步调用指定的回调。
Linux 的 RCU 实现,尽可能摊销了许多在 sync 和call_rcu探测上下文切换的成本。探测上下文切换需要维护CPU之间的共享状态。一个 CPU 必须更新其状态,而其他 CPU 会读取该状态,以表明它执行了上下文切换。更新共享状态代价太高了,因为他会导致其他CPU的cache miss。RCU 通过每个调度时钟周期大约报告一次per-CPU 的状态来降低成本。 如果内核在这段时间内多次调用sync和call_rcu,RCU会通过批处理方式降低每次调用的平均成本,但是代价是更高的延迟。Linux 能够在一次批处理中满足超过 1,000 次 sync和call_rcu 的调用需求。对于对延迟敏感的内核子系统,RCU 提供了加速的同步功能,这些功能无需等待所有 CPU 执行多次上下文切换即可完成。
另外一个 Linux RCU 实现的考量是,内存排序的问题。由于 RCU 的读取和更新操作是并发运行的,需要特别注意编译器和内存的重排序问题。(如果处理不当,读取线程访问脏数据, 这可能是由于更新线程在并发初始化数据项并往单链表中插入时,可能会看到该数据项初始化之前的值。)
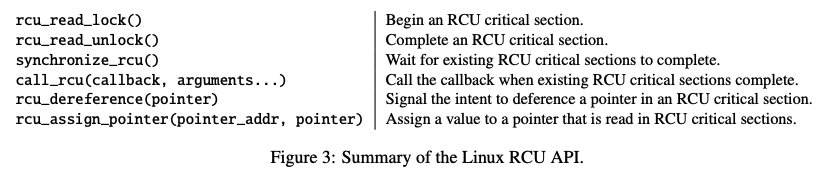
因此 RCU 提供了原语 rcu_dereference和 rcu_assign_pointer。reader用derefer来表示他们准备读取RCU临界区的指针,更新者用assign来更改这些指针。这两个原语包含了与架构有关内存屏障指令和编译器指令来确保排序正确。derefer原语是一个是一个 volatile 访问操作,意思是它告诉编译器不要对该操作进行优化,因为它必须确保每次都从内存中读取最新的值。下图总结用法:
4. RCU 使用场景
我们将会展示最典型的用法和场景
4.1 等待完成
RCU 最简单的用法就是等待之前的活动完成。这个例子,等待着用 sync,或者异步的call_rcu。Linux NMI(Non-Maskable Interrupt)系统用 RCU 来注销 NMI 的 handlers。在注销之前,内核必须保证没有 CPU 在执行 handler,否则,某个 CPU 可能会尝试执行无效或已释放内存中的代码.比如,当内核卸载一个注册到 NMI handler 的模块,内核会释放掉包含那块代码的 NMI handler。
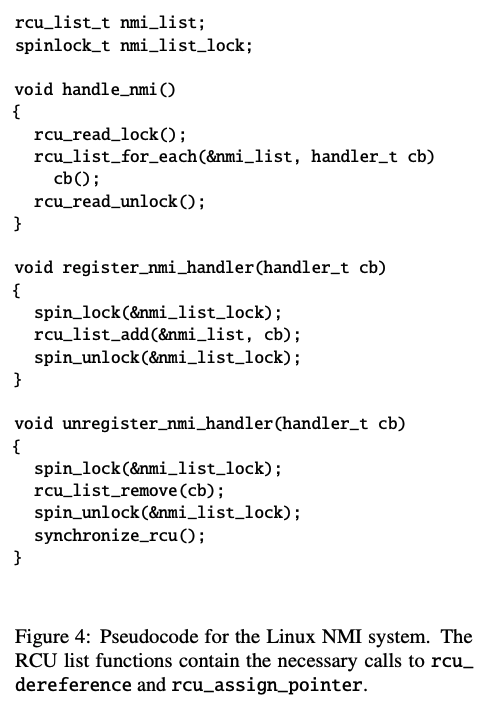
图 4 为伪代码,nmi_list是handler的单链表,获取时需要自旋锁来避免并发更新,rcu_list_for_each会调用每个handler的rcu_dereference,而rcu_list_add和rcu_list_remove调用rcu_assign_pointer来更改链表。 为了移除一个handler,NMI系统从链表中移除该handler,然后调用synchronize_rcu,当返回时,所有的对 handler 的调用都已经返回。
在 NMI 系统使用 RCU 有 3 个好的性质,首先是高性能,因为 CPU 能够频繁执行 NMI 的 handler,不会造成 Cache Miss,或者跑到其他 CPU 上。其次,对实时应用很重要,能够在确定数量的指令进入和完成 RCU 临界区。最后, 这种实现能够实现动态的注册和注销 NMI handler。
4.2 引用计数
相比采用显式的对一个数据项进行引用计数,RCU 采用的是在 RCU 临界区执行数据更新。为了释放数据项, 一个线程必须阻止其他线程获取对这个数据项的指针,然后调用call_rcu在释放内存。