
基础设施
摘要
本次实验假设你已经在计算机上安装了 Python 3.11 或更新版本(推荐使用 3.12),以及 pytest、pylint 和 black。
当前课程暂无后续已收录内容。
基础设施
必要准备
本次实验假设你已经在计算机上安装了 Python 3.11 或更新版本(推荐使用 3.12),以及 pytest、pylint 和 black。
运行测试
对于我们的每个实验,我们都会包含一个名为 test.py 的文件,其中包含了多个测试用例,用于评估你在实验中的代码的正确性。
运行 pytest test.py 将运行文件中的所有测试用例并显示结果。你也可以修改这种行为(例如,只运行某些测试用例);
Lab 0 音频处理
实验简介
在物理学中,当我们谈论声音时,我们指的是空气压力的波。当声音产生时,由相对高压区(“压缩”)和相对低压区(“稀疏”)交替形成的声波在空气中传播。
当我们使用麦克风以数字方式捕捉声音时,我们通过对与空气压力成比例的电信号进行周期性测量来实现这一点。每个单独的测量值(通常称为“样本”)对应于某一时刻的空气压力;通过以恒定的速率(“采样率”,通常以每秒捕获的样本数来衡量)重复进行测量,这些测量值共同形成了声音的表示,通过近似空气压力随时间的变化。
当扬声器回放声音时,它通过将这些测量值转换回交替的空气压力波(通过使膜片按这些捕获的测量值成比例地移动)来实现。为了忠实地表示声音,我们需要知道两个方面:采样率和实际捕获的样本。
对于以单声道录制的声音,每个样本是一个正数或负数,对应于某一时刻的空气压力。对于以立体声录制的声音,每个样本可以看作由两个值组成:一个用于左扬声器,另一个用于右扬声器。
python 的表示
我们将使用存储在 WAV 格式中的文件进行操作。然而,你不需要详细了解这种格式,因为我们已经在 lab.py 中提供了一些“辅助函数”,用于将这些文件中的信息加载到 Pythonic 格式中,并将这种 Pythonic 表示的声音保存为 WAV 文件。
我们对单声道声音的 Pythonic 表示(我们将在本次实验的大部分时间中使用这种表示)将由一个包含两个键值对的字典组成:
'rate':采样率(以整数表示),单位为每秒采样数。'samples':包含样本的列表,其中每个样本都是一个浮点数。
操作
在本次实验中,我们将研究以这种形式表示的音频的各种操作效果
反向音频
我们将通过一个名为 backwards 的函数实现第一个操作。该函数应接收一个单声道音频(按照上述表示方法,作为字典)作为输入,并返回一个新的单声道音频,该音频是原始音频的反向版本(但不修改原始音频的对象!)。
反转真实世界的声音可以产生一些很酷的效果。例如,考虑以下声音(一个碰撞的镲片):
当反转时,它听起来像这样:
当我们谈论以这种方式反转声音时,我们实际上是在谈论反转其样本的顺序(在左声道和右声道中),但保持采样率不变。
继续在你的 lab.py 文件中实现 backwards 函数。完成后,你的代码应通过 test.py 文件中的前四个测试用例。
玩这些东西可能也会很有趣。例如,mystery.wav 是一段亚当说胡话的录音。让我们试着使用我们新的函数来生成该文件的修改版本。
请注意,我们在 if __name__ == '__main__' 部分提供了一些示例代码,该代码演示了如何使用 load_wav 和 write_wav 函数。这是一个放置生成文件或其他快速测试代码的好地方。
混合音频
接下来,我们将研究将两个声音混合在一起以创建新声音的效果。我们将这种行为实现为一个名为 mix 的函数。mix 应该接受三个输入:
- 两个声音(使用字典表示)
- 一个“混合参数”(一个浮点数,0 到 1 之间)
mix 函数应该按照以下步骤操作:
- 混合参数:
mix函数将音频样本的比例加权结合。具体地,它应该将第一个声音的样本乘以混合参数α(0 到 1 之间),将第二个声音的样本乘以1 - α,然后将它们相加,以生成新的声音。 - 采样率:两个输入声音应具有相同的采样率。如果提供的声音具有不同的采样率,函数应该返回
None,而不是返回声音。 - 处理长度:尽管输入声音具有相同的采样率,但它们可能有不同的持续时间。结果声音的长度应为两个输入声音的最大长度,以确保可以完整地听到两个声音(如果其中一个声音在中间被截断,会显得很突兀)。
卷积滤波器
事实证明,通过使用一种称为卷积的操作,可以对音频应用各种有趣的效果。通过将这个操作应用于声音的样本和一个“卷积核”(另一个样本列表),我们可以实现多种效果。
在其最简洁的数学形式中,卷积通常用以下方式表示:
即,第 nnn 个样本的值 yny_nyn 可以通过右边的和来计算(其中 xxx 代表输入声音的样本,hhh 代表卷积核的样本)。
这种方式很好地实现了卷积(如果你愿意,你可以这样做),但也许考虑卷积的另一种稍微不同的方式会更容易。我们的卷积核由一组值表示。对于卷积核中的每一个非零值,我们创建输入声音样本的副本,这些副本按 iii 偏移并按 hih_ihi 缩放;将这些新的信号列表相加得到我们的输出。输出的总长度应为输入声音样本长度加上卷积核样本长度再减去一。
s = {
  'rate': 20,
  'samples': [3, 0, -2, 1, 0, 4]
}
# 卷积核
kernel = [2, 5, 0, 4]
在计算 convolve(s, kernel) 的结果时,我们知道输出最终会有 9 个样本(即样本长度加上卷积核长度再减去 1)。
- 核心中索引 0 的 2 对我们的输出贡献了像原始样本按 2 缩放并偏移 0 的值:
[6, 0, -4, 2, 0, 8, 0, 0, 0]。 - 核心中索引 1 的 5 对我们的输出贡献了像原始样本按 5 缩放并偏移 1 的值:
[0, 15, 0, -10, 5, 0, 20, 0, 0]。 - 核心中索引 2 的 0 对我们的输出没有贡献。
- 核心中索引 3 的 4 对我们的输出贡献了像原始样本按 4 缩放并偏移 3 的值:
[0, 0, 0, 12, 0, -8, 4, 0, 16]。
将这些列表中对应的元素相加,我们得到的总体结果是:[6, 15, -4, 4, 5, 0, 24, 0, 16]。这些代表了我们输出声音的样本(其采样率应与输入相同)。
我们可以用以下表格来总结这个过程:
| 索引 (n) | 输入样本 (x) | 卷积核值 (h) | 按 i 偏移, 按 h_i 缩放 | 总计 (∑ 列) |
|---|---|---|---|---|
| ... | ... | ... | ... | ... |
现在,尝试手动计算以下卷积的结果:
s = { 'rate': 30, 'samples': [-5, 0, 2, 3, 4], }
k = [0, 1, 0, 0, 3]
如果我们通过 s2 = convolve(s, k) 创建一个新声音,那么 s2['samples'] 应该是什么值?
然后在 lab.py 中实现 convolve 函数。实现正确后,你的代码应该通过 test.py 中的前 14 个测试用例。
卷积可能看起来是一个奇怪的操作,但它在很多常见和有趣的音频处理操作中发挥了核心作用。例如,通过卷积可以实现低音增强效果,其中音频中的低频内容被放大。
我们提供了一个名为 bass_boost_kernel(N, scale) 的函数。调用这个函数将生成一个可以传递给你的 convolve 函数(以及一个声音)的卷积核,以产生一个新的输出声音。scale 参数影响低频的响度(scale=0 表示没有增强,较大的值则增强低频内容);N 参数提供了一种控制增强频率的方式(N=0 将大致上均等地增强所有频率,而较大的值允许更多关注输入声音中的最低频率)。
要测试这个功能,使用你的 convolve 函数创建 ice_and_chilli.wav 的低音增强版本。创建卷积核时,使用 N=1000 和 scale=1.5。注意,这个操作可能比我们之前生成的文件花费更长的时间;在运行时可以去喝杯茶。这可能需要几分钟,取决于你运行的计算机。
听听结果,并与原始的 ice_and_chilli.wav 进行比较。你能听出区别吗?注意,区别可能在笔记本电脑的扬声器上听不太出来;但如果你使用耳机或外部扬声器,它应该会更明显。
回声
接下来,我们将实现一个经典的效果:回声滤波器。我们通过从原始声音开始,并添加一个或多个额外的声音副本,每个副本都被延迟了一段时间,并且缩小了声音的强度,从而模拟回声效果。
我们将实现这个滤波器为一个名为 echo 的函数。该函数应接受以下参数:
sound: 一个表示原始声音的字典num_echoes: 要添加的额外声音副本的数量delay: 每个“回声”应该延迟的时间(以秒为单位)scale: 每个回声样本应该缩放的量
一个好的开始是确定每个副本应该延迟多少个样本。为了确保你的结果与我们的检查器一致,你应该使用 Python 的 round 函数:sample_delay = round(delay * sound['rate'])。
我们应该添加一个延迟和缩小的声音副本(按给定的缩放值缩放并偏移 sample_delay 样本)。注意,每个新的副本应该比前一个副本缩小更多(第一个副本乘以 scale,第二个副本乘以 scale**2,第三个副本乘以 scale**3,依此类推)。
总的来说,为了避免剪切掉任何回声,输出的长度应该比输入长度多出 num_echoes * sample_delay 个样本。
立体声
在本实验的最后两个音频效果中,我们将关注立体声音(具有左右声道独立样本列表的文件)。
我们在 Python 中的立体声音表示将是一个包含三个键值对的字典:
'rate': 采样率(以每秒样本数为单位,整数类型)'left': 一个包含左声道样本的列表'right': 一个包含右声道样本的列表
例如,以下是一个有效的立体声音:
s = {
    'rate': 8000,
    'left': [0.00, 0.59, 0.95, 0.95, 0.59, 0.00, -0.59, -0.95, -0.95, -0.59],
    'right': [1.00, 0.91, 0.67, 0.31, -0.10, -0.50, -0.81, -0.98, -0.98, -0.81],
}
我们的 load_wav 函数可以读取立体声文件来创建这种形式的声音,只需在函数中提供 stereo=True 参数。例如,load_wav('hello.wav') 生成单声道声音,而 load_wav('hello.wav', stereo=True) 则生成立体声音。
6.1) 音量平移(Pan)
对于我们使用立体声音的第一个效果,我们将创建一个非常有趣的空间效果。请注意,这个效果在戴耳机时最为明显;通过笔记本电脑扬声器可能不太明显。
让我们先听一个示例。如果你听下面的声音(一个吱吱作响的门),它应该听起来像门就在你正前方:
然而,如果我们对它进行一些调整,可以让它听起来像是你正在移动到门边,或者门在你旁边移动?🤔 无论如何,声音似乎从你的左侧开始,并最终转移到你的右侧!
我们通过分别调整左右声道的音量来实现这一效果,使得左声道从全音量开始,最终变为 0 音量(右声道则相反)。
具体来说,如果我们的声音是 n 个样本长,那么:
- 右声道的第一个样本缩放因子是
0,第二个是1/(n-1),第三个是2/(n-1),依此类推,最后一个样本的缩放因子是1。 - 左声道的第一个样本缩放因子是
1,第二个是n-2/(n-1),第三个是n-3/(n-1),依此类推,最后一个样本的缩放因子是0。
在 lab.py 文件中实现 pan 函数后,你的代码应该通过 test.py 中的前 22 个测试用例。
完成后,尝试将 pan 应用于 car.wav 文件,然后保存结果并听听它。这个效果应该比门的示例更令人印象深刻(或者至少更真实)……
当你完成这个文件后,请上传以检查其正确性:
Left-to-right car.wav: [未选择文件]
6.2) 去除音乐中的人声
作为本实验的最后一个示例(除非你对下面讨论的一些可选附加内容感兴趣!),我们将使用一种小技巧(有点)去除音乐中的人声,创建一个适合卡拉 OK 夜晚的伴奏版本。这种效果将接受立体声音作为输入,但会产生一个单声道声音作为输出。
我们的方法一开始可能看起来很奇怪,但稍后我们会解释为什么它有效(至少在一些音乐作品中)。现在,我们先描述我们的算法。对于每个(立体声)输入声音中的样本,我们计算(左声道减去右声道),即在该时间点上左声道和右声道的差异,并将结果用作(单声道)输出声音中的对应样本。
这可能看起来像是个奇怪的方法,但我们可以听到结果非常不错。例如,这里是之前流行的歌曲《Lido Shuffle》的一个短片段:
应用上述算法后的结果:
虽然一些乐器有些失真,并且一些人声的痕迹仍然存在,但这种方法在去除人声的同时保留了大部分其他内容。
确实,减去左右声道的声音竟然能去除人声!那么这怎么能做到呢?为什么它只在某些歌曲上有效?这归结于一种录音技巧的技巧。通常,许多乐器的录音会偏向于立体声轨的一个侧面(例如,吉他轨可能稍微偏向一侧,低音稍微偏向另一侧,各种鼓则分布在不同的“位置”上)。相比之下,人声通常以单声道录制并在两个声道中播放。当我们减去这两个声道的声音时,我们去除了在两个声道中相同的部分,这通常包括主要的人声轨(通常没有太多其他部分)。然而,当然也有例外;而且,除了录音技术的差异,某些人声效果如混响会引入两个声道之间的差异,使得这种技巧效果较差。
无论如何,现在可以通过填充 lab.py 中 remove_vocals 函数的定义来实现这个处理。与之前的所有滤波器一样,这个函数不应修改其输入;而是应该生成一个新声音。完成 remove_vocals 后,你的代码应该通过 test.py 中的所有测试用例!
尝试将 remove_vocals 应用于 lookout_mountain.wav 的声音。如果你听听结果,这种方法在这个示例上表现如何?
将结果保存为 WAV 文件,并上传以检查其正确性
Lab 1 图像处理
在本实验中,你将构建几个用于操控数字图像的工具,类似于 Photoshop 和 GIMP 等图像处理工具包中的工具。有趣的是,许多经典的图像滤镜都是使用我们在实验过程中将要开发的相同思想来实现的。
本周,我们将专注于仅处理灰度图像。
1 介绍
数字图像表示和颜色编码
在我们可以开始操控图像之前,我们首先需要一种在 Python 中表示图像的方式。虽然数字图像可以用多种方式表示,但最常见的方法经受住了时间的考验:一个矩形的像素马赛克——由彩色点组成的图像。因此,图像可以通过指定宽度、高度以及每个像素的颜色值数组来定义。这种表示方法源自模拟电视的早期阶段,并在许多技术变革中得以保存。虽然各个文件格式使用不同的编码、压缩和其他技巧,但像素数组表示仍然是大多数数字图像的核心。
对于本实验,我们将简化处理,专注于灰度图像。每个像素的亮度用一个范围为 [0, 255] 的整数来编码(1 字节可以容纳 256 个不同的值),0 表示最深的黑色,而 255 表示我们能表示的最亮白色。完整的范围如下:
0 图像渐变 255
在本实验中,我们将使用一个 Python 字典来表示图像,字典包含三个键:
"width": 图像的宽度(以像素为单位)"height": 图像的高度(以像素为单位)"pixels": 一个包含像素亮度的 Python 列表,按照行优先顺序存储(列出顶部行从左到右,然后是下一行,以此类推)
例如,考虑下面的图像(3 行 2 列),(为了清晰显示已放大):
这个图像将编码为以下实例
i = {
    "height": 3,
    "width": 2,
    "pixels": [0, 50, 50, 100, 100, 255],
}
加载、保存和显示图像
我们在 lab.py 中提供了两个可能对调试有用的辅助函数:load_greyscale_image 和 save_greyscale_image。每个函数通过 docstring 进行了说明。
你不需要深入了解这些函数的实际代码,但值得查看这些 docstring 并尝试使用这些函数来:
- 加载图像
- 使用不同的文件名保存图像
然后你可以使用计算机上的图像查看器打开新的图像,确保它被正确保存。
test_images 目录中包含了多个示例图像,或者你可以使用自己选择的图像进行测试。
在你实现以下描述的各种滤镜时,这些函数可以提供可视化输出的方式,这有助于调试,同时也方便向朋友和家人展示你酷炫的结果。
注意,你可以在 lab.py 中的 if __name__ == '__main__': 块下添加加载、操控和保存图像的代码,这些代码将在直接运行 lab.py 时执行(但在测试套件导入时不会执行)。因此,建议你养成在该块中编写自己设计的测试用例的习惯,而不是在 lab.py 文件的主体部分。
2 通过逐像素变换进行图像滤镜处理
作为我们操控图像的第一个任务,我们将看看反转滤镜,它将像素反射到中灰值的另一侧(0 黑色变为 255 白色,1 变为 254,以此类推)。例如,考虑以下三张图像,每张图像都展示了一只可爱的猫。在每张图像中,左侧是原始图像,而右侧是反转版本。
注意,在每个示例中,输入图像中的最暗点变成了输出图像中的最亮点,反之亦然,而输入图像中的灰色点在输出图像中会变成类似(但不一定完全相同)的灰色点。
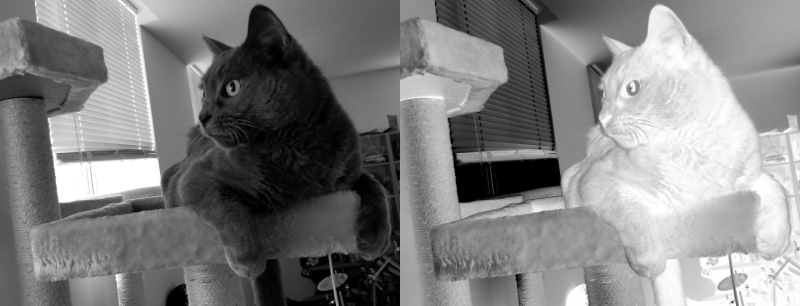
大部分反转滤镜的实现已经为你完成(它通过调用名为 inverted 的函数来实现),但其中一些部分没有正确实现。你在本部分实验中的任务是修复反转滤镜的实现。
在你开始之前,让我们首先在 test.py 中添加一个小的测试用例。我们将通过手动计算确定给定输入应期望的输出,并编写相应的测试用例。最终,当我们有了工作的反转滤镜代码时,这个测试用例应该能够通过!
3 通过卷积图像滤镜处理
接下来,我们将探索一些稍微复杂的图像处理技术,其中涉及到一个叫做相关性(correlation)的操作。
给定一个输入图像I和一个卷积核k,将k应用于I会生成一个新的图像O(可能具有非整数或超出范围的像素值),其高度和宽度与I相等。输出图像的像素值按照卷积核k所描述的规则进行计算。
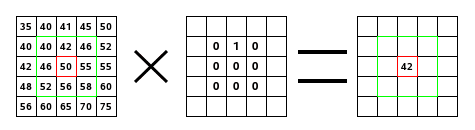
应用k到I的过程被称为相关性:输出图像中某一位置(r,c)像素的亮度(我们将其表示为, 最左下角的记为),是输入图像中位置(r, c)附近像素亮度的线性组合,其中权重由卷积核k提供。
例如,考虑一个卷积核:
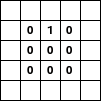
当我们将这个卷积核应用于图像时,每个输出像素的亮度是输入图像中距离该位置最近的 9 个像素亮度的线性组合,每个输入像素的值都乘以卷积核中相应的值:
边缘效应
在计算图像边缘的像素时,可用的输入像素少于 9 个。例如,考虑位置在左上角的像素。在这种情况下,所有位于像素上方和左侧的像素都是越界的。我们有几种选项来处理这些边缘效应:
- zero:一种方法是将每个越界像素的值视为 0。
- extend:另一种方法是扩展输入图像的边界,这将在下一段解释。
- wrap:另一种方法是对图像的边缘进行包裹处理,这将在之后的段落中解释。
如果我们希望通过图像的扩展版本(extend)来考虑这些越界像素,图像左侧的值应视为图像第 0 列的值,图像上方的值应视为图像第 0 行的值,等等。下图中间的粗体像素代表原始图像,而该区域外的像素代表“扩展”版本的逻辑值(虽然下图中只显示了有限数量的像素,但这个过程在所有方向上无限延续):

如果我们希望对图像的边缘进行包裹处理,超出图像左边缘的值,用右边缘的值表示,但在相同的行中。类似地,出图像上边缘的值,用下边缘的值表示,但在相同的列中。我们可以把它看作图像在所有四个方向上“平铺”:
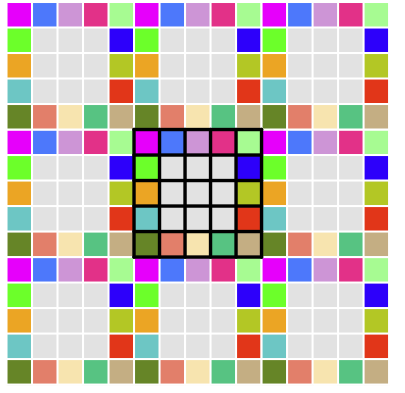
上图中的粗黑方框表示原始图像,而这些副本是包裹行为的示意图(但它们不是图像的一部分)。注意,这里只显示了每个方向的一个副本,但我们希望包裹在所有方向上无限延续。
为了实现不同边缘行为之间的切换,你可以实现一个替代的 get_pixel 函数,并增加一个参数用于处理越界行为,该参数接受“zero”、“wrap”或“extend”其中之一的字符串。该函数将正常返回图像内的像素值,但对于越界像素则按照上述讨论返回相应的值,而不是引发异常。如果你这样做,代码中的其他部分可以利用该函数,而不必担心像素是否越界。
相关性
在本实验的剩余部分,我们将实现几个不同的滤波器,每个滤波器都涉及计算至少一个相关性。因此,我们需要一种通用的方式来计算相关性(对于任意图像和任意核)。
请注意,相关性的输出不一定是一个合法的图像(像素值可能超出[0,255]范围或可能是浮点数[意味着它们不是整数])。由于我们希望所有的滤波器都输出有效的图像,因此我们在每一个图像处理函数中的最终步骤将是将负像素值裁剪为 0,将大于 255 的值裁剪为 255,并确保图像中的所有值都是整数。
由于这两个操作很常见,我们建议为每个操作编写一个“辅助”函数(这样我们的滤波器可以简单地调用这些函数,而不是多次重新实现底层行为)。
我们在 lab.py 中提供了这两个辅助函数的骨架(分别称为 correlate 和 round_and_clip_image)。
请注意,我们没有明确告知你如何表示用于相关性的核。你可以使用任何你喜欢的表示方法来表示核,但你应该通过修改 correlate 函数的文档字符串来记录这种更改。你可以假设核总是方形的,并且每个核都将具有奇数行和列。
为了帮助调试,你可以编写一些测试用例,将 11x11 的 test_images/centered_pixel.png 或其他简单图像与几个不同的核进行相关性计算。你可以使用下一节中的核来帮助测试你的代码是否产生了预期的结果。
4 模糊和锐化
模糊
在这部分实验中,我们将实现一个方框模糊(box blur),这可以通过使用相关性(correlation)并采用扩展方式处理越界像素来实现。对于方框模糊,卷积核(kernel)是一个由相同值组成的 矩阵,其值之和为 1。由于你可能需要尝试不同的 n 值,你可以考虑定义一个函数,该函数接受一个参数 n 并返回一个 的方框模糊卷积核。
注意,我们已经为名为 blurred 的函数提供了一个轮廓。阅读 blurred 的文档字符串和轮廓,以了解它应如何工作。
在实现之前,创建两个额外的测试用例,通过填充以下测试内容的定义来测试:
- 对一个完全由黑色像素组成的 图像进行方框模糊处理,使用两种不同的卷积核大小。输出结果显然与输入相同。
- 对
centered_pixel.png图像进行方框模糊处理,使用两种不同的卷积核大小。你应该能够手动计算输出结果。
最后实现blurred函数
锐化
接下来,我们将实现相反的操作,称为锐化滤波器。这个“锐化”操作通常以另一个更能说明其含义的名称出现:它通常被称为反锐化掩模(unsharp mask),因为它的结果是通过从图像的一个缩放版本中减去该图像的一个“反锐化”(模糊)版本得到的。
更具体地说,如果我们有一张图像(I)和同一图像的一个模糊版本(B),则锐化图像S在特定位置的值为:
我们可以通过计算图像的模糊版本,然后对每个像素,根据上面的公式计算其值来实现此操作。
虽然你不必这样做,但实际上可以通过一次相关操作来执行此操作(使用适当选择的核,并再次使用“扩展”(extend)行为处理越界像素)。将反锐化掩模实现为函数 sharpened(image, n),其中 image 是一张图像,n 表示用于生成图像模糊副本的模糊核的大小。你可以选择将其实现为一次相关操作或使用显式的减法,尽管如果你使用显式减法,请确保在最后才进行任何舍入操作(中间的模糊版本不应进行舍入或裁剪)。
请注意,在计算上述操作后,我们仍需要确保 sharpened 最终返回一个有效的 6.101 图像,你可以通过在实验前面部分编写的辅助函数来实现这一点。
与前面的函数不同,我们没有在 lab.py 中提供此函数的骨架;你需要自己实现它。并且确保为你的新函数编写一个信息丰富的文档字符串!
5 边缘检测
我们最后一个针对灰度图像的任务是实现一个非常有趣的滤波器,称为 Sobel 算子,它在图像边缘检测中非常有用。
这个边缘检测器比上面的滤波器稍微复杂一些,因为它涉及两个相关操作。特别是,它涉及两个核 K1 和 K2, 分别如下所示:
-1 -2 -1
 0  0  0
 1  2  1

和

-1  0  1
-2  0  2
-1  0  1
通过分别与 O1 和 O2 进行相关操作(对于每个相关操作都使用“扩展”行为),计算出和 后,输出图像的每个像素 是 和 中对应像素平方和的平方根:
与往常一样,请确保最终图像由范围在 [0, 255] 的整数像素组成。但请只在组合 和 后进行裁剪。如果你裁剪中间结果,组合计算将会不正确。
检查一下: 单独来看, 核和 核各自做了什么?尝试运行、保存并查看这些中间相关操作的结果,以了解发生了什么。
将边缘检测器实现为函数 edges(image),该函数接受图像作为输入,并返回通过上述操作生成的新图像(其中边缘应得到强调)。
另外,创建一个新的测试用例:对 centered_pixel.png 图像进行边缘检测。正确的结果是中心像素周围 1 像素宽的白色环。
与 sharpened 类似,你应该将这段代码自己添加到 lab.py 中(并确保包含信息丰富的文档字符串);这里没有提供代码骨架。
另请注意,已经为你导入了 math 模块,并且你可以使用其中的 sqrt 函数(当然,如果你愿意,也可以通过将数字提高到 的幂次来计算平方根)。
Lab 2 图像处理
介绍
在本实验中,我们将继续基于上周实验的工作,扩展我们的小型图像处理库,以包括对彩色图像的支持,以及一些额外有趣的滤波器和功能。
在实验结束时,您将有机会实现一个或多个您选择的额外功能。
表示颜色
虽然我们可以选择多种方式来表示彩色图像,但我们将使用一种经过验证的表示方法,即 RGB 颜色模型,这在许多常见的图像格式中使用。在这种表示方法中,我们不再用单个整数来表示每个像素的颜色,而是用一个包含三个整数的元组来表示,分别代表像素中的红色、绿色和蓝色。通过组合红色、绿色和蓝色,我们可以表示广泛的颜色。
在本实验中,我们将用 Python 字典来表示图像,该字典具有三个键:
width: 图像的宽度(以像素为单位),height: 图像的高度(以像素为单位),pixels: 一个包含像素值的 Python 列表,每个像素值表示为一个包含三个整数的元组(r, g, b),其中r、g和b的取值范围均为 0 到 255。这些值按行优先顺序存储(即从左到右列出顶行,然后是下一行,依此类推)。
例如,考虑这个 3 行 2 列的图像,为了清楚起见,这里放大了:

i = {
    "height": 3,
    "width": 2,
    "pixels": [(255, 0, 0), (39, 143, 230),
               (255, 191, 0), (0, 200, 0),
               (100, 100, 100), (179, 0, 199)],
}
您还应该将上周实验中工作的函数复制过来,因为我们将在这里直接构建基于实验 1 的滤波器
对彩色图像的滤波
在上周的实验中,我们使用 Python 函数对象来表示滤波器:我们将滤波器表示为一个函数,该函数将图像作为输入并生成相关图像作为输出。本周我们将继续使用这种表示方法:彩色图像的滤波器是一个 Python 函数,它将彩色图像作为输入并生成相关彩色图像作为输出。
虽然我们可以对彩色图像做很多事情,但事实证明,我们可以通过将彩色图像分解为三个独立的灰度图像(分别代表红色、绿色和蓝色通道),将上周的“灰度”滤波器分别应用于每个灰度图像,然后将结果重新组合成彩色图像,从而实现许多滤波器的彩色版本。
例如,我们可以通过以下方式实现我们反转滤波器的彩色版本:

我们可以类似地处理模糊或锐化:将图像分解为三个颜色分量,应用滤波器,然后将它们重新组合。
考虑到这种通用结构,从灰度滤波器创建这些类型的彩色图像滤波器的通用方法将很有用。因此,您的本周实验的第一个任务是在 lab.py 中实现 color_filter_from_greyscale_filter 函数。该函数应该将表示灰度滤波器的 Python 函数作为输入(即一个将灰度图像作为输入并生成灰度图像作为输出的函数)。它的返回值应该是一个新的函数,表示一个彩色图像滤波器(即一个将彩色图像作为输入并生成彩色图像作为输出的函数)。
这个新的滤波器应该遵循上面的模式:它应该将给定的彩色图像分解为三个分量,将灰度滤波器应用于每个分量,然后将它们重新组合成一个新的彩色图像。
下面是其使用示例:
# 如果我们有一个名为 inverted 的灰度滤波器,它反转灰度图像...
inverted_grey_frog = inverted(load_greyscale_image('grey_frog.png'))

# 然后以下将创建该滤波器的彩色版本
color_inverted = color_filter_from_greyscale_filter(inverted)

# 然后可以将其应用于彩色图像以反转它们(注意,这应该生成一个新的彩色图像,而不是改变其输入)
inverted_color_frog = color_inverted(load_color_image('color_frog.png'))
在 lab.py 中实现 color_filter_from_greyscale_filter 函数。您可能会发现定义辅助函数来将彩色图像分解为三个独立的灰度图像(每个代表一个颜色分量)和将三个灰度图像重新组合成一个新的彩色图像很有帮助。
其他滤波器
这个任务涉及将图像处理函数调整为符合特定函数签名的形式,并实现更高级的操作,如滤镜级联和接缝裁剪。以下是逐步完成任务的方法:
1. 实现 make_blur_filter 和 make_sharpen_filter
这些函数应该返回一个滤镜函数,该函数可以作为参数传递给 color_filter_from_greyscale_filter。目的是使它们兼容期望的单参数滤镜形式。
以下是如何实现 make_blur_filter 和 make_sharpen_filter:
def make_blur_filter(kernel_size):
    def blur_filter(image):
        return blurred(image, kernel_size)
    return blur_filter

def make_sharpen_filter(kernel_size):
    def sharpen_filter(image):
        return sharpened(image, kernel_size)
    return sharpen_filter
这些函数围绕 kernel_size 参数创建一个闭包,返回一个只接受图像作为参数的滤镜函数。
2. 使用 color_filter_from_greyscale_filter
现在你可以使用这些函数与 color_filter_from_greyscale_filter 结合使用:
# 使用示例:
blur_filter = make_blur_filter(9)
blurry_image = color_filter_from_greyscale_filter(blur_filter)(load_greyscale_image('python.png'))

sharpen_filter = make_sharpen_filter(7)
sharpened_image = color_filter_from_greyscale_filter(sharpen_filter)(load_greyscale_image('sparrowchick.png'))
3. 实现 filter_cascade
filter_cascade 函数应接受一个滤镜列表并返回一个函数,该函数依次应用这些滤镜
def filter_cascade(filters):
    def cascaded_filter(image):
        for filter_func in filters:
            image = filter_func(image)
        return image
    return cascaded_filter
4. 测试 filter_cascade
你可以通过应用多个滤镜来测试级联功能:
filter1 = color_filter_from_greyscale_filter(edges)
filter2 = color_filter_from_greyscale_filter(make_blur_filter(5))
cascaded_filter = filter_cascade([filter1, filter1, filter2, filter1])

filtered_image = cascaded_filter(load_greyscale_image('frog.png'))
5. 实现接缝裁剪
接缝裁剪是一个复杂的过程,因此将其分解为多个辅助函数是个不错的方法。以下是每个辅助函数的简要说明:
greyscale_image_from_color_image(image):使用给定的公式将彩色图像转换为灰度图像。compute_energy(grey):使用 Sobel 算子(edges 函数)从灰度图像中计算能量图。cumulative_energy_map(energy):计算累积能量图,该图跟踪到达每个像素所需的最小能量。minimum_energy_seam(cem):找到具有最低能量的接缝(从图像顶部到底部的路径)。image_without_seam(image, seam):从图像中删除识别出的接缝。
这些函数将协同工作以执行接缝裁剪。
6. greyscale_image_from_color_image 的示例实现
以下是第一个辅助函数的示例:
def greyscale_image_from_color_image(image):
    def rgb_to_grey(r, g, b):
        return 0.299 * r + 0.587 * g + 0.114 * b

    grey_pixels = [
        rgb_to_grey(image['pixels'][i], image['pixels'][i + 1], image['pixels'][i + 2])
        for i in range(0, len(image['pixels']), 3)
    ]

    return {
        'height': image['height'],
        'width': image['width'],
        'pixels': grey_pixels
    }