
COURSE · 6.5080
6.5080/6.836 Multicore Programming
锁(Locking):学习如何在并发编程中使用锁来管理多个线程或进程对共享资源的访问。 可扩展性(Scalability):理解如何设计和实现可以在多核环境中高效运行的程序。 并发数据结构(Concurrent Data Structures):学习如何设计和使用能够安全地在多个线程间共享的数据结构…
- DOMAIN
- 编程与软件工程
- STATUS
- complete
- COURSE ID
- 6.5080
- RELATIONS
- 暂无结构化数据
LECTURE NOTES · 0
来自目录与 frontmatter课程资料与说明
来自课程 index.md6.5080/6.836 Multicore Programming
Prereq: 6.1210 Introduces principles and core techniques for programming multicore machines. Topics include locking, scalability, concurrent data structures, multiprocessor scheduling, load balancing, and state-of-the-art synchronization techniques, such as transactional memory. Includes sequence of programming assignments on a large multicore machine, culminating with the design of a highly concurrent application. Students taking graduate version complete additional assignments.
N. Shavit
Lec1 总览
主题包括:
- 锁(Locking):学习如何在并发编程中使用锁来管理多个线程或进程对共享资源的访问。
- 可扩展性(Scalability):理解如何设计和实现可以在多核环境中高效运行的程序。
- 并发数据结构(Concurrent Data Structures):学习如何设计和使用能够安全地在多个线程间共享的数据结构。
- 多处理器调度(Multiprocessor Scheduling):了解如何在多核系统中高效地安排任务执行。
- 负载均衡(Load Balancing):研究如何分配计算任务以优化资源利用率。
- 先进的同步技术(State-of-the-art Synchronization Techniques),例如事务内存(Transactional Memory):学习最新的同步方法,以提高程序的并发性和性能
首先我们会介绍经典互斥问题(Lec2),包括诸如公平性和死锁等基本概念;讨论了并发程序正确性的概念(Lec3),探讨了几种不同的条件以及何时使用每种条件;然后,对并发计算中共享内存的属性进行了探讨(Lec4),以及实现高度并发数据结构所需的同步原语(Lec5/Lec6)
每章都有一个次要主题,展示了特定的编程模式或算法技术。例如,第 7 章涵盖了自旋锁和竞争(Lec7),并介绍了底层架构的重要性:理解自旋锁性能需要理解多处理器内存层次结构。第 8 章涵盖了监视器锁(也称管程锁)和等待(Lec8),这是一种常见的同步习语。几章涵盖了并发数据结构。例如,第 9 章涵盖了链表(Lec9),展示了不同类型的同步模式,从粗粒度锁定到细粒度锁定再到无锁结构。这一章应该在其他章节之前阅读,因为其他章节依赖于它。另外,先进先出(FIFO)队列展示了在使用原子同步原语时可能出现的“ABA 问题”(Lec10);栈展示了一个重要的同步模式,称为消除 elimination(Lec11);哈希映射展示了算法如何利用自然并行性(Lec13);跳跃表展示了高效的并行搜索(Lec14);优先队列展示了有时可以放宽正确性保证以增强性能的方法(Lec15)。
第 12 章描述了计数和排序,这两个经典问题具有细微的并发解决方案。将程序分解为可并行执行的任务并组织其执行是并发编程的基本技能,我们考虑了几种方法来做到这一点,包括工作窃取和分配(Lec16)、数据并行性(Lec17)、屏障(Lec18)和事务性编程(Lec20)。内存管理是并发程序的另一个基本挑战,我们讨论了如何在 Lec19 中手动回收内存
并行化应用程序的设计涉及到两种类型的部分:一部分可以轻松地确定为可并行执行,因为它们不需要任何形式的协调或通信;另一部分需要访问共享数据以及在处理器之间进行通信和协作,这部分很难被并行化。先从理想化的数学模型开始,逐层细化到考虑工程设计原理实际模型。一旦大体上掌握这些算法的一般分析方法,可以转向更加实际的情形,针对不同体系的多处理器系统,设计开发不同的算法和数据结构。
Lec 2 Mutual exclusion
Lec 2 Locking
互斥锁性质
-
Mutual Exclusion
At most one thread holds the lock (has completed lock() and not completed unlock()) at any time
-
Freedom from Deadlock
If a thread calls lock() or unlock() and never returns, then other threads must complete invocations(祈求) of lock() and unlock() infinitely often
-
Freedom from Starvation
Every call to lock() or unlock() eventually returns
如果无法获得锁,该怎么做?
- 继续尝试
- Spin(内旋) 或者 busy-wait(sleep 等到 os 通知)
- 适合时延短
- 放弃该处理器
- 适合时延长
- 在单处理器上表现好
我们想要优化什么?
-
Bus bandwidth used by spinning threads
如果有太多的线程在自旋等待锁的释放,它们会频繁地访问总线以检查锁的状态,从而占用了大量的总线带宽。通过优化自旋锁的设计,可以降低这种对总线的竞争,减少总线带宽的使用。
-
Release/Acquire latency
当一个线程释放锁时,其他等待获取锁的线程需要尽快地感知到锁的释放,并且能够尽快地获取到锁,以避免长时间的等待
-
Acquire latency for idle lock
即使在没有其他线程持有锁的情况下,获取锁的操作也可能存在一定的延迟。这种延迟可能来自于锁的内部机制或者是系统的调度等因素
在没有死锁情况下,如果一个线程调用了 lock() 或 unlock() 方法却永远不返回,那么其他线程必须无限次地完成对 lock() 和 unlock() 方法的调用。换句话说,如果一个线程永远不返回,它就不会持有锁,因此其他线程就可以继续获得和释放锁。这样可以确保在没有死锁的情况下,所有线程最终都能完成对锁的获取和释放操作
复习一下 Test-and-Set
public class AtomicBoolean {
  boolean value;
  public synchronized boolean
    getAndSete(boolean newVal) {
    boolean prior = value;
    val = newVal;
    return prior;
  }
}
// Swap old and new value.

AtomocBoolean lock = new AtomicBoolean(false);
...
boolean prior = lock.getAndSet(true)

// both "Swap" and "TAS" available in hardware- 加锁
- 锁被释放:value 为 false
- 锁被持有:value 为 true
- 通过调用 TAS 获取锁
- 如果结果是 false,则 you win
- 如果结果是 true,则 you lose
- 通过写入 false 来释放锁
有几个问题需要考虑
-
TAS invalidates cache lines:TAS 操作会修改锁的状态,这可能会导致锁所在的缓存行失效,该线程就会将请求发送到总线,从而导致总线的负载增加,造成总线的过载,从而影响系统性能,而不是说顺序执行导致性能下降。
-
Spinners
- Miss in cache
- Go to bus
-
释放锁延迟
-
delayed behind spinners
释放锁的线程需要通过总线来完成释放操作,而同时,其他线程可能也在通过总线发送 test-and-set 请求。因此,释放锁的线程必须与这些请求产生者竞争,以获取总线的访问权限,这可能导致总线竞争和性能问题
-
Test-and-Test-and-Set 锁
为了解决上述问题,Larry Rudolph 提出了一个办法——Test-and-Test-and-Set 锁
- 潜伏阶段(Lurking stage):在这个阶段,线程等待直到锁“看起来”空闲。线程会进行自旋等待,但是这种自旋是在本地副本(local cache)上进行的,在锁被占用时不会消耗总线带宽。线程会持续读取本地副本的状态,直到发现有变化,即锁被释放,然后尝试获取锁。
- 突袭阶段(Pouncing state):一旦锁“看起来”可用,线程会立即采取行动。它会再次读取锁的状态,如果读取返回假(表示锁空闲),线程会调用 TAS 来尝试获取锁。
class TTASlock {
  AtomicBoolean state = new AtomicBoolean(false);
  void lock() {
   	while (true) {
     	while (state.get()) {}  // Wait until lock looks free
      if (!state.getAndSet(true))  // then try to acquire it
        return;
   }
}
问题:
- 当锁被释放时,可能会有失效风暴(Invalidation Storm)
- 每个线程都会错过机会:Read satisfied sequentially。如果某个线程发现锁的状态为“空闲”,那么它将尝试获取锁。但是,在这个过程中,其他线程仍在执行“lurking”阶段,等待检查锁的状态)
- 每个线程都执行 TAS 操作:当多个线程同时尝试获取锁时,它们都会执行测试并设置(Test-and-Set)操作,这可能导致其他线程的缓存失效,增加了总线的负载
- 获取锁后的静默时间通常与核心数量成线性关系:一旦某个线程成功获取了锁,其他线程将需要等待一段时间才能重新尝试获取锁,而这段等待时间通常与系统中的核心数量成线性关系
解决方法:引入延迟
当一个线程发现锁“看起来”是空闲的,但实际上无法成功获取锁时,说明有其他线程正在竞争这个锁,而不是真的是空闲的。因此,为了避免再次发生冲突,这个线程选择暂时退避,而不是立即再次尝试获取锁。
动态示例:指数退避。如果我尝试获取锁失败了,那么在重试之前会等待一个随机的持续时间。每次连续的失败会使预期等待时间加倍。
public class Backoff implements lock {
  public void lock() {
  int delay = MIN_DELAY; // Fix minimum delay
  while (true) {
    while (state.get()) {} // Wait until lock looks free
    if (!state.getAndSet(true)) // If we win, return
    	return;
    sleep(random() % delay); // Back off for random duration
    if (delay < MAX_DELAY) // Double max delay, within reason
    	delay = 2 * delay;
}}}
性能
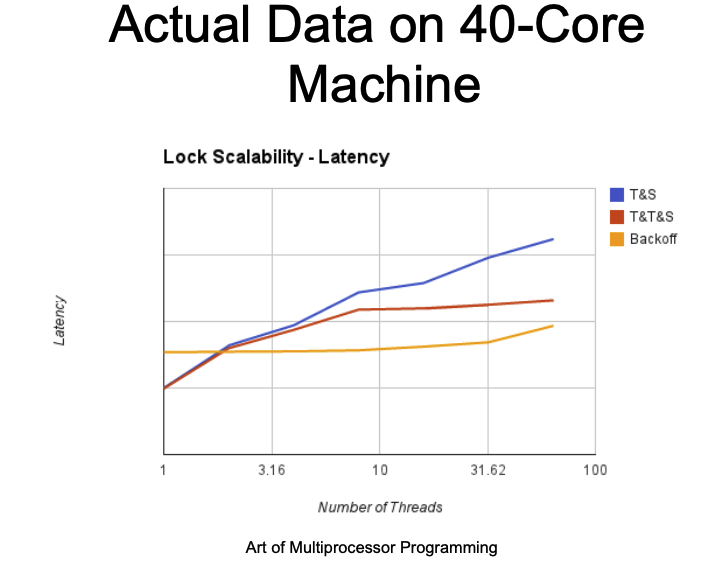
指数退避分析
好处:
- 实现简单
- 胜过 TTAS 锁
坏处:
- 必须谨慎选择参数
- 在不同平台上不具备可移植性
解决方法:
-
避免无用的失效:通过每个线程持有一个队列的方法
-
对于每个线程: 通知队列中下一个线程; 不打扰其他线程
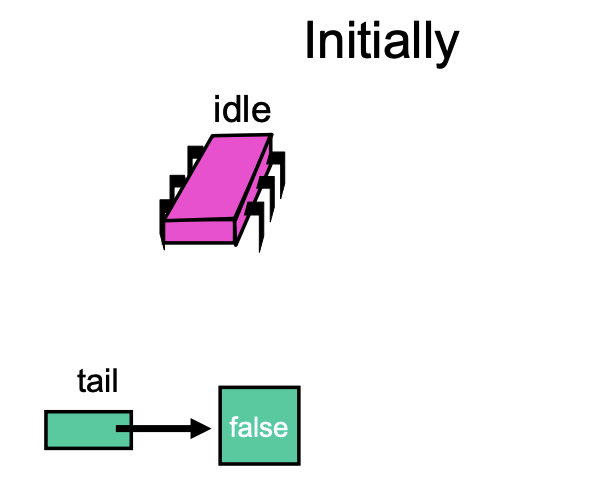
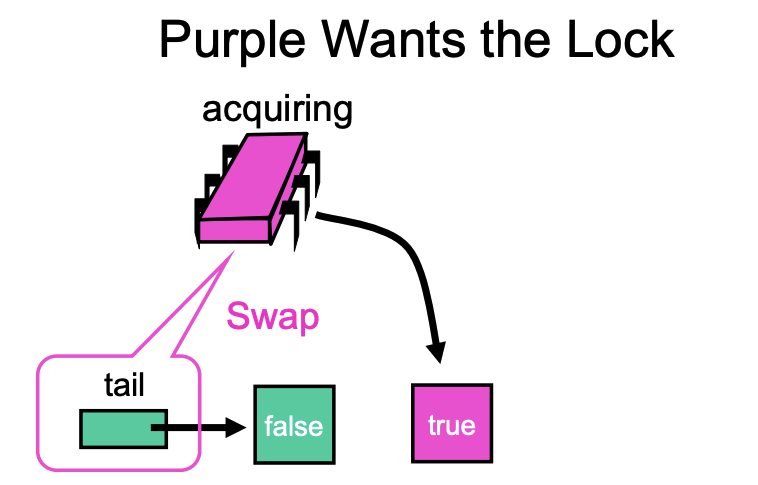
怎么实现呢?CLH Lock
- 先到先服务的顺序
- 每个线程都有一个较小的、固定大小的 acquired 开销
工作原理
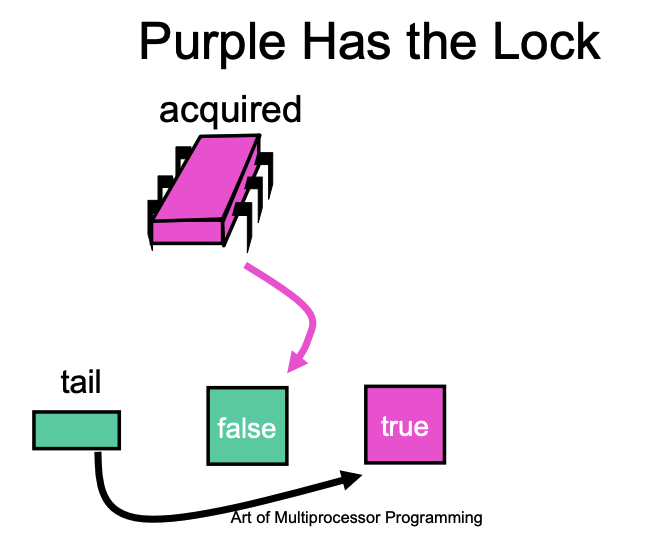
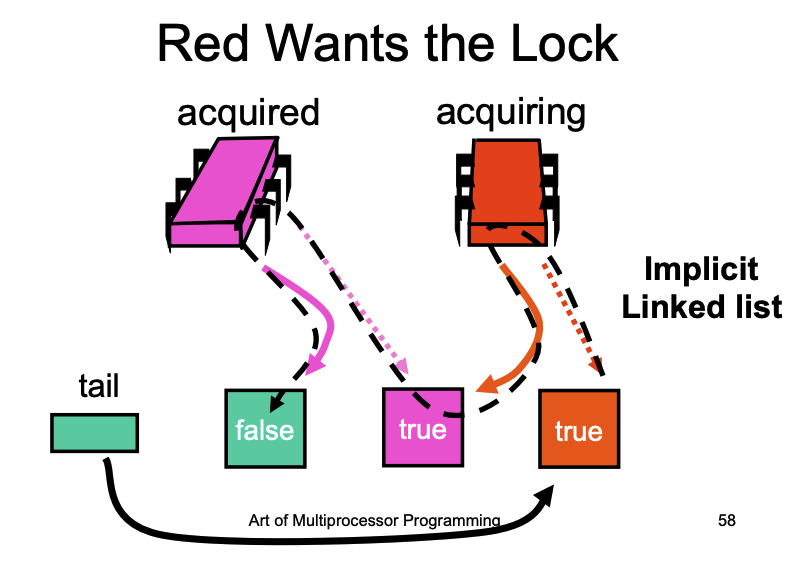
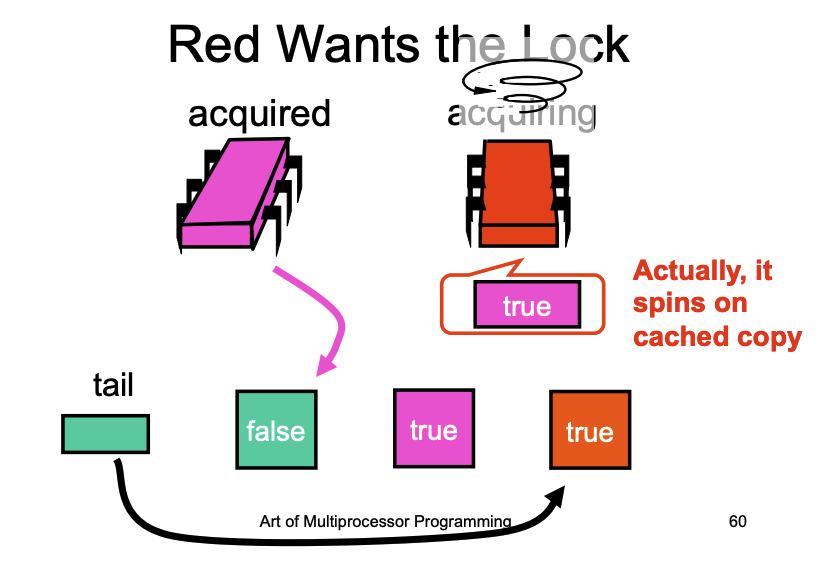
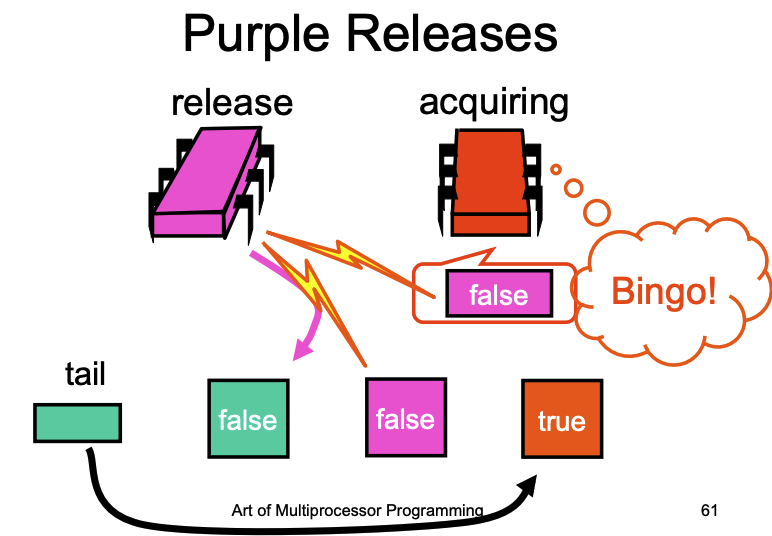
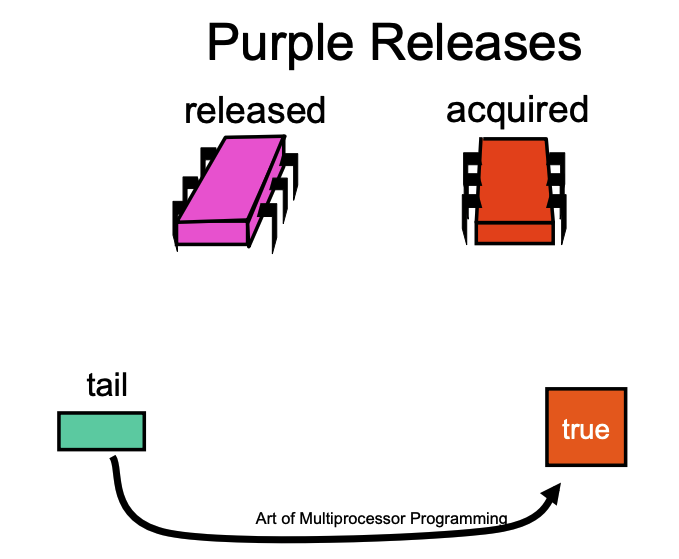
// CLH Queue Lock
class CLHLock implements Lock {
  AtomicReference<Qnode> tail; // Queue tail
  ThreadLocal<Qnode> myNode = new Qnode(); // Thread-local Qnode
  public void lock() {
   Qnode pred = tail.getAndSet(myNode); // Swap in my node
   while (pred.locked) {} // Spin until predecessor release lock

  public void unlock() {
   myNode.locked.set(false); // Notify successor
   myNode = pred; // Recycle predecessor's node(Here we don’t actually reuse myNode. Can see how it’s done in Art of Multiprocessor Programming book)
  }
}}
CLH Lock 分析
- 好处
- 当一个线程释放锁时,它只会通知它的前驱线程。这意味着锁的释放不会导致所有等待线程都被唤醒,从而减少了系统总线的负担和无效的缓存失效
- CLH 锁只需要少量的固定大小的空间来保存每个线程的等待节点信息
- 坏处
- 在无缓存的 NUMA 架构中不起作用,在无缓存的 NUMA 系统中,没有共享的高速缓存,锁的操作需要通过远程内存访问来完成,这会导致显著的性能下降
NUMA 和 cc-NUMA 架构
NUMA(Non-Uniform Memory Architecture)
ccNUMA(cache coherent NUMA) 看起来就是扁平的共享内存,实际上没有 caches(sometime),一些内存区域比其他要快
特点
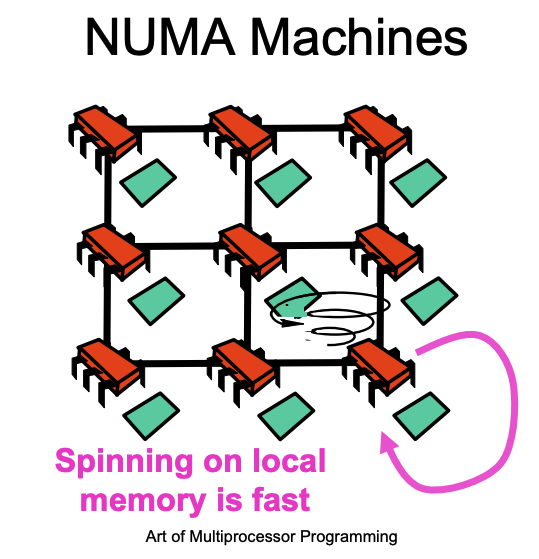
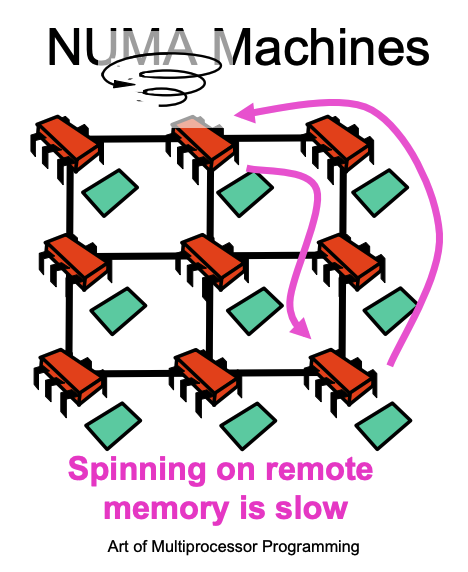
当使用 CLH Lock 时,每个线程需要向前驱节点内存内旋时,速度上差别很大。
解决方法:MCS 锁
- FCFS 的顺序
- 只在本地内存进行内旋(Spin)
- 小而固定的开销
原理
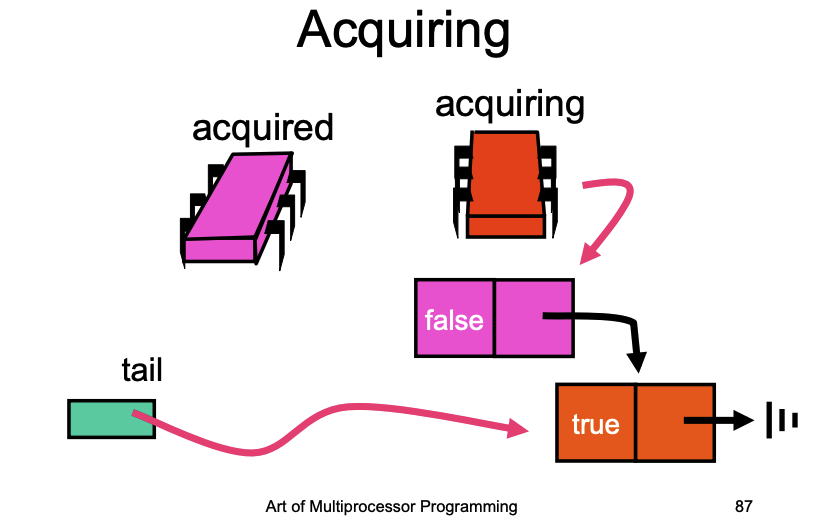
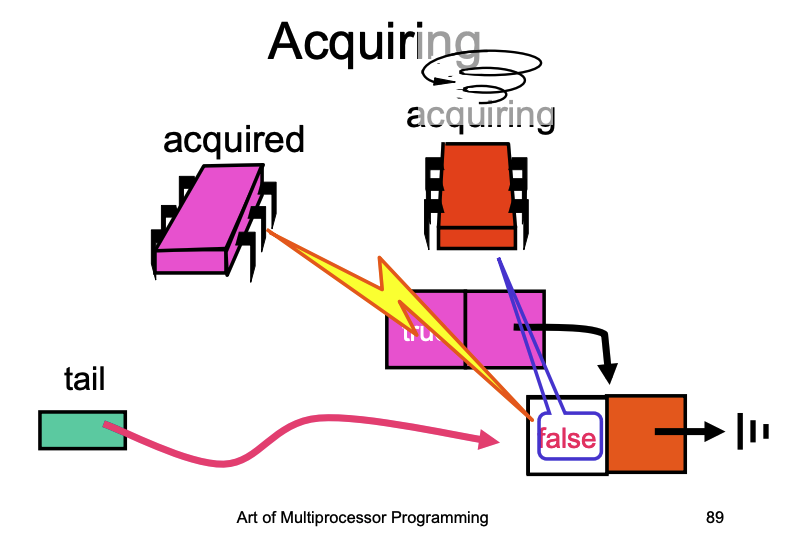
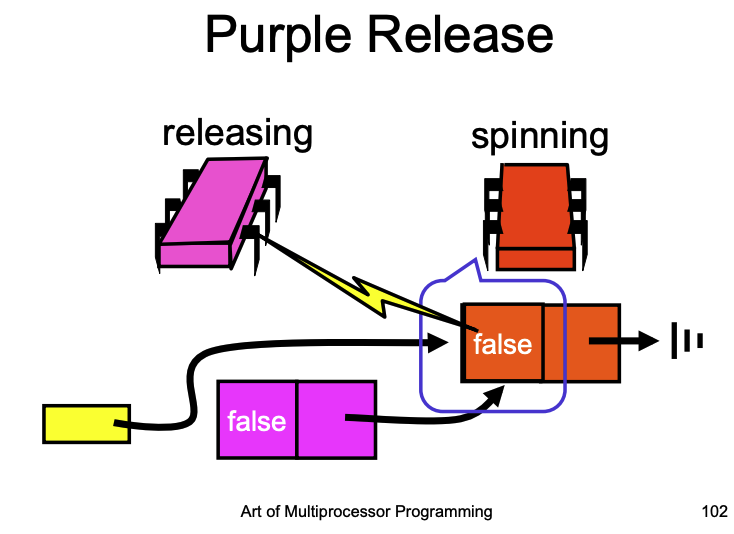
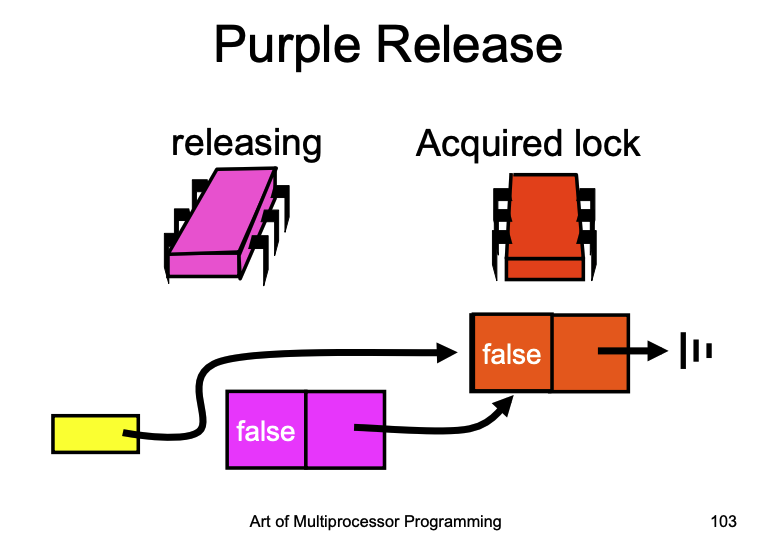
Each node is going to be a flag bit and also a pointer.
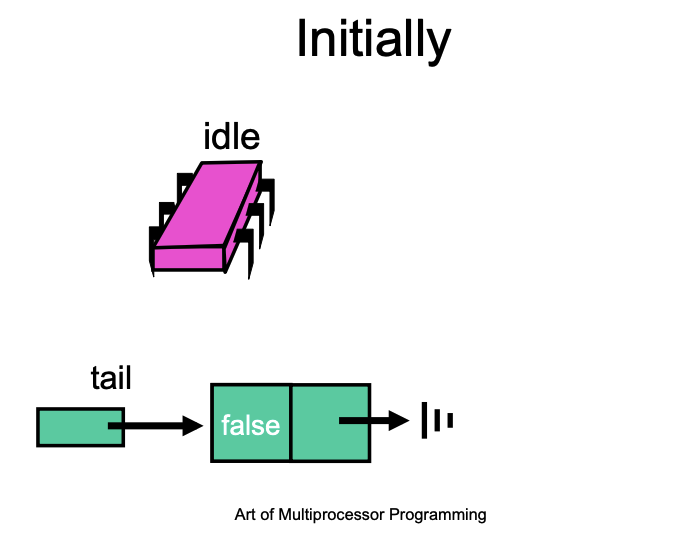
If a thrad wants to acquire the lock it creates a node, put the value true, and do swap 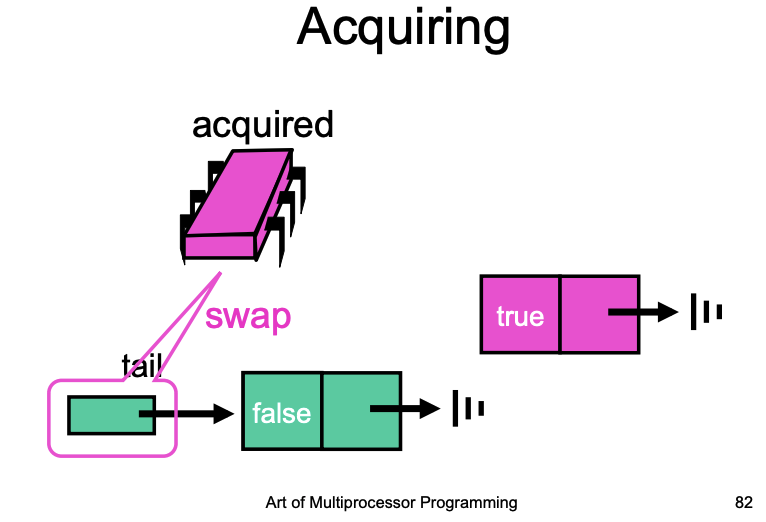
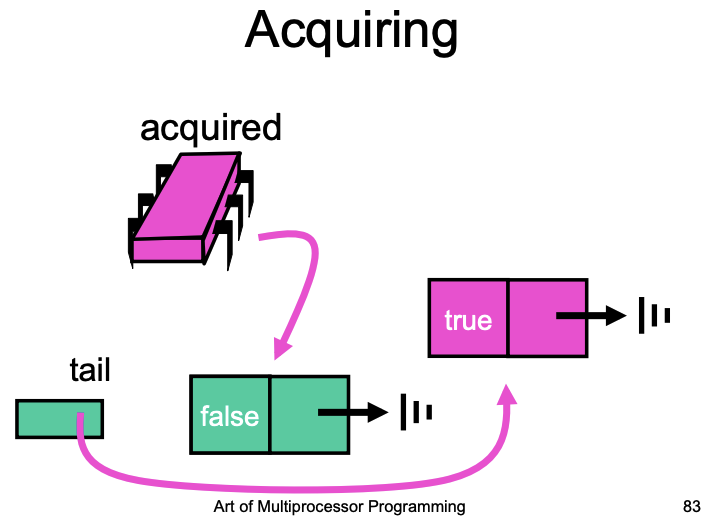
Redirect a pointer from hime to me, so he knows where I am. When he release critical section he'll go and update me so I can spin my memory, that is ,purple will spin on the purple record
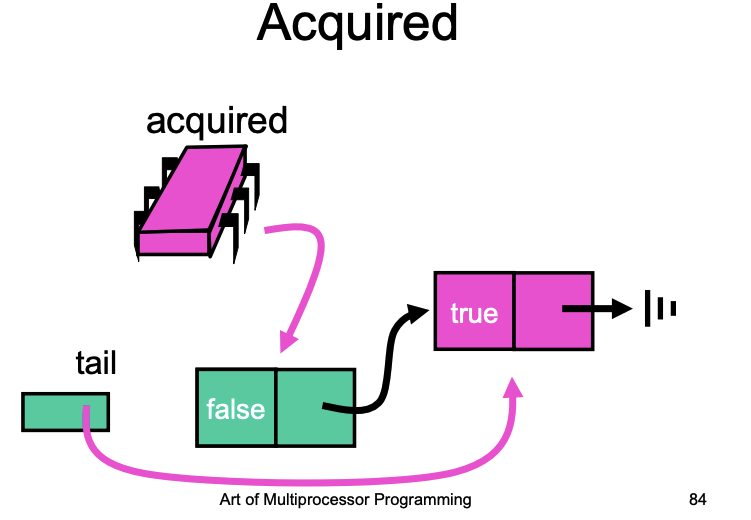
if another red guy comes and does an acquisition he create a record and does a swap and again he looks at this one the tail points to his record
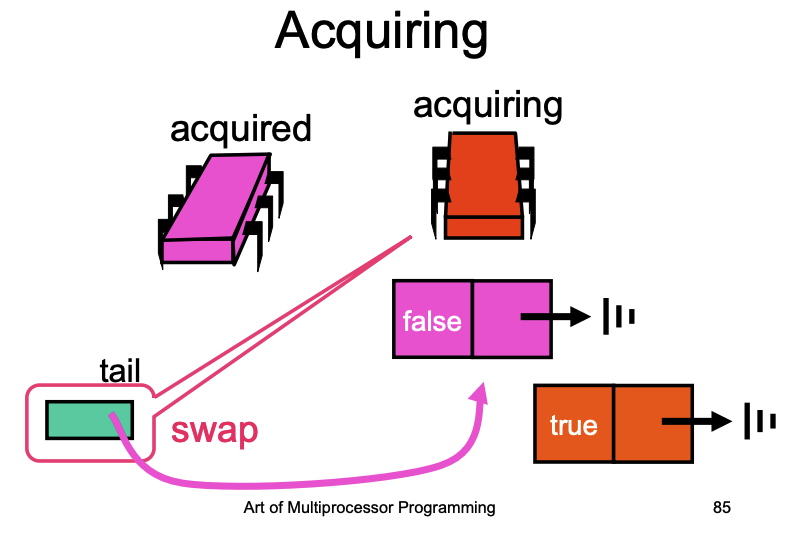
purple will know where do the update for orange
class Qnode {
  volatile boolean locked = false;
  volatile qnode next = null;
}

class MCSLock implements Lock {
  AtomicReference tail;
  public void lock() {
   Qnode qnode = new Qnode(); // make a Qnode
   Qnode pred = tail.getAndSet(qnode); // add my node to the tail of queue
   if (pred != null) { //Fix if queue was non-empty(there was somebody before me)
     qnode.locked = true;
     pred.next = qnode;
     while (qnode.locked) {} // spin on my node, and wait until unlocked
}}}
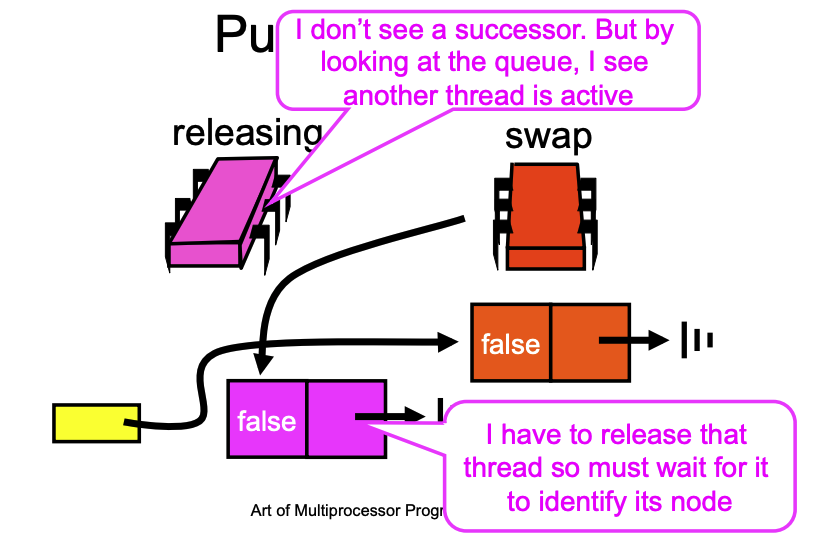
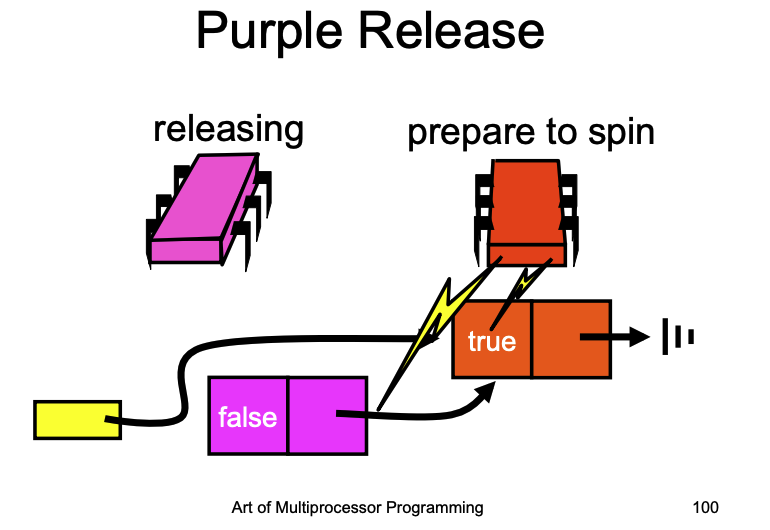
By actually looking at the tail pointer, if the tail pointer is pointing to me then there's nobody there if the tail pointer is pointed to somebody else ,then I know that I have to go release somebody. Who do I have to release? How do I find out who it is that I have to release? I have no way of knowing. I have to wait for them
// MCS Queue Unlock
class MCSLock implements Lock {
  AtomicReference tail;
  public void unlock() {
   if (qnode.next == null) { // Missing successor(nobody update me, there's somebody to release, I have to check to be sure there's nobody to release)
     if (tail.CAS(qnode, null) // If really no successor, return
     return;
     while (qnode.next == null) {} // otherwise wait for successor to catch up
   }
  qnode.next.locked = false; // Pass lock to successor
}}
可中断锁
- 如果我想要放弃等待锁的释放呢?
- 比如:超时时间/数据库事务被用户打断
解决方法: Back-off Lock
- Aborting is trivial 打断并不重要: 仅仅从 lock()即可
- 额外的好处:
- No cleanning up
- Wait-free
- Immediate return
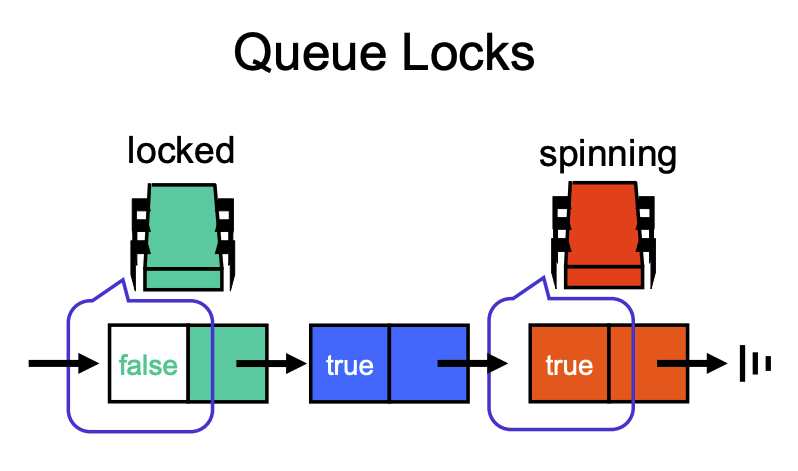
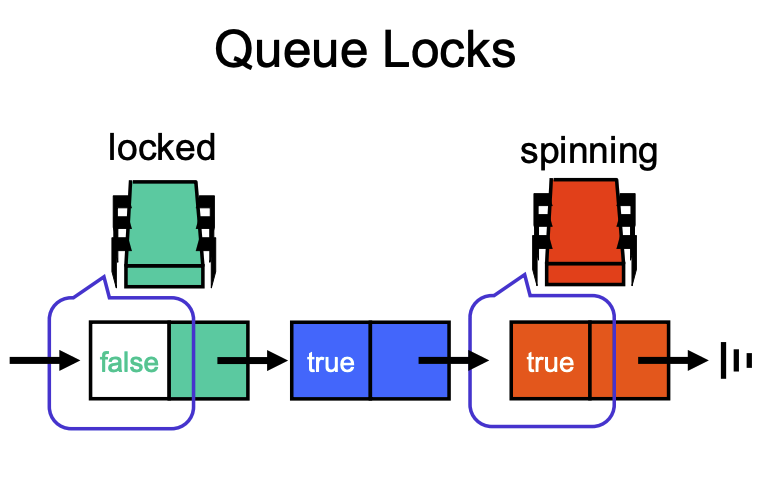
Queue Locks
- Can't just quit: Thread in line hehind will starve
- Need a gracefule way out
Lec 10 Transactional Programming 事务编程
概念
软事务内存
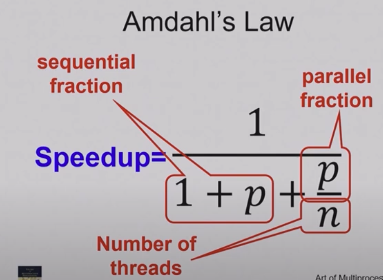
Amdahl's Law 可以表达为:
Speedup(加速度) = 1-thread exec time / n-thread exec time
以及
举个例子。假如你买了 10-core 的机器,你的应用程序有 60%是可并发的,40%是顺序的,则加速是多少?
speedup = 1/(1-.6-.6/10) = 2.17
细粒度锁(fine-grained)
粗粒度锁(coarse-grained): Easily made correct .. but not scalable
动机
当前并发编程中使用锁的的一些困难
-
锁不够健壮(Robustness)
这里的“健壮”是指系统在面对异常或错误情况下依然能继续运行的能力。锁的不健壮性体现在如果一个线程持有一个锁但没有及时释放(例如线程挂起或死锁),其他线程将被阻塞,无法继续执行
Locking Relies on Conventions: Relation between the lock data and the object being locked exists only in the mind of the programmer
- 锁在编程中无法组合(Not Composable)
- 方法不能提供内部同步:方法内部无法自行管理并发控制,这意味着它们无法保证自身操作的线程安全性,必须依赖外部调用方进行同步控制
- 对象必须向客户端暴露锁的协议:对象不能自己管理并发控制,必须将锁定机制公开给使用它们的客户端。这意味着客户端需要知道何时、如何对对象进行加锁和解锁。
- 客户端必须设计并遵循协议,以避免死锁、资源竞争等并发问题
- 抽象被打破了! 由于上述原因,对象的抽象层被打破。原本对象应该隐藏内部实现细节,只暴露必要的接口供客户端使用。但因为并发控制的问题,锁的机制不得不暴露出来
- Simple Problem are hard
- Monitor Wait and Signal: Wait and Signal do not compose
The Transactional Manifesto: 许多现代编程实践并不适用于多核世界。它提出了一项议程,即用事务性 API 取代锁定,并设计语言和库来实现高效的运行时环境。这表明了对于解决多核处理器带来的并发编程挑战,事务性编程被认为是一种更为有效的方法,并且需要对编程语言和相关库进行适应性的改进